
CQRS
Schreiben und Lesen über getrennte Modelle
Die Idee und ihr Nutzen
In der Schadenanwendung einer Versicherung gibt die Sachbearbeiterin Frau Berg Schäden zur Zahlung frei, und die Anwendung prüft dabei genaue Regeln, etwa ob der Vertrag den Schaden deckt. Dieselbe Anwendung zeigt Frau Berg auch die Übersicht „Meine offenen Schäden“, die viele Male am Tag aufgerufen wird und schnell erscheinen soll. Die Anwendung trennt deshalb die beiden Aufgaben. Ein Programmteil, das Schreibmodell, nimmt Änderungen wie die Freigabe eines Schadens entgegen und prüft sie. Ein anderer Programmteil, das Lesemodell, hält für die Übersicht eine fertige Tabelle bereit, in der jede Zeile schon alle angezeigten Angaben eines Schadens enthält, hier in einer eigenen Lesedatenbank. Diese Trennung heißt Command Query Responsibility Segregation, kurz CQRS, auf Deutsch getrennte Zuständigkeit für Befehle und Abfragen.

Wie funktioniert es?
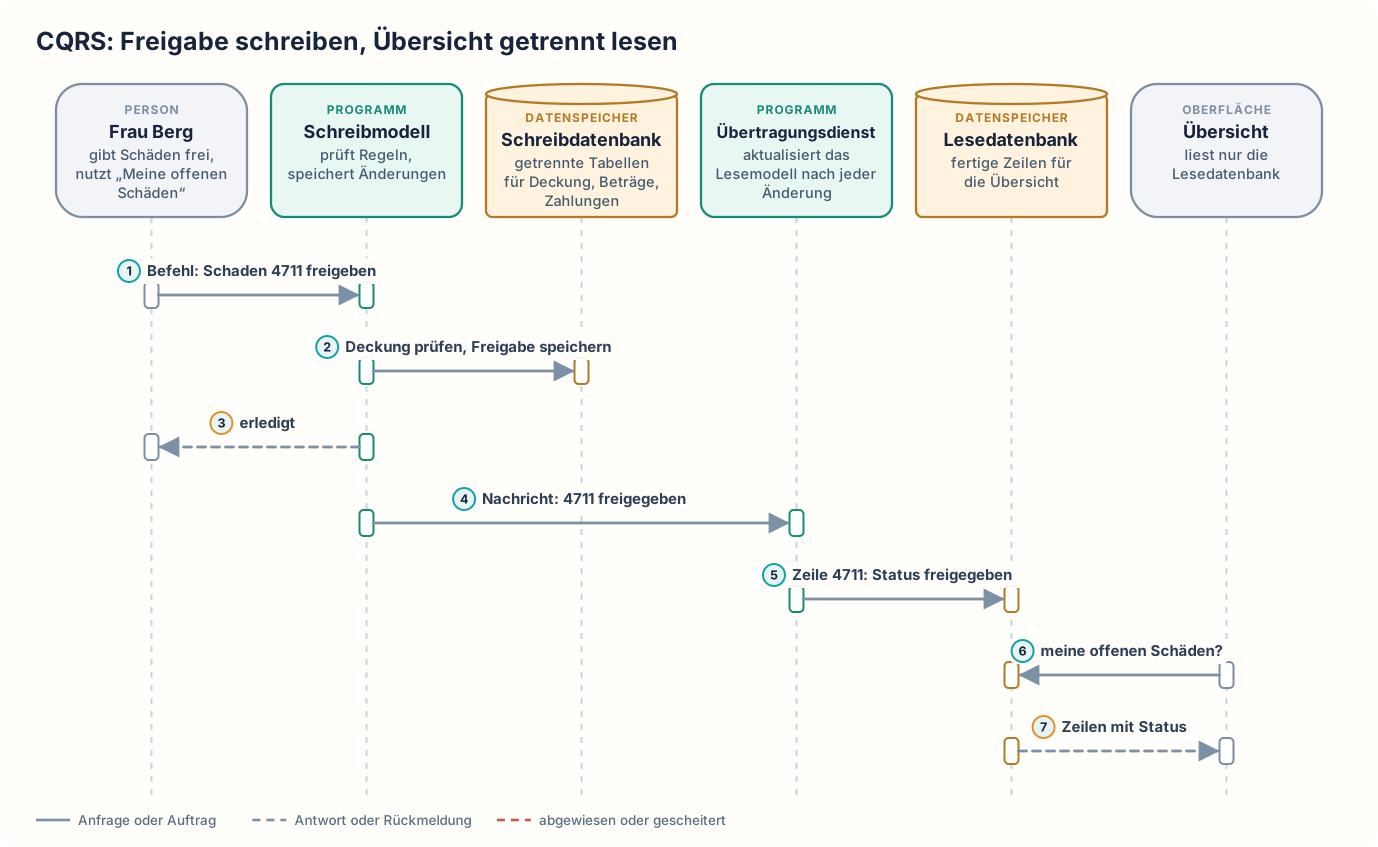
Frau Berg gibt Schaden 4711 frei, und der Befehl „Schaden 4711 freigeben“ geht an das Schreibmodell. Das Schreibmodell prüft die Deckung, speichert den Status „freigegeben“ in der Schreibdatenbank und antwortet Frau Berg nur mit „erledigt“. Die Anwendung zeigt daraufhin den Hinweis „Freigabe gespeichert“. Danach schickt das Schreibmodell die Nachricht „4711 freigegeben“ an den Übertragungsdienst, ein eigenes Programm, das von jeder Änderung erfährt und die passende Zeile in der Lesedatenbank aktualisiert. Der Übertragungsdienst setzt in der Lesedatenbank den Status von Schaden 4711 auf „freigegeben“. Die Übersicht „Meine offenen Schäden“ liest nur die Lesedatenbank und erhält dort fertige Zeilen, ohne Tabellen zu verknüpfen. Weil die Übertragung erst nach dem Speichern geschieht, kann die Übersicht unmittelbar nach dem Klick kurz noch „in Prüfung“ zeigen und wenige Augenblicke später „freigegeben“. Der Hinweis „Freigabe gespeichert“ soll verhindern, dass Frau Berg den Schaden deshalb irrtümlich ein zweites Mal freigibt.
Ein Befehl verlangt eine Änderung, etwa „Schaden 4711 freigeben“. Befehle gehen an das Schreibmodell, einen Programmteil mit eigenen Tabellen, der alle Regeln prüft und eine erlaubte Änderung speichert. Die Antwort auf einen Befehl lautet nur „erledigt“ oder „abgelehnt“. Legt ein Befehl einen neuen Schaden an, enthält die Antwort zusätzlich die neue Schadennummer. Daten für Übersichten liefert das Schreibmodell nicht. In der Schreibdatenbank liegen die Schäden in getrennten Tabellen für Deckungsprüfung, zurückgelegte Beträge, Zahlungen und Status. Das Schreibmodell braucht diese Aufteilung, um zu prüfen, ob eine Freigabe erlaubt ist, und damit jede Angabe nur in einer Tabelle steht und sich keine zwei Tabellen widersprechen. Eine Abfrage fordert Daten an, etwa „alle offenen Schäden von Frau Berg, sortiert nach Eingang“. Abfragen gehen an das Lesemodell, einen Programmteil mit einem eigenen Datenbestand, der genau für diese Abfrage aufbereitet ist. Oft ist das eine einzige Tabelle, in der jede Zeile schon alle angezeigten Angaben enthält. Für „Meine offenen Schäden“ enthält die Lesedatenbank eine Tabelle mit Sachbearbeiterin, Schadennummer, Kunde, Betrag, Status und Eingangsdatum.
CQRS verlangt nur getrennte Programmteile für Befehle und Abfragen. Beide Programmteile können dieselbe Datenbank verwenden. Die Versicherung geht einen Schritt weiter: Schreibmodell und Lesemodell nutzen zwei getrennte Datenbanken, die Schreibdatenbank und die Lesedatenbank. Den Übertragungsdienst braucht die Versicherung nur wegen dieser zweiten Datenbank.
Fällt der Übertragungsdienst aus, ist die Freigabe in der Schreibdatenbank trotzdem gespeichert. Nur die Lesedatenbank hängt immer weiter hinterher, bis der Übertragungsdienst die fehlenden Änderungen nachholt. Damit keine Änderung unterwegs verloren geht, braucht die Übertragung ein zuverlässiges Verfahren, etwa das Outbox Pattern. Dabei schreibt das Schreibmodell die Nachricht „4711 freigegeben“ zusammen mit der Freigabe in die Schreibdatenbank und verschickt sie erst von dort. So geht die Nachricht nicht verloren, wenn das Versenden fehlschlägt. Kommt eine Nachricht versehentlich zweimal an, darf der Übertragungsdienst zum Beispiel für denselben neuen Schaden keine zweite Zeile in der Lesedatenbank anlegen.
CQRS: Freigabe schreiben, Übersicht getrennt lesen
Wann ist es sinnvoll und wann nicht?
CQRS lohnt sich
- Lesen und Schreiben kommen sehr unterschiedlich häufig vor. In der Schadenanwendung werden täglich rund 5.000 Schäden geändert, die Übersichten aber zigtausendmal aufgerufen. Ohne CQRS muss die Datenbank der Schadenanwendung bei jedem Aufruf der Übersicht für jeden offenen Schaden mehrere Tabellen verknüpfen, filtern und sortieren. Dieses ständige Zusammensetzen wird zur Hauptlast der Datenbank. Mit CQRS belasten die Aufrufe der Übersichten die Schreibdatenbank nicht mehr.
- Lesen und Schreiben brauchen die Daten in sehr verschiedener Form. Ohne CQRS dienen dieselben Tabellen der Prüfung einer Freigabe und der Übersicht, und jede Änderung für die Übersicht, etwa eine zusätzliche Spalte, betrifft auch die Tabellen, mit denen das Schreibmodell prüft. Mit CQRS enthält das Schreibmodell nur die Regeln und Tabellen für Freigaben, und eine geänderte Übersicht ändert nur die Lesedatenbank.
- Beim Schreiben gelten umfangreiche Regeln, und beim Lesen gibt es viele verschiedene Übersichten. Ohne CQRS lesen alle Übersichten aus den Tabellen, mit denen das Schreibmodell die Regeln prüft, und jede neue Übersicht kann eine Änderung an diesen Tabellen erzwingen. Mit CQRS legt das Team für eine neue Übersicht eine weitere Tabelle in der Lesedatenbank an, ohne die Tabellen für Deckungsprüfung, Beträge und Zahlungen zu ändern.
- Die Anwendung nutzt bereits Event Sourcing. Dabei wird jede Änderung ohnehin als Ereignis gespeichert, und aus diesen Ereignissen lassen sich Lesemodelle aufbauen und bei Bedarf neu erzeugen. Ohne CQRS müsste die Übersicht bei jedem Aufruf alle Ereignisse jedes offenen Schadens lesen und daraus den heutigen Stand berechnen.
CQRS ist nicht das Richtige
- Die Anwendung speichert im Wesentlichen Formulare und zeigt sie unverändert wieder an. Dann liest und schreibt ein einziger Programmteil dieselben Tabellen. Das Team baut und betreibt kein zweites Modell, keine Lesedatenbank und keinen Übertragungsdienst, die die Daten hier nur in derselben Form noch einmal bereithielten.
- Jede Ansicht muss unmittelbar nach einer Änderung den neuesten Stand zeigen, und eine kurze Verzögerung ist nicht hinnehmbar. Dann ist eine getrennte Lesedatenbank nicht das Richtige, denn sie zeigt nach jeder Freigabe kurz den alten Stand, bis der Übertragungsdienst sie aktualisiert hat. Schreibmodell und Lesemodell nutzen stattdessen eine gemeinsame Datenbank, wie es CQRS auch erlaubt. Die Übersicht liest eine Freigabe aus derselben Datenbank, in der das Schreibmodell sie gespeichert hat, und zeigt sie ohne Verzögerung. Einen Übertragungsdienst braucht die Versicherung dafür nicht.
- Nur eine einzelne Übersicht ist zu langsam, und beim Schreiben gelten nur wenige Regeln. Mit CQRS müsste das Team für diese eine Übersicht ein zweites Modell bauen und bei jeder Änderung der Tabellen des Schreibmodells nachführen. Stattdessen legt das Team für diese Übersicht einen Datenbankindex an. Ein Index ist ein Verzeichnis, mit dem die Datenbank der Schadenanwendung passende Zeilen findet, ohne die ganze Tabelle zu durchsuchen. Ebenso genügt oft eine Materialized View. Das ist ein vorberechnetes Abfrageergebnis in der Datenbank der Schadenanwendung und damit ein Lesemodell ohne eigene Datenbank. In beiden Fällen behält die Anwendung ein einziges Modell für Schreiben und Lesen, und das Team betreibt keinen Übertragungsdienst.
Nachteile und typische Fehler
Zwei Modelle bedeuten mehr Code und mehr Datenhaltung. Bei einer getrennten Lesedatenbank muss das Team in der Oberfläche berücksichtigen, dass die Übersicht einen älteren Stand zeigen kann. Der Übertragungsdienst ist ein zusätzliches Programm, das betrieben werden muss. Das Team muss den Rückstand der Lesedatenbank überwachen, fehlende Änderungen nachholen können und die Lesedatenbank notfalls vollständig aus der Schreibdatenbank neu aufbauen können. Wie viel schneller die Übersicht durch CQRS wird und wie lange die Verzögerung typischerweise dauert, hängt von der Last und von der Übertragung ab und muss im Betrieb gemessen werden. Außerdem verschickt das Schreibmodell die Änderungsnachrichten wie „4711 freigegeben“, und der Übertragungsdienst wertet sie aus. Ändert das Schreibmodell das Format dieser Nachrichten, muss auch der Übertragungsdienst angepasst werden.
Typische Fehler und woran man sie erkennt:
- Unbemerkter Rückstand: Der Übertragungsdienst fällt aus, und die Lesedatenbank hängt immer weiter hinterher. Frau Berg sieht freigegebene Schäden weiter als „in Prüfung“. Erkennbar ist das an einem wachsenden Abstand zwischen der letzten Änderung in der Schreibdatenbank und der letzten Aktualisierung in der Lesedatenbank.
- Verlorene Änderung: Das Schreibmodell speichert die Freigabe, die Nachricht an den Übertragungsdienst geht aber verloren, weil Speichern und Versenden nicht zuverlässig verbunden sind. Die Zeile von Schaden 4711 bleibt dauerhaft auf dem alten Status. Erkennbar ist das an Abweichungen, wenn das Team Lesedatenbank und Schreibdatenbank vergleicht.
- Doppelt verarbeitete Nachricht: Frau Berg legt Schaden 4712 neu an, und das Schreibmodell schickt die Nachricht „4712 angelegt“ an den Übertragungsdienst. Der Übertragungsdienst erhält diese Nachricht versehentlich zweimal und legt in der Lesedatenbank jedes Mal eine neue Zeile an. Frau Berg sieht Schaden 4712 dann zweimal in „Meine offenen Schäden“. Erkennbar ist das an Schadennummern, die in der Lesedatenbank mehrfach vorkommen und in der Schreibdatenbank nur einmal.
- Doppelte Freigabe durch Nutzer: Die Oberfläche zeigt nach dem Klick keinen Hinweis, und Frau Berg sieht in der Übersicht noch „in Prüfung“. Frau Berg gibt den Schaden ein zweites Mal frei, und ein zweiter Befehl „Schaden 4711 freigeben“ geht an das Schreibmodell. Prüft das Schreibmodell nicht, ob Schaden 4711 schon freigegeben ist, speichert es die Freigabe ein zweites Mal. Erkennbar ist das an wiederholten Befehlen für denselben Schaden innerhalb weniger Sekunden.
- CQRS überall: CQRS wird für ein ganzes System eingeführt, obwohl nur in wenigen Bereichen Lesen und Schreiben so verschieden sind wie bei der Übersicht „Meine offenen Schäden“. Für jeden Bereich muss das Team dann ein Lesemodell, eine Lesedatenbank und die Übertragung bauen und betreiben. Erkennbar ist das an Lesemodellen, die die Tabellen des Schreibmodells nur eins zu eins abbilden.
Weiterführend
Verwandte Ansätze
- Eventual Consistency: beschreibt, wie ein verzögert aktualisierter Datenbestand später denselben Stand erreicht wie die Quelle.
- Change Data Capture: liest Änderungen aus dem Änderungsprotokoll, das die Schreibdatenbank ohnehin führt, und kann damit die Lesedatenbank nachführen.
Werkzeuge und Umsetzungen
- Axon Framework: Java-Rahmenwerk mit Bausteinen für Befehle, Abfragen, Ereignisse und Lesemodelle.
- Marten: Bibliothek für die Plattform .NET, die die Datenbank PostgreSQL als Speicher für Ereignisse und Lesemodelle nutzt.
- Eventuous: Bibliothek für .NET für Event Sourcing und CQRS.
- Apache Pekko Persistence: speichert Ereignisse in Java- und Scala-Programmen und kann daraus Lesemodelle aufbauen.
Quellen
- Microsoft: CQRS-Muster: beschreibt CQRS mit gemeinsamem und mit getrenntem Datenspeicher sowie die Folgen verzögerter Lesemodelle.
- Martin Fowler: CQRS: erklärt die Trennung in ein Modell zum Ändern und eines zum Lesen und warnt davor, CQRS für ein ganzes System statt für einzelne Bereiche einzusetzen.