
Microservices
Kleine, einzeln auslieferbare Dienste mit eigenen Daten
Die Idee und ihr Nutzen
An der großen Schadenanwendung einer Versicherung arbeiten zehn Teams, und alle liefern ihre Änderungen gemeinsam in einem einzigen Programm aus. Will das Team, das die Schadenmeldung betreut, eine kleine Verbesserung ausliefern, muss es sich mit den anderen neun Teams abstimmen und warten, bis auch deren Änderungen fertig sind. Deshalb teilt die Versicherung die Anwendung in mehrere kleine, eigenständige Programme auf, zum Beispiel einen Schadendienst, einen Vertragsdienst und einen Zahlungsdienst. Jeder dieser Dienste hat eine eigene Datenbank und ein eigenes Team. Die Dienste arbeiten über das Netz zusammen, und jedes Team kann seinen Dienst einzeln ändern und ausliefern. Diese Bauweise heißt Microservices, auf Deutsch etwa kleine Dienste.

Wie funktioniert es?
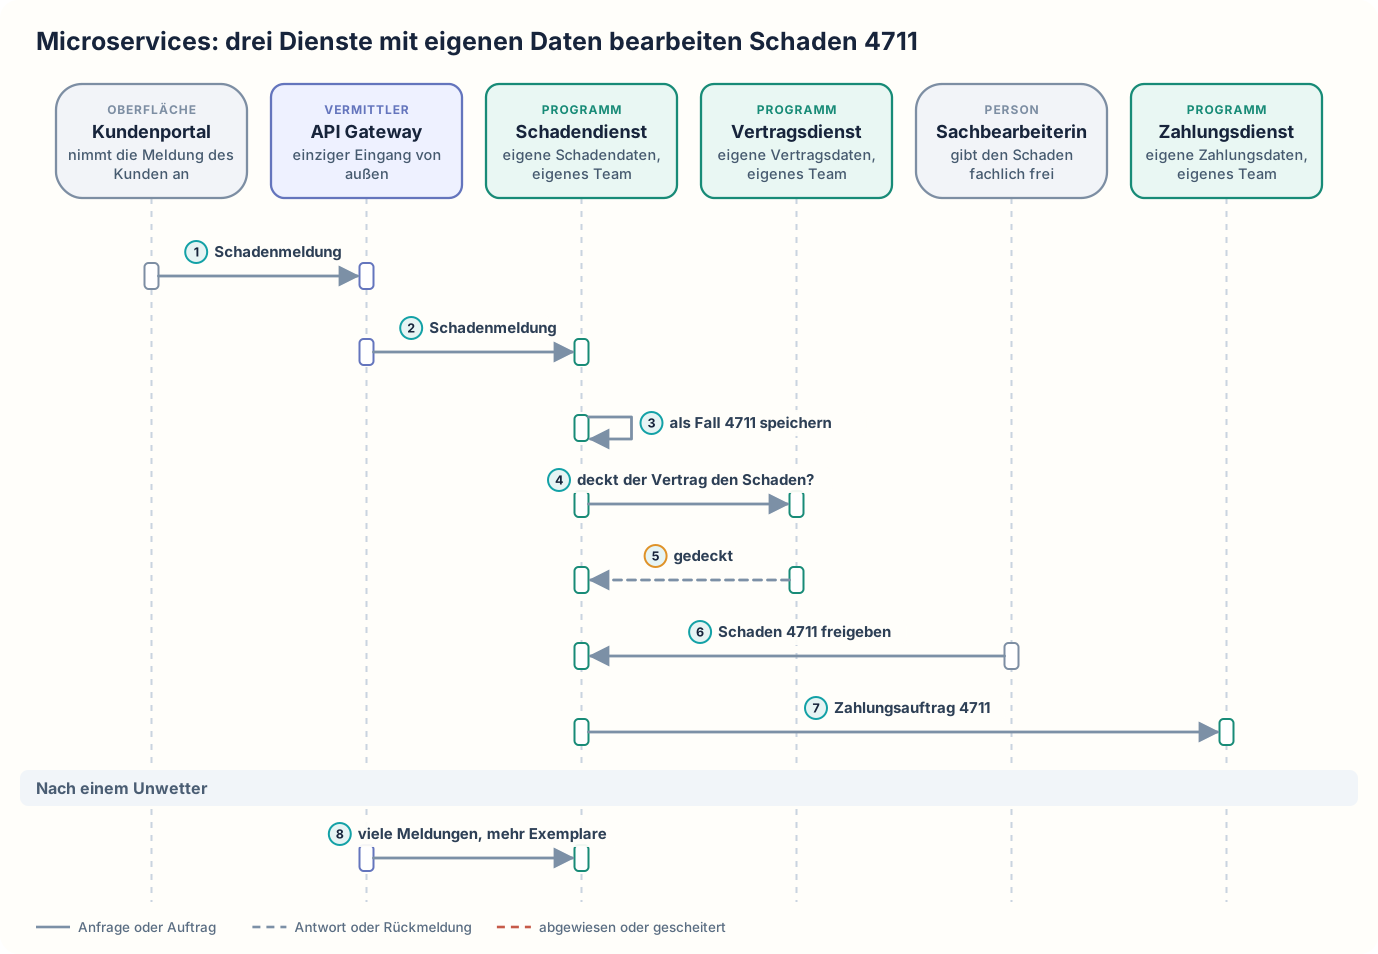
Ein Kunde meldet einen Schaden im Kundenportal, der Webseite der Versicherung für ihre Kunden. Das Kundenportal schickt die Meldung an das API Gateway. Das API Gateway ist der einzige Eingang von außen und leitet jede Anfrage an den richtigen Dienst weiter, hier an den Schadendienst. Der Schadendienst speichert die Meldung als Fall 4711 in seinen eigenen Schadendaten. Dann fragt der Schadendienst den Vertragsdienst über dessen Schnittstelle, ob der Vertrag den Schaden deckt. Der Vertragsdienst liest seine eigenen Vertragsdaten und antwortet „gedeckt“. Eine Sachbearbeiterin gibt Fall 4711 fachlich frei, und der Schadendienst beauftragt den Zahlungsdienst, der den Zahlungsauftrag in seinen Zahlungsdaten speichert. Nach einem Unwetter startet das Team des Schadendienstes zusätzliche Exemplare des Schadendienstes, und das API Gateway verteilt die Meldungen auf alle Exemplare. Das geht, weil alle Exemplare dasselbe Programm sind und ihre Fälle in denselben Schadendaten speichern. Vertragsdienst und Zahlungsdienst laufen unverändert weiter. Voraussetzung ist, dass die Datenbank des Schadendienstes und der Vertragsdienst auch die zusätzlichen Anfragen der weiteren Exemplare schnell genug beantworten.
Jeder Dienst erfüllt eine abgegrenzte fachliche Aufgabe. Der Schadendienst bearbeitet Schäden, der Vertragsdienst prüft Verträge, und der Zahlungsdienst führt Zahlungen aus. Jeder Dienst besitzt seine Daten allein. Andere Dienste greifen nie direkt auf seine Datenbank zu. Sie fragen den Dienst über seine Schnittstelle oder erfahren über Nachrichten von Änderungen. Die Schnittstelle des Vertragsdienstes besteht aus den Aufrufen, die der Vertragsdienst anbietet und deren Form sein Team mit den Teams der aufrufenden Dienste vereinbart hat; der Schadendienst nutzt einen dieser Aufrufe. Jeder Dienst wird unabhängig gebaut, getestet und in Betrieb genommen. Ein Team verantwortet einen oder wenige Dienste, von der Entwicklung bis zum Betrieb.
Damit unabhängig betriebene Dienste verlässlich zusammenarbeiten, braucht es zusätzliche Technik und Regeln:
- Jeder Dienst wird automatisiert ausgeliefert.
- Jeder Dienst wird überwacht.
- Jeder Vorgang lässt sich über alle Dienste hinweg verfolgen, Fall 4711 etwa vom API Gateway über den Schadendienst bis zum Zahlungsdienst.
- Regeln legen fest, was geschieht, wenn ein Dienst nicht antwortet.
Die Aufteilung allein macht die Anwendung weder schneller noch ausfallsicherer. Unabhängig ausliefern können die Teams nur, wenn jede fachliche Regel ganz in einem Dienst steht, etwa die Regel, wann ein Schaden gedeckt ist, nur im Vertragsdienst. Außerdem dürfen sich die vereinbarten Schnittstellen nicht ändern.
Antwortet der Vertragsdienst nicht, markiert der Schadendienst den gespeicherten Fall als „ungeprüft“ und fragt später erneut. Eine fehlende Antwort heißt nicht, dass der Vertrag den Schaden nicht deckt. Ein ungeprüfter Fall darf keine Zahlung auslösen, bis die Deckung geprüft ist. Weil jeder Dienst seine eigene Datenbank hat, gibt es außerdem keine gemeinsame Datenbanktransaktion über Schadendaten und Zahlungsdaten, also keinen Vorgang, der Änderungen in beiden Datenbanken entweder ganz oder gar nicht ausführt. Scheitert der Zahlungsauftrag, ist Fall 4711 im Schadendienst bereits freigegeben. Der Schadendienst muss dann den Zahlungsauftrag wiederholen oder den Fall als „Zahlung offen“ kennzeichnen.
Microservices: drei Dienste mit eigenen Daten bearbeiten Schaden 4711
Wann ist es sinnvoll und wann nicht?
Microservices lohnen sich
- Viele Teams arbeiten gleichzeitig an einem großen System und wollen unabhängig voneinander ausliefern. Das Team des Schadendienstes kann eine Verbesserung an einem beliebigen Tag ausliefern, ohne auf die anderen neun Teams zu warten, solange die vereinbarten Schnittstellen gleich bleiben. In der großen Schadenanwendung liefern alle zehn Teams gemeinsam aus, etwa einmal im Monat. Findet die gemeinsame Prüfung einen Fehler im Code für die Zahlungen, wartet auch das Team, das die Schadenmeldung betreut, mit seiner Verbesserung, bis der Fehler behoben ist.
- Teile der Anwendung werden sehr unterschiedlich belastet. Nach einem Unwetter steigen die Schadenmeldungen sprunghaft, während beim Zahlungsdienst kaum mehr Arbeit anfällt. Ohne die Aufteilung müsste die Versicherung die ganze Schadenanwendung in zusätzlichen Exemplaren starten, auch den Teil für die Zahlungen, der gerade wenig zu tun hat. Voraussetzung ist eine Plattform, auf der sich bei Bedarf weitere Exemplare eines Programms starten lassen.
- Teile der Anwendung brauchen unterschiedliche Technik, etwa eine andere Programmiersprache oder eine andere Art von Datenbank. In einem einzigen Programm müssen alle Teams dieselbe Technik verwenden.
- Ein Team soll den Aufbau seiner Daten ändern können, ohne andere Teams zu stören. Das Team des Vertragsdienstes kann den Aufbau seiner Vertragsdaten ändern, ohne den Schadendienst anzupassen, solange die Schnittstelle des Vertragsdienstes gleich bleibt.
- Die Organisation beherrscht die automatisierte Auslieferung und den Betrieb vieler Dienste. Dann übernimmt jedes Team für seinen Dienst die vorhandene automatisierte Auslieferung und Überwachung, und niemand muss Dienste von Hand ausliefern.
Microservices sind nicht das Richtige
- Nur ein kleines Team arbeitet an der Anwendung, oder das Produkt ist neu, und es ist noch unklar, ob zum Beispiel die Deckungsprüfung zum Schaden oder zum Vertrag gehört. Ein kleines Team muss sich ohnehin mit keinem anderen Team abstimmen, und eine Grenze zwischen Diensten, die sich noch verschiebt, müsste es jedes Mal in den Schnittstellen nachziehen. Dann baut das Team die Schadenanwendung als Modular Monolith, also als ein einzelnes Programm mit getrennten Teilen für Schaden, Vertrag und Zahlung. Aufrufe zwischen den Teilen bleiben Aufrufe innerhalb des Programms, ohne Umweg über das Netz, und eine gemeinsame Datenbanktransaktion ist möglich. Das Team betreibt ein Programm mit einer Datenbank statt drei Dienste mit drei Datenbanken. Verschiebt sich eine fachliche Grenze, ändert das Team Code innerhalb des Programms statt Schnittstellen zwischen Diensten.
- Die Organisation hat weder automatisierte Auslieferung noch eine Überwachung, die Vorgänge über mehrere Programme verfolgt. Mit drei Diensten müssten die Teams jeden Dienst von Hand ausliefern. Einen Fehler, der im Schadendienst entsteht und sich erst im Zahlungsdienst zeigt, müssten sie ohne Ablaufverfolgung suchen. Dann bleibt die Versicherung zunächst bei einem einzelnen Programm und führt automatisierte Auslieferung und Überwachung zuerst dort ein. Das einzelne Programm wird nur einmal ausgeliefert, und ein Fehler lässt sich darin verfolgen, ohne Aufrufe über das Netz nachzuvollziehen.
- Fast jede fachliche Änderung betrifft alle Teile der Anwendung gleichzeitig. Mit Microservices müssten die Teams bei fast jeder Änderung den Schadendienst, den Vertragsdienst und den Zahlungsdienst samt ihren Schnittstellen gemeinsam ändern und ausliefern. Dann bleibt die Anwendung ein einzelnes Programm, das die Teams gemeinsam ausliefern. Schnittstellen zwischen Diensten, die bei jeder Änderung mitgeändert und zwischen den Teams abgestimmt werden müssten, entfallen.
Nachteile und typische Fehler
Aufrufe über das Netz sind langsamer als Aufrufe innerhalb eines Programms und können scheitern. Jeder Dienst braucht deshalb Schutzmaßnahmen gegen Ausfälle der anderen Dienste, etwa ein Zeitlimit für Antworten und eine Regel für ungeprüfte Fälle. Die Daten sind verteilt. Für eine Liste aller freigegebenen Schäden mit ihrem Zahlungsstand muss ein Programm zum Beispiel den Schadendienst und den Zahlungsdienst abfragen und die Antworten zusammenführen, statt eine einzige Datenbankabfrage zu stellen. Betrieb, Überwachung und Fehlersuche werden deutlich aufwendiger. Statt eines Programms betreibt die Versicherung drei Dienste mit drei Datenbanken, ein API Gateway und eine automatisierte Auslieferung für jeden Dienst. Die Dienste bleiben über ihre Schnittstellen voneinander abhängig: Ändert das Team des Vertragsdienstes die Form der Antwort, muss auch der Schadendienst geändert werden, und beide Teams müssen sich über den Übergang abstimmen.
Typische Fehler und woran man sie erkennt:
- Falscher Zuschnitt: Die Dienste sind fachlich falsch geschnitten und müssen bei jeder fachlichen Änderung gemeinsam geändert und ausgeliefert werden. Die Regel, wann ein Schaden gedeckt ist, steht zum Beispiel zur Hälfte im Schadendienst und zur Hälfte im Vertragsdienst. Jede Änderung der Deckungsregeln ändert beide Dienste, und das Team des Schadendienstes und das Team des Vertragsdienstes müssen gemeinsam ausliefern. Dann hat die Versicherung die Nachteile eines großen Programms und die Nachteile verteilter Dienste zugleich. Erkennbar ist das an Auslieferungen, für die sich wieder mehrere Teams abstimmen müssen.
- Gemeinsame Datenbank: Der Schadendienst liest direkt in der Datenbank des Vertragsdienstes, weil das schneller zu programmieren war. Ändert das Team des Vertragsdienstes eine Tabelle, fällt der Schadendienst aus. Erkennbar ist das an Fehlern im Schadendienst unmittelbar nach einer Auslieferung des Vertragsdienstes.
- Kettenausfall: Der Schadendienst wartet ohne Zeitlimit auf den Vertragsdienst. Fällt der Vertragsdienst aus, bleibt jede Meldung, die der Schadendienst gerade bearbeitet, beim Warten auf die Antwort stehen. Der Schadendienst kann nur eine begrenzte Zahl von Meldungen gleichzeitig bearbeiten. Ist diese Zahl erreicht, nimmt der Schadendienst keine neuen Meldungen mehr an. Erkennbar ist das an Fehlermeldungen im Kundenportal, sobald nur ein einziger Dienst gestört ist.
- Unauffindbare Fehler: Ein Fehler entsteht in einem Dienst und zeigt sich erst in einem anderen. Der Schadendienst schickt den Betrag zum Beispiel in Cent, und der Zahlungsdienst liest den Betrag als Euro. Der Fehler zeigt sich erst als hundertfach zu hohe Zahlung im Zahlungsdienst. Ohne Ablaufverfolgung über alle Dienste findet niemand die Ursache. Erkennbar ist das an Störungen, bei denen jedes Team zuerst den eigenen Dienst für fehlerfrei hält.
- Auseinanderlaufende Daten: Die Sachbearbeiterin gibt Fall 4711 frei, und der Schadendienst speichert die Freigabe. Der Versand des Zahlungsauftrags an den Zahlungsdienst scheitert, und der Schadendienst wiederholt den Versand nicht. Fall 4711 ist dann im Schadendienst freigegeben, aber im Zahlungsdienst fehlt der Zahlungsauftrag. Erkennbar ist das an freigegebenen Schäden ohne Auszahlung.
Weiterführend
Verwandte Ansätze
- Bounded Context: ein fachlicher Bereich mit eigenen Begriffen, der beim Zuschnitt der Dienste hilft. Ein Bereich muss nicht genau einem Dienst entsprechen.
- API Gateway, Service Discovery und Service Mesh: mögliche Bausteine für den Zugang von außen, das Adressverzeichnis der Dienste und die Steuerung der Aufrufe zwischen Diensten. Nicht jedes System aus Microservices braucht alle drei.
- Saga: beschreibt Abläufe über mehrere Dienste, bei denen erledigte Schritte im Fehlerfall durch Gegenschritte rückgängig gemacht werden, weil es keine gemeinsame Datenbanktransaktion gibt.
- Conway's Law: beschreibt, dass der Aufbau eines Systems dem Aufbau der Organisation folgt. Dienstgrenzen und Teamgrenzen müssen deshalb zusammenpassen.
Werkzeuge und Umsetzungen
- Spring Boot: verbreitete Grundlage für Dienste in Java.
- Quarkus und Micronaut: Java-Programmrahmen für Dienste, die schnell starten.
- Kubernetes: verbreitete Plattform, auf der viele getrennte Dienste betrieben und bei Bedarf in weiteren Exemplaren gestartet werden.
- Dapr: Hilfsprogramm, das neben jedem Dienst läuft und ihm Aufrufe anderer Dienste, Nachrichten und das Speichern von Daten über eine einheitliche Schnittstelle anbietet.
Quellen
- James Lewis, Martin Fowler: Microservices: grundlegender Aufsatz von 2014, der die gemeinsamen Merkmale beschreibt, darunter Zuschnitt nach fachlichen Aufgaben, eigene Daten je Dienst, automatisierte Auslieferung und Entwurf für Ausfälle.
- Chris Richardson: Microservice Architecture pattern: nennt Vorteile wie unabhängige Auslieferung durch das zuständige Team und Nachteile wie schwer verständliche verteilte Abläufe, abgeschwächte Transaktionen und Kopplung zur Laufzeit.