
Consensus
Mehrere Knoten einigen sich auf einen Wert
Die Idee und ihr Nutzen
Bei einer Versicherung läuft der Abrechnungsdienst, der jede Nacht die Zahlungen auslöst, in drei Exemplaren auf drei Rechnern, damit die Abrechnung auch beim Ausfall eines Rechners stattfindet. Den Abrechnungslauf darf aber nur eines der drei Exemplare starten, sonst erhalten Kunden doppelte Zahlungen. Die drei Rechner halten deshalb gemeinsam fest, welcher von ihnen Anführer ist, und nur das Exemplar auf diesem Rechner startet den Lauf. Fällt der Anführer aus, einigen sich die übrigen Rechner auf einen neuen. Damit nie zwei Rechner zugleich gewählt werden, gilt eine Entscheidung erst, wenn eine Mehrheit der Rechner zugestimmt hat. Drei Rechner sind die kleinste Zahl, bei der nach dem Ausfall eines Rechners noch eine Mehrheit übrig bleibt. Ein Verfahren, mit dem sich mehrere Rechner auf diese Weise verlässlich auf einen Wert einigen, etwa auf den Anführer, heißt Konsensverfahren, englisch Consensus.

Wie funktioniert es?
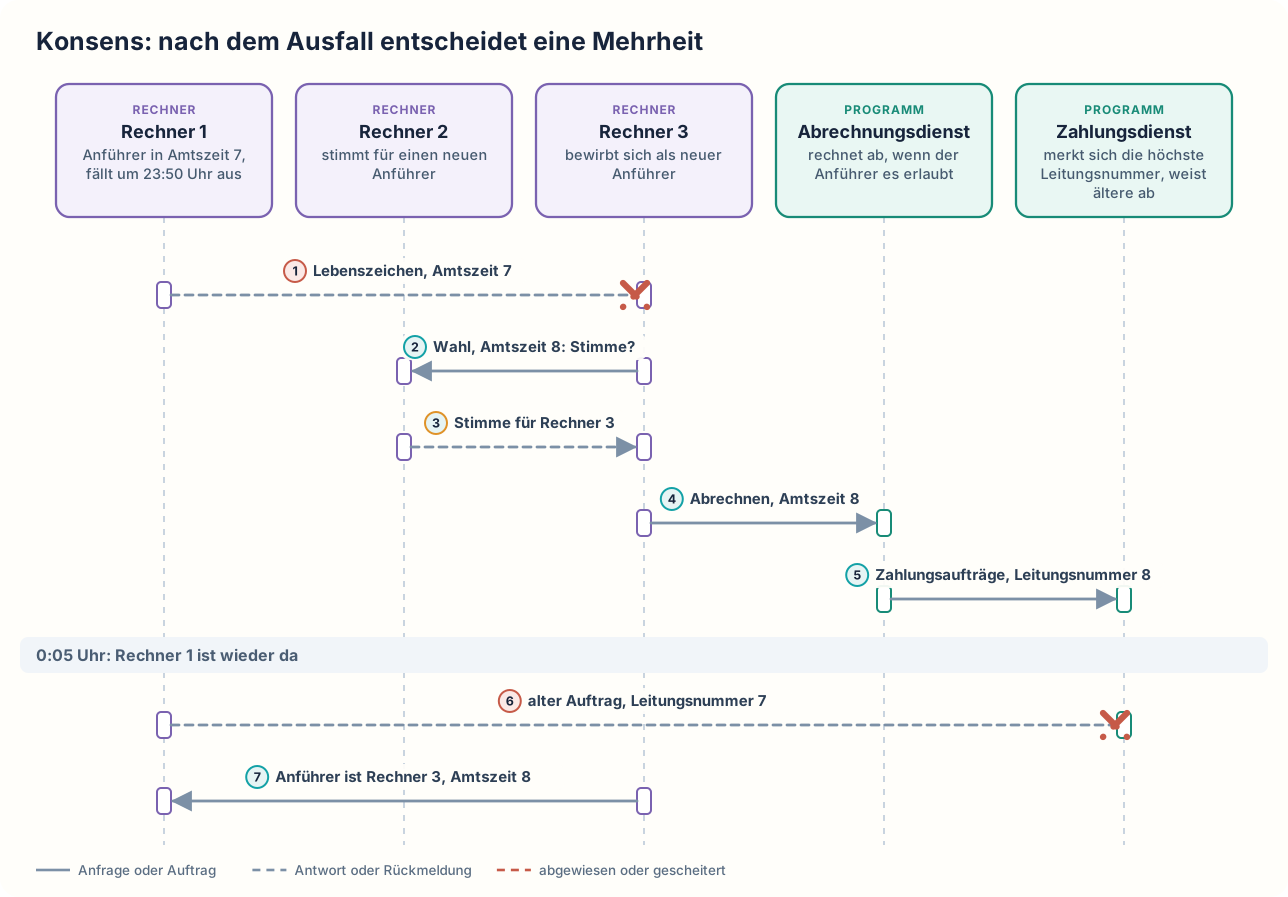
Rechner 1 ist Anführer in Amtszeit 7. Die Amtszeiten sind fortlaufend nummeriert, und jede Wahl beginnt eine neue. Um 23:50 Uhr, kurz vor dem Abrechnungslauf, kommen von Rechner 1 keine Lebenszeichen mehr. Rechner 3 bewirbt sich daraufhin für die neue Amtszeit 8 als Anführer und bittet Rechner 2 um seine Stimme. Rechner 2 stimmt für Rechner 3. Zusammen mit der eigenen Stimme hat Rechner 3 damit zwei von drei Stimmen, also eine Mehrheit, und ist neuer Anführer. Um 0:00 Uhr startet das Exemplar des Abrechnungsdienstes auf Rechner 3 den Abrechnungslauf. Dieses Exemplar schickt die Zahlungsaufträge an den Zahlungsdienst, ein eigenes System, das die Zahlungen ausführt und nicht zu den drei Rechnern gehört. Jeder dieser Zahlungsaufträge trägt die Amtszeit 8 als Leitungsnummer, also die Amtszeit des Anführers, unter dem der Auftrag erteilt wurde. Um 0:05 Uhr ist Rechner 1 wieder da. Rechner 1 hatte kurz vor dem Ausfall noch einen Zahlungsauftrag mit Leitungsnummer 7 vorbereitet und schickt ihn jetzt ab. Der Zahlungsdienst kennt schon die Leitungsnummer 8 und weist den Auftrag ab. Danach erfährt Rechner 1 von Rechner 3, dass es einen neuen Anführer gibt.
Wann eine Entscheidung der drei Rechner gilt, regelt das verbreitete Konsensverfahren Raft. Jede Änderung an den Angaben, die die drei Rechner gemeinsam festhalten, geht an den Anführer. Ein Beispiel ist der Vermerk, dass der Abrechnungslauf dieser Nacht begonnen hat. Er trägt die Änderung in sein Protokoll ein und schickt sie an die beiden anderen Rechner. Das Protokoll ist eine fortlaufende Liste aller Änderungen, die jeder Rechner bei sich speichert. Eine Änderung gilt als beschlossen, sobald eine Mehrheit der Rechner sie dauerhaft in ihrem Protokoll gespeichert hat. Der Anführer teilt den anderen Rechnern mit, bis wohin das Protokoll beschlossen ist. Ein einzelner Rechner kann eine Änderung etwas später speichern als die anderen. Hören die anderen Rechner eine festgelegte Zeit lang nichts vom Anführer, bewirbt sich einer von ihnen für die nächste Amtszeit. Jeder Rechner gibt in einer Amtszeit höchstens einem Bewerber seine Stimme. Zwei Mehrheiten von drei Rechnern überschneiden sich immer in mindestens einem Rechner. Die Mehrheit aus Rechner 2 und Rechner 3 und die Mehrheit aus Rechner 1 und Rechner 2 haben zum Beispiel Rechner 2 gemeinsam, und Rechner 2 stimmt in einer Amtszeit nur einmal ab. Deshalb können in einer Amtszeit nicht zwei Anführer gewählt sein. Gewählt werden kann außerdem nur ein Rechner, der alle beschlossenen Änderungen kennt. So geht beim Wechsel des Anführers nichts Beschlossenes verloren.
Raft sichert die Entscheidung nur unter den drei Rechnern. Ein abgelöster Anführer, der von seiner Ablösung noch nichts weiß, kann trotzdem Aufträge an andere Systeme schicken, wie Rechner 1 um 0:05 Uhr. Dagegen hilft die Leitungsnummer: Der Zahlungsdienst merkt sich die höchste Leitungsnummer, die er bisher gesehen hat, und weist jeden Auftrag mit einer kleineren Nummer ab.
Wären in dieser Nacht auch Rechner 2 und Rechner 3 durch eine Netzstörung voneinander getrennt gewesen, hätte keiner der beiden zwei Stimmen erhalten. Dann wäre kein neuer Anführer gewählt worden, und der Abrechnungslauf hätte gewartet, bis die Netzverbindung wieder steht. Die verspätete Abrechnung ist in diesem Fall gewollt, denn bei zwei gleichzeitigen Abrechnungen erhielten Kunden doppelte Zahlungen.
Konsens: nach dem Ausfall entscheidet eine Mehrheit
Wann ist es sinnvoll und wann nicht?
Ein Konsensverfahren lohnt sich
- Mehrere Rechner speichern gemeinsam Angaben, bei denen ein Widerspruch nicht hinnehmbar ist. Ein Beispiel ist, welcher Rechner Anführer ist. Ein zweites ist, wer eine Sperre hält und damit als Einziger etwas bearbeiten darf. Ein drittes ist, welche Einstellung gilt. Ein einzelner Rechner käme ohne Abstimmung aus, aber fällt er aus, sind die Angaben verloren oder nicht erreichbar.
- Nachrichten zwischen den Rechnern kommen verzögert, in falscher Reihenfolge oder gar nicht an, und Rechner fallen ohne Vorwarnung aus. Ein Rechner, der eine Weile nichts von einem anderen hört, weiß nicht, ob der andere ausgefallen ist oder nur die Netzverbindung gestört ist. Entscheidet jeder Rechner nach seinem eigenen Wissen, können sich zwei Rechner zugleich für den Anführer halten, und Kunden erhalten doppelte Zahlungen.
- Der Ausfall eines Rechners soll ohne Eingriff eines Menschen überbrückt werden, und eine kurze Wartezeit ist hinnehmbar. Nach dem Ausfall von Rechner 1 startet der Abrechnungslauf trotzdem um 0:00 Uhr. Ohne Konsensverfahren müsste nachts jemand den Ausfall bemerken und einen anderen Rechner von Hand zum Anführer machen.
- Ein Team baut eine ausfallsichere Datenbank oder einen Koordinationsdienst, über den sich andere Programme abstimmen. Konsensverfahren sind dafür die übliche Grundlage. Der Speicher etcd, der den Zustand von Kubernetes festhält, verwendet zum Beispiel Raft. Ohne Konsensverfahren könnten zwei Rechner der Datenbank nach einer Netzstörung verschiedene Stände für gültig halten.
Ein Konsensverfahren ist nicht das Richtige
- Es fallen sehr viele Schreibvorgänge an. Ein Beispiel wäre, jeden einzelnen Zahlungsauftrag des nächtlichen Abrechnungslaufs im Konsensverfahren festzuhalten. Jede Änderung läuft über den einen Anführer und gilt erst, wenn eine Mehrheit der Rechner sie gespeichert hat. Mehr Änderungen, als der Anführer auf diese Weise verteilen kann, schafft die Gruppe nicht. Dann hält das Entwicklungsteam im Konsensverfahren nur die Angaben fest, bei denen ein Widerspruch nicht hinnehmbar ist, etwa welcher Rechner Anführer ist. Die übrigen Daten speichert das Entwicklungsteam in einer Datenbank, die nicht für jede Änderung auf eine Mehrheit wartet. Sonst müsste das Betriebsteam die Daten auf mehrere Gruppen von Rechnern mit je einem Anführer aufteilen und jede Gruppe eigens betreiben.
- Die Rechner stehen an weit entfernten Standorten, und kurze Antwortzeiten sind gefordert. Jede Änderung muss auf Antworten von den entfernten Standorten warten. Dann stellt das Betriebsteam die Rechner der Gruppe in nahe beieinanderliegende Rechenzentren derselben Region. Jede Änderung wartet so nur auf Antworten aus diesen nahen Rechenzentren. Fällt die ganze Region aus, steht die Gruppe allerdings still.
- Ein kurz abweichender Stand ist hinnehmbar, und Schreiben soll auch während einer Netzstörung möglich sein. Ein Beispiel ist ein Zähler für Seitenaufrufe im Kundenportal. Ein Konsensverfahren würde jeden Seitenaufruf erst nach der Zustimmung einer Mehrheit zählen und bei einer Netzstörung ohne Mehrheit gar nicht. Stattdessen speichert jeder Rechner eine Änderung sofort selbst, und die Rechner gleichen ihre Stände später ab, wie es Eventual Consistency beschreibt. Keine Änderung wartet auf eine Mehrheit, und der Zähler zählt auch während einer Netzstörung weiter.
- Bei einem Ausfall darf ein Mensch eingreifen, und der Abrechnungslauf darf so lange warten. Dann entscheidet jemand aus dem Betriebsteam, welcher Rechner abrechnet, und keine Mehrheit muss darüber abstimmen. Das Betriebsteam betreibt dazu einen einzelnen Rechner mit einem Ersatzrechner in Bereitschaft und schaltet bei einem Ausfall von Hand auf den Ersatzrechner um (Hot, Warm and Cold Standby). Der dritte Rechner und die Abstimmung zwischen den Rechnern entfallen. Vor dem Umschalten muss allerdings sicher feststehen, dass der alte Rechner nicht mehr arbeitet.
- Das Entwicklungsteam braucht für den Abrechnungsdienst nur einen Anführer oder eine Sperre und will dafür ein eigenes Konsensverfahren programmieren. In einem selbst programmierten Konsensverfahren fallen seltene Fehler wie zwei gleichzeitige Anführer in Tests kaum auf. Stattdessen nutzt das Entwicklungsteam einen fertigen Koordinationsdienst wie etcd oder Apache ZooKeeper, der intern ein Konsensverfahren verwendet. Über den Koordinationsdienst wählen die drei Exemplare des Abrechnungsdienstes einen Anführer (Leader Election) oder erhalten eine Sperre (Distributed Lock). Programmieren und Testen eines eigenen Konsensverfahrens entfallen.
Nachteile und typische Fehler
Jede Änderung gilt erst, wenn eine Mehrheit der Rechner sie gespeichert hat, und dauert deshalb länger als auf einem einzelnen Rechner. Ist keine Mehrheit erreichbar, kann das Verfahren weder einen Anführer wählen noch Änderungen beschließen. Es bleibt stehen, bis wieder genug Rechner erreichbar sind. Das Verfahren schützt außerdem nicht vor Fehlern im Abrechnungsdienst selbst. Die Prüfung der Leitungsnummer muss jedes System selbst umsetzen, das Aufträge annimmt. Bei der Abrechnung ist das der Zahlungsdienst.
Typische Fehler und woran man sie erkennt:
- Patt zwischen zwei Standorten: Das Betriebsteam erweitert die Gruppe auf vier Rechner und verteilt sie gleichmäßig auf zwei Standorte, zwei Rechner an jedem Standort. Die Mehrheit von vier Rechnern sind drei. Nach einer Trennung der Standorte erreicht jeder Standort nur zwei Stimmen und damit keine Mehrheit. Die Abrechnung wartet dann, obwohl an jedem Standort Rechner laufen. Erkennbar ist das an einer Gruppe ohne Anführer, während alle Rechner selbst erreichbar sind. Ein dritter, unabhängiger Standort mit mindestens einem Rechner löst das Patt auf, muss aber zusätzlich betrieben werden.
- Fehlende Leitungsnummer: Der Zahlungsdienst prüft die Leitungsnummer nicht. Rechner 1 schickt nach seiner Rückkehr den vorbereiteten Zahlungsauftrag mit Leitungsnummer 7 ab, und der Zahlungsdienst führt ihn aus. Hat das Exemplar des Abrechnungsdienstes auf Rechner 3 dieselbe Zahlung schon beauftragt, erhält der Kunde sie doppelt. Erkennbar ist das an Zahlungsaufträgen mit einer älteren Amtszeit, die nach einem Wechsel des Anführers ausgeführt wurden.
- Eigenbau mit seltenen Fehlern: Ein selbst programmiertes Verfahren verhält sich in Tests richtig, wählt aber bei einer seltenen zeitlichen Abfolge zwei Anführer. Weil solche Abfolgen in Tests kaum vorkommen, verwenden die meisten Teams erprobte Umsetzungen wie etcd oder Apache ZooKeeper. Erkennbar ist der Fehler an zwei Rechnern, die für dieselbe Amtszeit Aufträge erteilen.
- Zu kurze Wartezeit: Die Zeit, nach der die anderen Rechner einen Anführer für ausgefallen halten, ist kürzer als übliche Verzögerungen im Netz. Die Rechner wählen ständig neu, und in der Zwischenzeit werden keine Änderungen beschlossen. Erkennbar ist das an schnell steigenden Amtszeiten, ohne dass ein Rechner ausgefallen ist.
Weiterführend
Verwandte Ansätze
- Quorum: die erforderliche Mehrheit, auf der die Entscheidungen beruhen.
- CAP Theorem: beschreibt, dass ein System bei einer Netztrennung zwischen Übereinstimmung und Verfügbarkeit wählen muss. Konsensverfahren wählen Übereinstimmung und beschließen ohne Mehrheit nichts.
- Replication: das Kopieren von Daten auf mehrere Rechner. Ein Konsensverfahren legt die Reihenfolge der Änderungen fest, die alle Kopien übernehmen.
Werkzeuge und Umsetzungen
- etcd: Speicher für Schlüssel und Werte, der Raft verwendet. Er speichert unter anderem den Zustand von Kubernetes, einer verbreiteten Plattform zum Betrieb von Anwendungen auf vielen Servern.
- Apache ZooKeeper: Koordinationsdienst mit einem eigenen Konsensverfahren namens ZAB.
- Apache Ratis: Java-Bibliothek, mit der sich Raft in eigene Programme einbauen lässt.
- HashiCorp Raft: Bibliothek für Raft in der Programmiersprache Go.
Quellen
- Ongaro und Ousterhout: In Search of an Understandable Consensus Algorithm: der Aufsatz, der Raft 2014 vorgestellt hat, mit Wahl, Protokoll und Sicherheitsregeln.
- Raft-Projekt: The Raft Consensus Algorithm: offizielle Seite des Verfahrens mit einer bedienbaren Darstellung eines Raft-Verbunds im Browser, an der sich Wahl und Ausfall des Anführers nachvollziehen lassen, sowie Verweisen auf Vorträge und Umsetzungen.
- Martin Kleppmann: How to do distributed locking: Beitrag von 2016, der begründet, warum ein abgelöster Inhaber einer Sperre noch Schaden anrichten kann, und Leitungsnummern (fencing tokens) als Gegenmittel beschreibt.