
Hot, Warm and Cold Standby
Bereitschaftsstufen einer Ersatzumgebung
Die Idee und ihr Nutzen
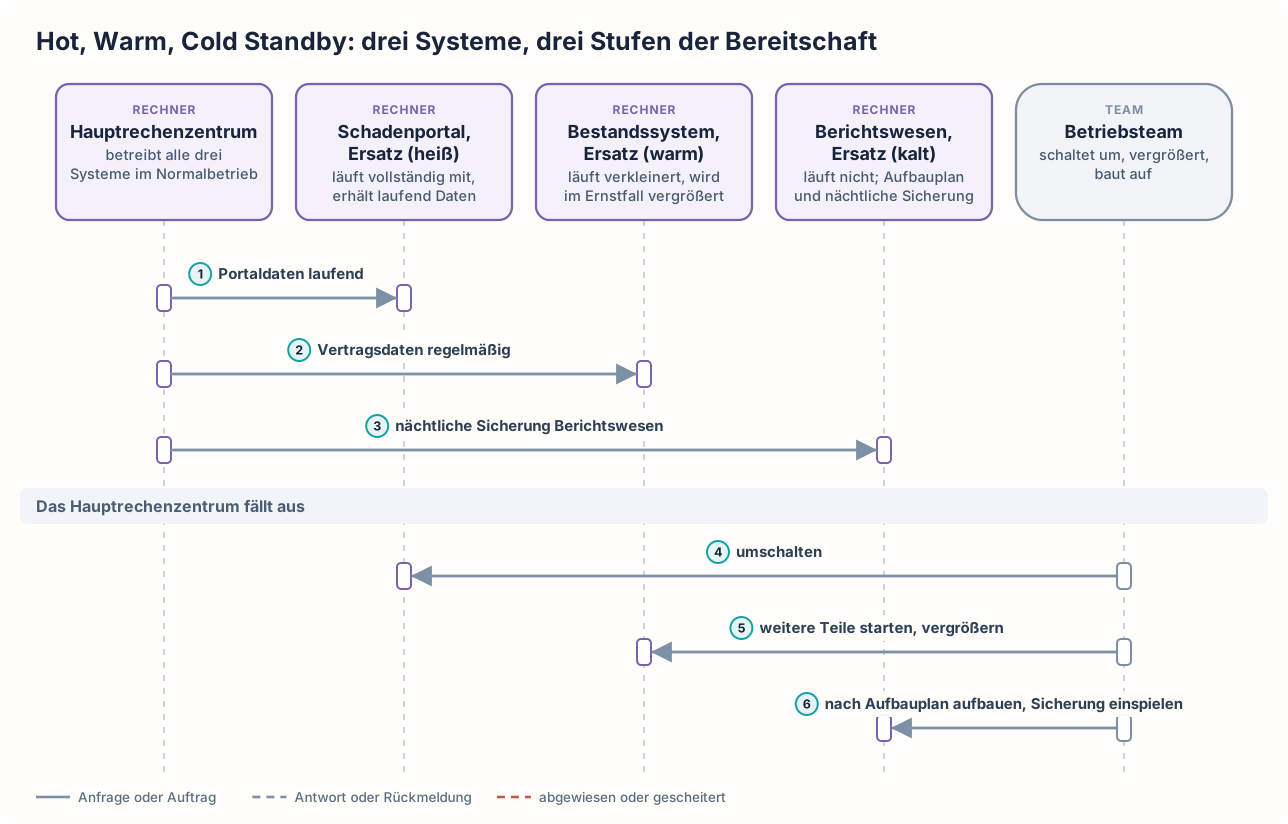
Fällt das Hauptrechenzentrum einer Versicherung aus, sollen ihre Systeme in einem zweiten Rechenzentrum wieder anlaufen, aber nicht alle gleich schnell. Das Schadenportal für Kunden muss innerhalb von Minuten wieder erreichbar sein, weil Kunden gerade nach einem Unwetter sofort ihre Schäden melden wollen. Das Bestandssystem mit den Verträgen muss innerhalb von zwei Stunden wieder laufen; so lange können die Sachbearbeiter mit Arbeiten überbrücken, die keine Vertragsdaten brauchen. Das Berichtswesen darf mehrere Tage ausfallen, weil Monatsberichte so lange warten können. Die Server und Programme, die ein System im zweiten Rechenzentrum übernehmen, heißen Ersatzumgebung. Eine Ersatzumgebung, die ständig vollständig mitläuft, kostet fast so viel wie die Server und Programme im Hauptrechenzentrum. Deshalb bereitet die Versicherung die Ersatzumgebung jedes Systems nur so weit vor, wie seine erlaubte Ausfallzeit verlangt. Beim Schadenportal läuft die Ersatzumgebung bereits vollständig mit; das heißt Hot Standby. Beim Bestandssystem läuft sie mit weniger Servern als im Hauptrechenzentrum und bekommt im Ernstfall weitere Server dazu; das heißt Warm Standby. Beim Berichtswesen wird die Ersatzumgebung erst im Ernstfall aus Sicherungen aufgebaut; das heißt Cold Standby.

Wie funktioniert es?
Im Normalbetrieb betreibt das Hauptrechenzentrum alle drei Systeme. Das Hauptrechenzentrum überträgt die Daten des Schadenportals laufend in das zweite Rechenzentrum und die Vertragsdaten des Bestandssystems regelmäßig. Vom Berichtswesen überträgt es nur die nächtliche Sicherung. Von diesen drei Übertragungen hängt ab, wie viele Daten im Ernstfall fehlen können. Dann fällt das Hauptrechenzentrum aus. Das Betriebsteam, das die Rechenzentren betreut, stellt zuerst fest, dass das Hauptrechenzentrum tatsächlich nicht mehr arbeitet. Damit verhindert das Betriebsteam, dass beide Rechenzentren gleichzeitig Daten ändern. Beim Schadenportal schaltet das Betriebsteam nur auf die laufende Ersatzumgebung um, und nach Minuten melden Kunden wieder Schäden. Beim Bestandssystem startet das Betriebsteam weitere Teile der verkleinerten Ersatzumgebung und erhöht die Zahl ihrer Server. Das Ziel sind höchstens zwei Stunden. Zweimal im Jahr übt das Betriebsteam dieses Hochfahren und misst die Zeit; bei der letzten Übung dauerte es eine Stunde und vierzig Minuten. Für das Berichtswesen baut das Betriebsteam die Ersatzumgebung nach einem vorbereiteten Aufbauplan neu auf und spielt die letzte nächtliche Sicherung ein. Das kann Tage dauern. Einen Datenverlust von bis zu einem Tag hat die Fachabteilung als tragbar eingestuft.
Die drei Stufen unterscheiden sich darin, wie weit die Ersatzumgebung schon bereitsteht. Bei Hot Standby, auf Deutsch heißer Bereitschaft, läuft die Ersatzumgebung bereits vollständig und erhält die Daten laufend vom Hauptrechenzentrum. Im Ernstfall muss das Betriebsteam nur noch umschalten. Mit geübter, gut vorbereiteter Umschaltung dauert das Sekunden bis Minuten. Bei Warm Standby, warmer Bereitschaft, laufen die wichtigsten Teile der Ersatzumgebung bereits, oft mit weniger Servern als im Hauptrechenzentrum. Die Daten kommen regelmäßig oder laufend an. Im Ernstfall startet das Betriebsteam weitere Teile und erhöht die Zahl der Server. Wie lange das dauert, hängt vom Aufbau des Systems ab und lässt sich nur durch Übungen verlässlich feststellen. Bei Cold Standby, kalter Bereitschaft, läuft die Ersatzumgebung nicht. Vorhanden sind ein Aufbauplan, Datensicherungen und oft Vorlagen, mit denen sich Server automatisch einrichten lassen. Im Ernstfall baut das Betriebsteam die Ersatzumgebung auf und spielt eine Sicherung ein. Das dauert Stunden bis Tage.
Welche Stufe ein System bekommt, folgt aus zwei Zielwerten. Das Recovery Time Objective, kurz RTO, legt fest, wie lange das System höchstens ausfallen darf; beim Bestandssystem sind das zwei Stunden. Das Recovery Point Objective, kurz RPO, legt fest, wie viele der zuletzt eingegebenen Daten höchstens verloren gehen dürfen. Das RPO wird als Zeitspanne angegeben; beim Berichtswesen ist es ein Tag. Die Fachabteilung legt beide Zielwerte für jedes System einzeln fest, nicht pauschal für das ganze Unternehmen. Aufsichtsbehörden können dafür Vorgaben machen. Das Betriebsteam richtet die Ersatzumgebungen ein und führt im Ernstfall das Umschalten, das Vergrößern und den Aufbau aus.
Nach dem Umschalten fehlen in jedem System die Änderungen, die seit der letzten Übertragung oder Sicherung entstanden sind. Beim Schadenportal können die zuletzt gespeicherten Änderungen fehlen, wenn die Daten mit Verzögerung übertragen werden. Die Fachabteilung muss wissen, welche Eingaben sie gegebenenfalls nachholen muss.
Hot, Warm, Cold Standby: drei Systeme, drei Stufen der Bereitschaft
Wann ist es sinnvoll und wann nicht?
Die Einteilung in Hot, Warm und Cold Standby lohnt sich
- Mehrere Systeme müssen nach dem Ausfall eines ganzen Standorts wieder anlaufen und dürfen unterschiedlich lange ausfallen. Ein Standort kann zum Beispiel durch Stromausfall, Brand oder Hochwasser ganz ausfallen. Behandelt die Versicherung alle Systeme gleich, macht sie einen von zwei Fehlern. Entweder gibt sie auch für das Berichtswesen viel Geld für eine sofort bereite Ersatzumgebung aus. Oder das Schadenportal ist nach einem Ausfall tagelang nicht erreichbar, obwohl Kunden es nach einem Unwetter dringend brauchen.
- Schon wenige Minuten Ausfall eines Systems treffen viele Kunden oder lösen Probleme mit der Aufsicht aus. Ein solches System bekommt Hot Standby. Ohne laufende Ersatzumgebung müssten die Kunden warten, bis das Betriebsteam weitere Server gestartet oder eine Ersatzumgebung aufgebaut hat, und das dauert Stunden bis Tage.
- Bei einem wichtigen System sind einige Stunden Ausfall tragbar, beim Bestandssystem zum Beispiel zwei Stunden. Ein solches System bekommt Warm Standby. Die verkleinerte Ersatzumgebung des Bestandssystems läuft mit weniger Servern als im Hauptrechenzentrum, und die Versicherung bezahlt nur diese Server laufend. Für eine vollständig mitlaufende Ersatzumgebung würde die Versicherung dagegen ständig so viele Server bezahlen wie im Hauptrechenzentrum.
- Ein System darf tagelang ausfallen. Ein solches System bekommt Cold Standby, und die Versicherung bezahlt dafür keine laufende Ersatzumgebung. Eine laufende Ersatzumgebung für das Berichtswesen würde die Versicherung dagegen jeden Monat bezahlen, obwohl Monatsberichte einige Tage warten können.
- Für jedes System soll festgehalten sein, welche Ausfallzeit und welcher Datenverlust vereinbart sind. Für die Wahl der Stufe muss die Fachabteilung genau diese beiden Werte festlegen, beim Bestandssystem zum Beispiel höchstens zwei Stunden Ausfall. Ohne diese Festlegung erfährt das Betriebsteam oft erst im Ernstfall, wie lange die Fachabteilung auf ein System verzichten kann.
Die Einteilung in Hot, Warm und Cold Standby ist nicht das Richtige
- Es geht um Fehler in den Daten selbst. Ein Mitarbeiter löscht zum Beispiel versehentlich Daten des Schadenportals. Die Einteilung legt nur fest, wie schnell eine Ersatzumgebung nach dem Ausfall des Hauptrechenzentrums bereitsteht. Gegen die Löschung hilft sie nicht, denn das Hauptrechenzentrum überträgt die Löschung laufend in die Ersatzumgebung des Schadenportals. Dagegen hilft nur, dass das Betriebsteam regelmäßig Sicherungen anlegt und mehrere ältere Stände aufbewahrt. Aus einer Sicherung von vor dem Löschen stellt das Betriebsteam die Daten wieder her.
- Es geht nur um den Ausfall einzelner Server im Hauptrechenzentrum. Mit der Einteilung müsste das Betriebsteam wegen eines einzigen ausgefallenen Servers das ganze Schadenportal auf die Ersatzumgebung im zweiten Rechenzentrum umschalten. Stattdessen betreibt das Betriebsteam im Hauptrechenzentrum mehrere Exemplare des Schadenportals auf verschiedenen Servern, wie es Redundancy and Failover beschreibt. Fällt ein Server aus, arbeiten die Exemplare auf den übrigen Servern weiter, ohne dass jemand umschaltet. Ein zweites Rechenzentrum braucht es dafür nicht.
- Für ein System sind noch keine Zielwerte für Ausfallzeit und Datenverlust festgelegt. Dann lässt sich keine Stufe begründet wählen. Zuerst muss die Fachabteilung diese Werte bestimmen. So vermeidet die Versicherung, für ein System eine Stufe zu bezahlen, die es nicht braucht, oder eine zu wählen, die im Ernstfall zu langsam ist.
- Selbst Minuten Ausfall sind nicht tragbar. Auch bei Hot Standby muss das Betriebsteam erst feststellen, dass das Hauptrechenzentrum ausgefallen ist, und dann umschalten, und das dauert Sekunden bis Minuten. Stattdessen betreibt die Versicherung das System in beiden Rechenzentren gleichzeitig, und beide Rechenzentren bearbeiten Anfragen. Fällt ein Rechenzentrum aus, bearbeitet das andere alle Anfragen weiter, ohne dass jemand umschalten muss. Dafür braucht jedes der beiden Rechenzentren genug Server für alle Anfragen, und es braucht Regeln dafür, wie beide Rechenzentren dieselben Daten gleichzeitig ändern.
Nachteile und typische Fehler
Je schneller die Übernahme sein soll, desto teurer wird die Vorbereitung. Bei Hot Standby braucht die Ersatzumgebung dieselben Server, dieselben Lizenzen und denselben Betriebsaufwand wie das Original. Dazu kommt bei Hot Standby die Abwägung zwischen Geschwindigkeit und Datenverlust: Soll gar nichts verloren gehen, muss jede Änderung erst im zweiten Rechenzentrum ankommen, bevor sie als gespeichert gilt. Das macht jede Änderung im Hauptrechenzentrum langsamer. In allen Stufen muss das Betriebsteam jede Aktualisierung und jede geänderte Einstellung auch in die Ersatzumgebung oder in den Aufbauplan übernehmen, und das Umschalten, das Vergrößern und der Aufbau müssen regelmäßig geübt werden.
Typische Fehler und woran man sie erkennt:
- Veraltete Ersatzumgebung: Das Betriebsteam spielt Aktualisierungen und geänderte Einstellungen nur im Hauptrechenzentrum ein, weil die Ersatzumgebung im Alltag nicht benutzt wird. Die Ersatzumgebung weicht so mit jedem Monat weiter vom Hauptrechenzentrum ab, und ihre Zertifikate für verschlüsselte Verbindungen laufen unbemerkt ab. Erkennbar ist das bei Übungen an Starts, die mit Fehlern abbrechen.
- Übernommener Datenfehler: Ein Mitarbeiter löscht im Hauptrechenzentrum versehentlich Daten des Schadenportals. Das Hauptrechenzentrum überträgt die Löschung wie jede andere Änderung laufend in die Ersatzumgebung, und die Daten fehlen dort ebenfalls. Erkennbar ist das, wenn die gelöschten Daten auch im zweiten Rechenzentrum fehlen und nur eine ältere Sicherung sie noch enthält.
- Zwei aktive Rechenzentren: Eine Netzstörung trennt das Betriebsteam vom Hauptrechenzentrum, das Hauptrechenzentrum arbeitet aber weiter. Das Betriebsteam hält das Hauptrechenzentrum für ausgefallen und schaltet das Schadenportal auf die Ersatzumgebung um. Kunden, die das Hauptrechenzentrum noch erreichen, melden ihre Schäden dort, alle anderen in der Ersatzumgebung. Beide Rechenzentren ändern dann dieselben Daten unabhängig voneinander. Erkennbar ist das an Schäden, die in beiden Rechenzentren mit unterschiedlichem Stand gespeichert sind.
- Ungeübte Schritte: Das Betriebsteam hat den Aufbau des Berichtswesens nie geübt. Im Ernstfall fehlen ihm die Zugangsdaten, um die nächtliche Sicherung einzuspielen, und das Betriebsteam muss die Zugangsdaten erst beschaffen. Das Berichtswesen verfehlt dann sein RTO. Erkennbar ist das an Übungen, die das Ziel überschreiten, oder daran, dass es keine Aufzeichnungen über Übungen gibt.
- Fehlende Server: Der Aufbauplan des Berichtswesens setzt Server im zweiten Rechenzentrum voraus. Niemand hat vorab geklärt, ob diese Server im Ernstfall bereitstehen. Im Ernstfall muss das Betriebsteam erst Server beschaffen, bevor der Aufbau beginnen kann. Erkennbar ist das, wenn der Aufbauplan Server voraussetzt, für die es weder einen Vertrag noch eine Reserve gibt.
Weiterführend
Verwandte Ansätze
- Disaster Recovery: der Gesamtplan für den Verlust eines Standorts, in dem die Stufen und Zielwerte festgelegt werden.
- Replication: beschreibt, wie Daten laufend in die Ersatzumgebung übertragen werden.
- Infrastructure as Code: beschreibt Server und Netze in Dateien, aus denen sich eine Cold-Standby-Umgebung automatisch und jedes Mal gleich aufbauen lässt.
Werkzeuge und Umsetzungen
- Patroni: hält Kopien der Datenbank PostgreSQL als laufende Ersatzdatenbanken bereit und schaltet bei einem Ausfall automatisch um.
- DRBD: spiegelt die Festplatten eines Servers laufend auf einen Ersatzserver.
- Pacemaker: steuert, welcher Server einen Dienst betreibt, und verlagert den Dienst bei einem Ausfall auf einen anderen Server.
- Velero: sichert Anwendungen in Kubernetes, einer verbreiteten Plattform zum Betrieb von Anwendungen auf vielen Servern, und stellt sie in einer Ersatzumgebung wieder her.
Quellen
- AWS: Disaster recovery options in the cloud: beschreibt vier Stufen von Sicherung und Wiederherstellung bis zum gleichzeitigen Betrieb an mehreren Standorten, darunter Warm Standby als verkleinerte, voll funktionsfähige Kopie, und ihren Zusammenhang mit RTO, RPO und Kosten.
- NIST: SP 800-34 Rev. 1, Contingency Planning Guide for Federal Information Systems: Leitfaden von 2010, der Ausweichstandorte als Cold Site, Warm Site und Hot Site unterscheidet und die Begriffe RTO und RPO erklärt.