
Redundancy and Failover
Eine Ersatzkomponente übernimmt bei Ausfall
Die Idee und ihr Nutzen
Das Schadenportal einer Versicherung, über das Kunden ihre Schäden melden, läuft auf Portalserver 1. Ein zweiter, gleich eingerichteter Portalserver 2 steht in Bereitschaft: Auf Portalserver 2 läuft dasselbe Portalprogramm, aber Portalserver 2 erhält im Normalbetrieb keine Anfragen. Die Anfragen der Kunden leitet ein Programm namens „Umschaltung“ an die Server weiter. Stürzt Portalserver 1 ab, erkennt die „Umschaltung“ den Ausfall und schickt alle neuen Anfragen an Portalserver 2. Die Kunden können so nach wenigen Sekunden weiterarbeiten, statt zu warten, bis jemand Portalserver 1 neu startet. Dass ein gleich eingerichteter Ersatz wie Portalserver 2 bereitsteht, heißt Redundanz. Das Umschalten der Anfragen auf den Ersatz heißt Failover.

Wie funktioniert es?
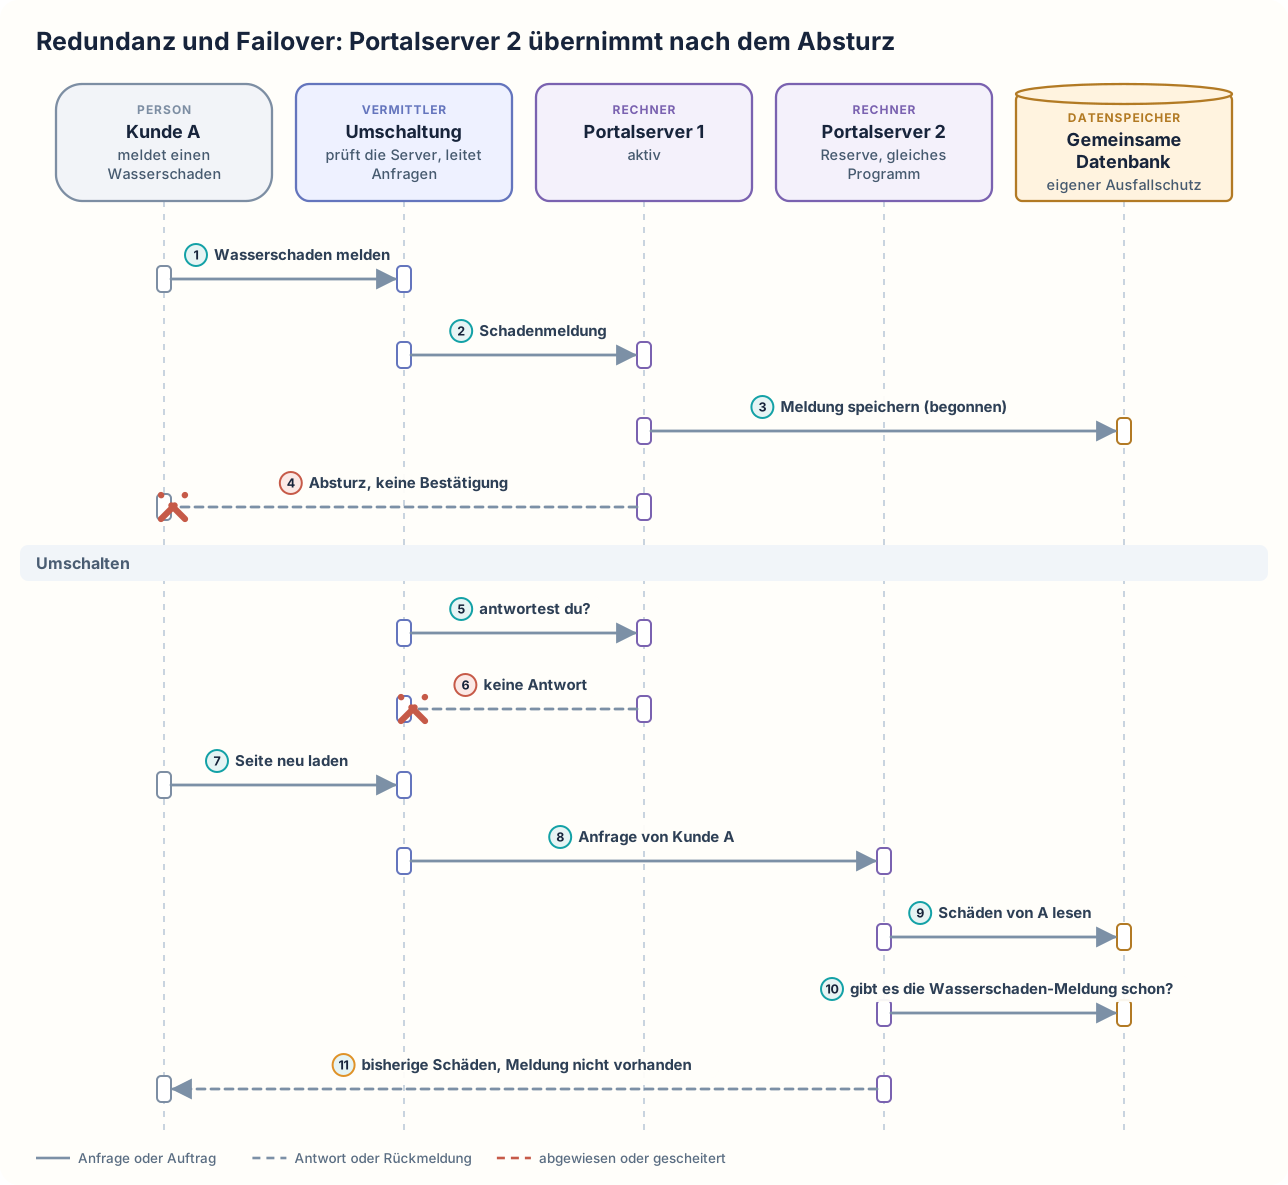
Kunde A schickt die Meldung eines Wasserschadens ab. Die „Umschaltung“ leitet die Anfrage an den aktiven Portalserver 1. Portalserver 1 beginnt, die Meldung in der gemeinsamen Datenbank beider Portalserver zu speichern, und stürzt mitten in diesem Vorgang ab. Kunde A erhält keine Antwort. Die „Umschaltung“ prüft in kurzen Abständen, ob die Server tatsächlich Anfragen beantworten. Portalserver 1 antwortet nicht, und nach wenigen Sekunden nimmt die „Umschaltung“ Portalserver 1 aus der Auswahl der Server, an die sie Anfragen schickt. Kunde A lädt die Seite neu. Die „Umschaltung“ schickt die Anfrage von Kunde A und alle weiteren Anfragen jetzt an Portalserver 2. Portalserver 2 liest aus der gemeinsamen Datenbank die bereits gespeicherten Schäden von Kunde A und zeigt sie an. Offen ist noch, ob die Meldung des Wasserschadens vor dem Absturz vollständig gespeichert wurde. Portalserver 2 prüft deshalb, ob die Meldung schon in der gemeinsamen Datenbank steht. Die Meldung ist nicht vorhanden, und Kunde A schickt die Meldung erneut ab, ohne dass eine doppelte oder eine verlorene Meldung entsteht.
Portalserver 1 bearbeitet im Normalbetrieb alle Anfragen. Portalserver 2 läuft mit demselben Programm in Bereitschaft, kann auf dieselben Daten zugreifen und muss im Ernstfall alle Anfragen allein bearbeiten können. Die „Umschaltung“ nimmt alle Anfragen der Kunden an, prüft regelmäßig, ob die Server tatsächlich antworten, und entscheidet, welcher Server die Anfragen erhält. Die gemeinsame Datenbank hält die Schadenmeldungen, sodass beide Portalserver denselben Stand lesen. Die gemeinsame Datenbank braucht einen eigenen Ausfallschutz, etwa eine zweite Datenbank auf einem anderen Rechner, die jede Änderung übernimmt, denn fällt sie aus, helfen zwei Portalserver nicht.
Andere Systeme nutzen dagegen zwei Server gleichzeitig und verteilen die Anfragen im Normalbetrieb auf beide Server. Fällt einer der beiden aus, bearbeitet der andere alle Anfragen allein. Bei Anfragen, die keine Zwischenstände auf dem Server hinterlassen, etwa kein halb ausgefülltes Meldeformular im Arbeitsspeicher des Servers, genügt für das Umschalten oft ein Lastverteiler, ein Programm, das Anfragen auf verfügbare Server verteilt und ausgefallene Server überspringt. Bei Datenbanken und bei Vorgängen, die gerade laufen, muss zusätzlich geklärt sein, welche Daten der Ersatz bereits hat, wie bei der Meldung des Wasserschadens von Kunde A.
Redundanz mit Failover garantiert keine Arbeit ohne Unterbrechung. Zwischen Absturz und Umschalten vergehen einige Sekunden, und jede Anfrage, die Portalserver 1 beim Absturz gerade bearbeitete, bricht ab. Ist Portalserver 1 repariert, nimmt die „Umschaltung“ Portalserver 1 erst wieder in die Auswahl, wenn er die Prüfungen mehrmals hintereinander besteht. Sonst würde ein Server, der nur kurz antwortet und wieder abstürzt, erneut Anfragen erhalten.
Redundanz und Failover: Portalserver 2 übernimmt nach dem Absturz
Wann ist es sinnvoll und wann nicht?
Redundanz mit Failover lohnt sich
- Eine Funktion muss auch beim Ausfall eines Servers erreichbar bleiben. Ein Beispiel ist ein Portal, über das Kunden rund um die Uhr Schäden melden. Solange das Schadenportal nur auf Portalserver 1 läuft, kann bei einem Absturz von Portalserver 1 kein Kunde einen Schaden melden.
- Bei einem Ausfall nachts oder am Wochenende würde es Stunden dauern, bis jemand den Ausfall bemerkt und den Server neu startet. Die „Umschaltung“ bemerkt den Ausfall selbst und schaltet um, auch wenn nachts niemand vom Betriebsteam zuschaut.
- Die Daten liegen außerhalb der Portalserver, etwa in einer gemeinsamen Datenbank. Ohne Ersatzserver kann Kunde A seine gespeicherten Schäden bis zum Neustart von Portalserver 1 nicht abrufen, obwohl die gemeinsame Datenbank läuft. Mit Redundanz liest Portalserver 2 nach dem Umschalten die bereits gespeicherten Schäden von Kunde A aus der gemeinsamen Datenbank.
- Ein abgestürzter Server soll in Ruhe untersucht werden können. Ohne Ersatzserver muss das Betriebsteam Portalserver 1 sofort neu starten, damit Kunden wieder Schäden melden können, und kann die Ursache erst danach suchen. Mit Redundanz kann das Betriebsteam Portalserver 1 nach dem Absturz untersuchen und reparieren, während Portalserver 2 die Anfragen bearbeitet.
Redundanz mit Failover ist nicht das Richtige
- Beide Server können aus demselben Grund ausfallen. Das ist der Fall, wenn sie als virtuelle Server auf demselben Rechner laufen, im selben Rechenzentrum ohne getrennte Strom- und Netzanbindung stehen oder dieselbe gestörte Datenbank nutzen. Portalserver 2 fällt dann zusammen mit Portalserver 1 aus, und die Versicherung bezahlt einen zweiten Server, der im Ernstfall nicht hilft. Dann beseitigt das Betriebsteam zuerst die gemeinsame Ursache: Portalserver 2 kommt auf einen eigenen Rechner mit eigener Strom- und Netzanbindung, und die gemeinsame Datenbank erhält einen eigenen Ausfallschutz.
- Eine Stunde Stillstand ist verkraftbar. Ein Beispiel ist ein internes Programm, mit dem Sachbearbeiter Berichte erstellen. Ein Ersatzserver würde dann nur eine Unterbrechung verkürzen, die die Sachbearbeiter ohnehin hinnehmen können. Stattdessen richtet das Betriebsteam eine automatische Überwachung ein, die einen abgestürzten Server neu startet oder das Betriebsteam alarmiert. Die Versicherung spart so den Ersatzserver, der sonst ständig bereitsteht und bezahlt werden muss.
- Ein Server hält wichtige Zwischenstände nur im eigenen Arbeitsspeicher, und der Ersatz kann diese Zwischenstände nicht lesen. Dann ändert das Team, das das Portalprogramm entwickelt, das Portalprogramm zuerst so, dass es diese Zwischenstände in der gemeinsamen Datenbank speichert. Sonst ist das Portal nach dem Umschalten erreichbar, aber ein Teil der Daten fehlt.
- Das Portal muss auch den Ausfall eines ganzen Rechenzentrums überstehen. Dafür reicht ein zweiter Server am selben Standort nicht. Dann richtet das Betriebsteam nach Disaster Recovery (RPO und RTO) eine Ersatzumgebung an einem zweiten Standort ein, mit eigenen Servern und einer Kopie der Daten. Fällt das ganze Rechenzentrum aus, startet das Betriebsteam das Schadenportal am zweiten Standort.
Nachteile und typische Fehler
Ein Ersatzserver in Bereitschaft kostet Geld, auch wenn er die meiste Zeit nichts tut. Der Ersatzserver muss mit jeder neuen Version des Portalprogramms und jeder Änderung der Einstellungen genauso aktualisiert werden wie Portalserver 1, sonst verhält er sich im Ernstfall anders. Die „Umschaltung“ selbst ist ein weiterer Baustein, der betrieben werden muss. Fällt die „Umschaltung“ aus, erreicht keine Anfrage mehr einen Portalserver, deshalb braucht auch die „Umschaltung“ einen Ersatz. Das Betriebsteam muss einstellen, wie oft die „Umschaltung“ prüft und nach wie vielen gescheiterten Prüfungen sie umschaltet. Prüft die „Umschaltung“ zu selten, dauert die Unterbrechung länger. Bei Servern, die Zwischenstände halten, etwa Datenbanken, ist Failover deutlich aufwendiger, weil der Ersatz den aktuellen Stand haben muss. Das Umschalten muss außerdem regelmäßig geübt werden, was geplante Testtermine und Aufwand im Betriebsteam erfordert.
Typische Fehler und woran man sie erkennt:
- Unnötiges Umschalten: Die „Umschaltung“ prüft zu empfindlich und erkennt einen Ausfall fälschlich, etwa weil eine Prüfung wegen kurzer Überlastung zu langsam beantwortet wurde. Die „Umschaltung“ schaltet dann unnötig um. Erkennbar ist das an Umschaltvorgängen in Lastspitzen, ohne dass ein Server abgestürzt ist.
- Verlorene oder doppelte Vorgänge: Portalserver 1 hat die Meldung des Wasserschadens vor dem Absturz vollständig gespeichert, nur die Bestätigung an Kunde A fehlt. Portalserver 2 prüft nach dem Umschalten nicht, ob die Meldung schon in der gemeinsamen Datenbank steht. Kunde A schickt die Meldung erneut ab, und Portalserver 2 speichert sie ein zweites Mal. Umgekehrt gehen Meldungen verloren, wenn die gemeinsame Datenbank selbst auf ihren Ersatz umschaltet und dieser Ersatz die zuletzt bestätigten Meldungen noch nicht hat. Erkennbar ist das an doppelten Schadenmeldungen oder an Meldungen, die Kunden bestätigt bekamen und die danach fehlen.
- Ungeübtes Umschalten: Das Umschalten wird nie geübt, und erst im echten Ausfall zeigt sich, dass der Ersatz falsch eingerichtet ist. Erkennbar ist das erst im Ernstfall, wenn Portalserver 2 nach dem Umschalten Fehler meldet.
- Gemeinsame Ausfallursache: Beide Portalserver hängen am selben Stromanschluss oder an derselben Datenbank ohne eigenen Ausfallschutz und fallen gemeinsam aus. Erkennbar ist das an Störungen, bei denen beide Server zur selben Zeit nicht antworten.
- Zu schwacher Ersatz: Portalserver 2 ist kleiner eingerichtet als Portalserver 1 und bricht unter der vollen Last zusammen, etwa wenn nach einem Sturm viele Kunden gleichzeitig Schäden melden. Erkennbar ist das an sehr langen Antwortzeiten unmittelbar nach dem Umschalten.
- Falsche Prüfung: Die „Umschaltung“ prüft nur, ob der Rechner eingeschaltet ist. Das Portalprogramm auf Portalserver 1 stürzt ab, während der Rechner weiterläuft. Die „Umschaltung“ schickt deshalb weiter Anfragen an Portalserver 1. Erkennbar ist das an Fehlerseiten für Kunden, während die „Umschaltung“ beide Portalserver als verfügbar führt.
Weiterführend
Verwandte Ansätze
- Health Checks: regelmäßige Zustandsabfragen, mit denen die „Umschaltung“ erkennt, ob ein Server tatsächlich Anfragen beantworten kann.
- Load Balancing: verteilt Anfragen im Normalbetrieb auf mehrere Server und überspringt ausgefallene. Sind beide Portalserver gleichzeitig aktiv, übernimmt der Lastverteiler die Aufgabe der „Umschaltung“.
- Hot, Warm and Cold Standby: unterscheidet, wie weit eine Ersatzumgebung vorbereitet ist und wie schnell sie deshalb übernehmen kann.
- Replication: hält Kopien derselben Daten auf weiteren Rechnern bereit und ist eine übliche Grundlage für den eigenen Ausfallschutz der gemeinsamen Datenbank.
- Idempotency: sorgt dafür, dass ein wiederholt abgeschickter Vorgang wie die Schadenmeldung von Kunde A nur einmal ausgeführt wird.
Quellen
- Microsoft Azure Well-Architected Framework: Architecture strategies for designing for redundancy: erklärt Redundanz mit gleichen Exemplaren, unterscheidet gleichzeitig aktive Exemplare von Bereitschaftsbetrieb und zeigt, dass die verbleibenden Exemplare die ganze Last tragen müssen.
- AWS Well-Architected Framework: REL11-BP02 Fail over to healthy resources: beschreibt das Umschalten auf funktionierende Ressourcen, die Rolle von Zustandsprüfungen und Lastverteilern, zu empfindliche Ausfallerkennung und das regelmäßige Üben des Umschaltens.