
Health Checks
Dienste melden ihren Zustand
Die Idee und ihr Nutzen
Der Schadendienst einer Versicherung, ein Programm für Schadenmeldungen, läuft sechsmal gleichzeitig, und jedes laufende Exemplar heißt Instanz. Sechs Instanzen reichen für die Anfragen zu Spitzenzeiten auch dann, wenn eine davon ausfällt. Ein Programm namens Lastverteiler nimmt die Anfragen der Kunden entgegen und gibt jede Anfrage an eine der sechs Instanzen weiter. Instanz 4 läuft noch, erreicht aber die Datenbank des Schadendienstes nicht mehr und kann deshalb keine Anfrage erfolgreich beantworten. Damit Instanz 4 keine Anfragen mehr erhält, fragt der Lastverteiler jede Instanz regelmäßig, ob sie bereit ist, Anfragen anzunehmen. Instanz 4 antwortet „nicht bereit“, und der Lastverteiler schickt neue Anfragen nur noch an die übrigen fünf Instanzen. Die Instanzen laufen auf einer Betriebsplattform, einem Programm, das die Instanzen auf den Servern startet und beendet. In einer zweiten, getrennten Prüfung fragt die Betriebsplattform jede Instanz nach einem Lebenszeichen. Reagiert eine Instanz nicht mehr, startet die Betriebsplattform diese Instanz neu. Solche regelmäßigen Zustandsabfragen heißen Health Checks, auf Deutsch Gesundheitsprüfungen.

Wie funktioniert es?
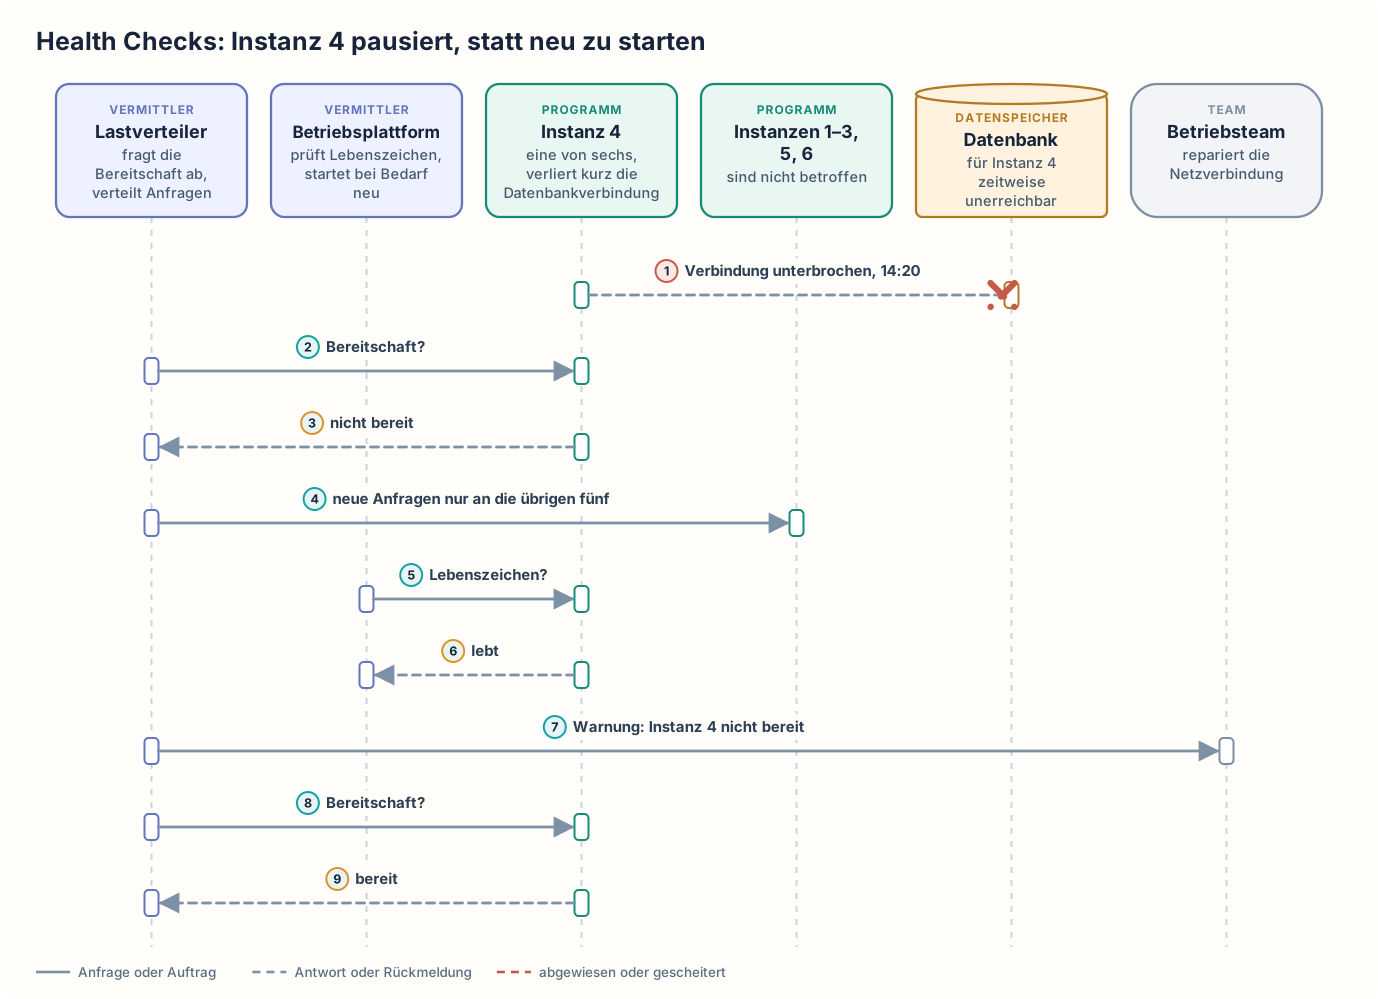
Um 14:20 Uhr fällt die Netzverbindung von Instanz 4 zur Datenbank aus. Die Instanzen 1 bis 3, 5 und 6 sind nicht betroffen. Bei der nächsten Prüfung fragt der Lastverteiler Instanz 4, ob sie bereit ist. Instanz 4 versucht dafür, die Datenbank zu erreichen, scheitert und meldet „nicht bereit“. Der Lastverteiler schickt neue Anfragen nur noch an die übrigen fünf Instanzen. Die Kunden merken davon nichts, weil fünf Instanzen für alle Anfragen ausreichen. Unabhängig davon fragt die Betriebsplattform Instanz 4 nach einem Lebenszeichen. Instanz 4 antwortet „lebt“, ohne dafür die Datenbank zu befragen. Die Betriebsplattform startet Instanz 4 deshalb nicht neu. Der Lastverteiler warnt das Betriebsteam. Das Betriebsteam untersucht die Netzverbindung und repariert sie bis 14:45 Uhr. Der Lastverteiler prüft die Bereitschaft von Instanz 4 die ganze Zeit weiter. Sobald Instanz 4 die Datenbank wieder erreicht, meldet sie „bereit“ und bekommt wieder Anfragen, ohne dass sie neu gestartet werden musste.
Für diese Prüfungen bietet jede Instanz eine Prüfadresse an, eine Adresse wie /health, unter der sie auf Anfrage ihren Zustand meldet. Der Lastverteiler und die Betriebsplattform rufen die Prüfadressen in festen Abständen auf, etwa alle fünf Sekunden. So erhält eine gestörte Instanz höchstens einige Sekunden lang noch Anfragen, und die Prüfungen belasten die Instanzen kaum. Was eine Instanz bei einer Prüfung untersucht, ist im Schadendienst programmiert. Im Lastverteiler und in der Betriebsplattform ist eingestellt, wie oft sie prüfen und wie oft eine Prüfung scheitern darf, bevor sie reagieren. Die Antwort kann Einzelheiten zur Ursache enthalten, etwa „Datenbank nicht erreichbar“. Health Checks beheben keine Störung. Sie sorgen nur dafür, dass der Lastverteiler und die Betriebsplattform von einer Störung erfahren. Die Warnung an das Betriebsteam kann statt vom Lastverteiler auch von einem gesonderten Überwachungsprogramm kommen.
Mit der Bereitschaftsprüfung, englisch Readiness, fragt der Lastverteiler, ob eine Instanz gerade Anfragen annehmen kann. Eine Instanz meldet „nicht bereit“, solange sie beim Start noch Daten vorlädt oder wenn sie eine Datenbank nicht erreicht, ohne die sie nicht arbeiten kann. Einer Instanz, die „nicht bereit“ meldet, schickt der Lastverteiler keine neuen Anfragen, lässt sie aber weiterlaufen. Mit der Lebenszeichenprüfung, englisch Liveness, fragt die Betriebsplattform nur, ob das Programm einer Instanz überhaupt noch reagiert. Scheitert diese Prüfung mehrmals hintereinander, startet die Betriebsplattform die Instanz neu. Das geschieht zum Beispiel, wenn das Programm einer Instanz in einer Endlosschleife steckt. Die Lebenszeichenprüfung darf nicht von der Datenbank oder einem anderen Dienst abhängen. Sonst würde die Betriebsplattform bei einem Ausfall der Datenbank alle sechs Instanzen gleichzeitig neu starten, obwohl ein Neustart die Datenbank nicht wieder erreichbar macht. Für Programme, die lange zum Starten brauchen, gibt es oft eine dritte Prüfung, die Startprüfung. Mit der Startprüfung fragt die Betriebsplattform, ob eine Instanz ihren Start abgeschlossen hat, beim Schadendienst also das Vorladen der Daten. Erst wenn eine Instanz die Startprüfung bestanden hat, kann eine gescheiterte Lebenszeichenprüfung einen Neustart auslösen.
Fällt eine Instanz zwischen zwei Prüfungen aus, schickt der Lastverteiler dieser Instanz bis zur nächsten Prüfung noch einzelne Anfragen. Fällt die gemeinsame Datenbank aller Instanzen aus, melden alle sechs Instanzen gleichzeitig „nicht bereit“. Dann hat der Lastverteiler keine Instanz mehr, an die er Anfragen weitergeben kann. Für diesen Fall muss festgelegt sein, welche Antwort der Lastverteiler den Kunden gibt.
Health Checks: Instanz 4 pausiert, statt neu zu starten
Wann ist es sinnvoll und wann nicht?
Health Checks lohnen sich
- Ein Dienst läuft in mehreren Instanzen, und ein Lastverteiler nimmt jede Anfrage zuerst an und gibt sie an eine der Instanzen weiter. Ohne Bereitschaftsprüfung schickt der Lastverteiler einer gestörten Instanz weiter ihren Anteil der Anfragen. Beim Schadendienst erhält dann jeder sechste Kunde eine Fehlermeldung, obwohl fünf Instanzen einwandfrei arbeiten.
- Eine Instanz nimmt weiter Netzwerkverbindungen an, obwohl sie keine Anfrage bearbeiten kann. Instanz 4 nimmt zum Beispiel weiter Anfragen entgegen, obwohl sie die Datenbank nicht erreicht. Der Lastverteiler bemerkt eine solche Störung nicht von selbst, weil die Störung sich erst bei der Bearbeitung einer Anfrage zeigt.
- Die Instanzen laufen auf einer Betriebsplattform, die Instanzen automatisch neu starten kann. Ohne Lebenszeichenprüfung bleibt eine Instanz, die in einer Endlosschleife steckt, hängen, bis jemand aus dem Betriebsteam sie bemerkt und von Hand neu startet. Mit Lebenszeichenprüfung startet die Betriebsplattform eine Instanz, die nicht mehr reagiert, ohne Eingreifen des Betriebsteams neu.
- Eine Instanz braucht beim Start einige Zeit, um Daten vorzuladen. Ohne Bereitschaftsprüfung schickt der Lastverteiler der startenden Instanz sofort Anfragen, die sie noch nicht beantworten kann. Solange die Instanz vorlädt, meldet sie bei der Bereitschaftsprüfung „nicht bereit“, und der Lastverteiler schickt ihr noch keine Anfragen.
- Die Überwachung soll Störungen früh melden. Ohne Health Checks erfährt das Betriebsteam von einer Störung oft erst durch Beschwerden von Kunden. Mit Health Checks erhält das Betriebsteam eine Warnung zu genau der Instanz, die die Datenbank nicht erreicht, und kann gezielt die Netzverbindung dieser Instanz untersuchen.
Health Checks sind nicht das Richtige
- Ein einzelnes Programm läuft ohne Lastverteiler, ohne automatischen Neustart und ohne Überwachung, die seinen Zustand abfragt. Dann wertet niemand die Antwort einer Bereitschaftsprüfung oder einer Lebenszeichenprüfung aus. Das Team baut keine Prüfadresse in das Programm ein und muss auch keine absichern.
- Die Health Checks sollen die einzige Überwachung sein. Eine Prüfadresse zeigt nur, ob eine Instanz gerade antwortet, nicht ob Kunden ihre Schadenmeldungen tatsächlich abschließen können. Das sieht das Betriebsteam erst mit Observability, also mit Messwerten, Protokollen und Ablaufspuren. Eine Ablaufspur zeichnet den Weg einer Anfrage durch mehrere Dienste auf. Observability ergänzt die Health Checks, ersetzt aber nicht die Entscheidung des Lastverteilers, die im Abstand weniger Sekunden fällt.
- Ein Dienst kann keine Prüfadresse anbieten, etwa ein gekauftes Programm, dessen Code das Team nicht ändern kann. Dann kann der Lastverteiler aus den echten Anfragen schließen, ob eine Instanz gestört ist. Häufen sich bei einer Instanz die Fehlerantworten, nimmt der Lastverteiler diese Instanz für eine Weile aus der Verteilung. Am Dienst muss dafür nichts geändert werden. Der Lastverteiler erkennt einen Fehler so allerdings erst, nachdem Kunden ihn schon erlebt haben.
Nachteile und typische Fehler
Für jeden Dienst muss festgelegt werden, was die Bereitschaftsprüfung untersucht und was die Lebenszeichenprüfung. Außerdem muss feststehen, wie oft geprüft wird und wie oft eine Prüfung scheitern darf. Eine Bereitschaftsprüfung, die jedes Mal die Datenbank abfragt, belastet die Datenbank zusätzlich, weil jede der sechs Instanzen diese Prüfung alle paar Sekunden ausführt. Die Prüfadresse muss außerdem so abgesichert werden, dass nur der Lastverteiler, die Betriebsplattform und das Überwachungsprogramm sie erreichen.
Typische Fehler und woran man sie erkennt:
- Neustart bei Datenbankausfall: Jede Instanz versucht bei der Lebenszeichenprüfung, die Datenbank zu erreichen. Fällt die gemeinsame Datenbank aus, scheitert die Lebenszeichenprüfung bei allen sechs Instanzen. Die Betriebsplattform startet dann alle sechs Instanzen gleichzeitig neu, und auch nach dem Neustart erreicht keine Instanz die Datenbank. Erkennbar ist das an vielen Neustarts zur selben Zeit, in der die Datenbank gestört ist.
- Oberflächliche Prüfung: Eine Instanz meldet unter ihrer Prüfadresse immer „bereit“, sobald das Programm läuft, ohne die Datenbank zu prüfen. Instanz 4 meldet deshalb trotz unterbrochener Netzverbindung „bereit“. Der Lastverteiler schickt Instanz 4 weiter jede sechste Anfrage, und diese Kunden erhalten eine Fehlermeldung. Erkennbar ist das an Fehlerantworten einer Instanz, die gleichzeitig „bereit“ meldet.
- Flattern: Die Bereitschaftsprüfung ist zu empfindlich eingestellt und scheitert schon bei kurzen Verzögerungen. Der Lastverteiler nimmt Instanzen ständig aus der Verteilung und wieder auf. Die übrigen Instanzen übernehmen die Anfragen der herausgenommenen Instanzen: Sind zwei der sechs Instanzen gleichzeitig herausgenommen, erhält jede der übrigen vier ein Viertel statt ein Sechstel der Anfragen, also die Hälfte mehr. Ist die Lebenszeichenprüfung zu empfindlich eingestellt, startet die Betriebsplattform Instanzen unnötig neu. Erkennbar ist das an häufigen Wechseln zwischen „bereit“ und „nicht bereit“ ohne erkennbare Störung.
- Neustartschleife beim Start: Eine Instanz braucht lange zum Vorladen ihrer Daten und antwortet währenddessen nicht auf die Lebenszeichenprüfung. Ohne Startprüfung startet die Betriebsplattform die Instanz nach einigen gescheiterten Prüfungen neu, bevor das Vorladen fertig ist. Danach beginnt das Vorladen von vorn. Erkennbar ist das an Instanzen, die immer wieder nach derselben Zeit neu starten und nie „bereit“ melden.
- Offene Prüfadresse: Die Prüfadresse ist aus dem Internet erreichbar und nennt Einzelheiten wie „Datenbank nicht erreichbar“. Angreifer erhalten so Hinweise auf den inneren Aufbau des Schadendienstes. Erkennbar ist das an Aufrufen der Prüfadresse von unbekannten Absendern.
Weiterführend
Verwandte Ansätze
- Load Balancing: beschreibt den Lastverteiler, der Instanzen mit gescheiterter Prüfung aus der Verteilung nimmt.
- Redundancy and Failover: beschreibt mehrfach vorhandene Systemteile und das Umschalten bei einem Ausfall, das solche Prüfungen voraussetzt.
- Service Discovery: ein Verzeichnis der laufenden Instanzen. Je nach System entfernt das Verzeichnis Instanzen mit gescheiterter Prüfung oder filtert sie beim Abruf heraus.
Werkzeuge und Umsetzungen
- Kubernetes Probes: Bereitschafts-, Lebenszeichen- und Startprüfung in Kubernetes, einer verbreiteten Plattform zum Betrieb von Anwendungen auf vielen Servern.
- Spring Boot Actuator: stellt in Java-Anwendungen fertige Prüfadressen bereit, die unter anderem Datenbank und Speicherplatz prüfen.
- Gatus: Überwachungsprogramm, das Prüfadressen regelmäßig abruft und eine Statusseite erzeugt.
Quellen
- Microsoft: Health Endpoint Monitoring Pattern: beschreibt Prüfadressen, den Unterschied zwischen reinen Lebenszeichen und Prüfungen, die auch Abhängigkeiten wie die Datenbank abfragen sowie Absicherung, Antwortzeiten und Last durch die Prüfungen.
- Chris Richardson: Pattern: Health Check API: erklärt, warum eine laufende Instanz trotzdem keine Anfragen bearbeiten kann, und nennt als Grenze, dass eine Instanz zwischen zwei Prüfungen ausfallen kann.