
Load Balancing
Anfragen auf mehrere laufende Instanzen verteilen
Die Idee und ihr Nutzen
Das Kundenportal einer Versicherung läuft gleichzeitig auf drei Servern, damit es viele Kunden bedienen kann und beim Ausfall eines Servers erreichbar bleibt. Kunden sollen aber nur eine Adresse kennen und nicht entscheiden müssen, welchen Server sie ansprechen. Deshalb geht jede Anfrage zuerst an den Lastverteiler, englisch Load Balancer, ein Programm, das die Anfrage annimmt und an einen der drei Server weitergibt. Ist ein Server gestört, lässt der Lastverteiler diesen Server aus. Dieses Verteilen heißt Load Balancing.

Wie funktioniert es?
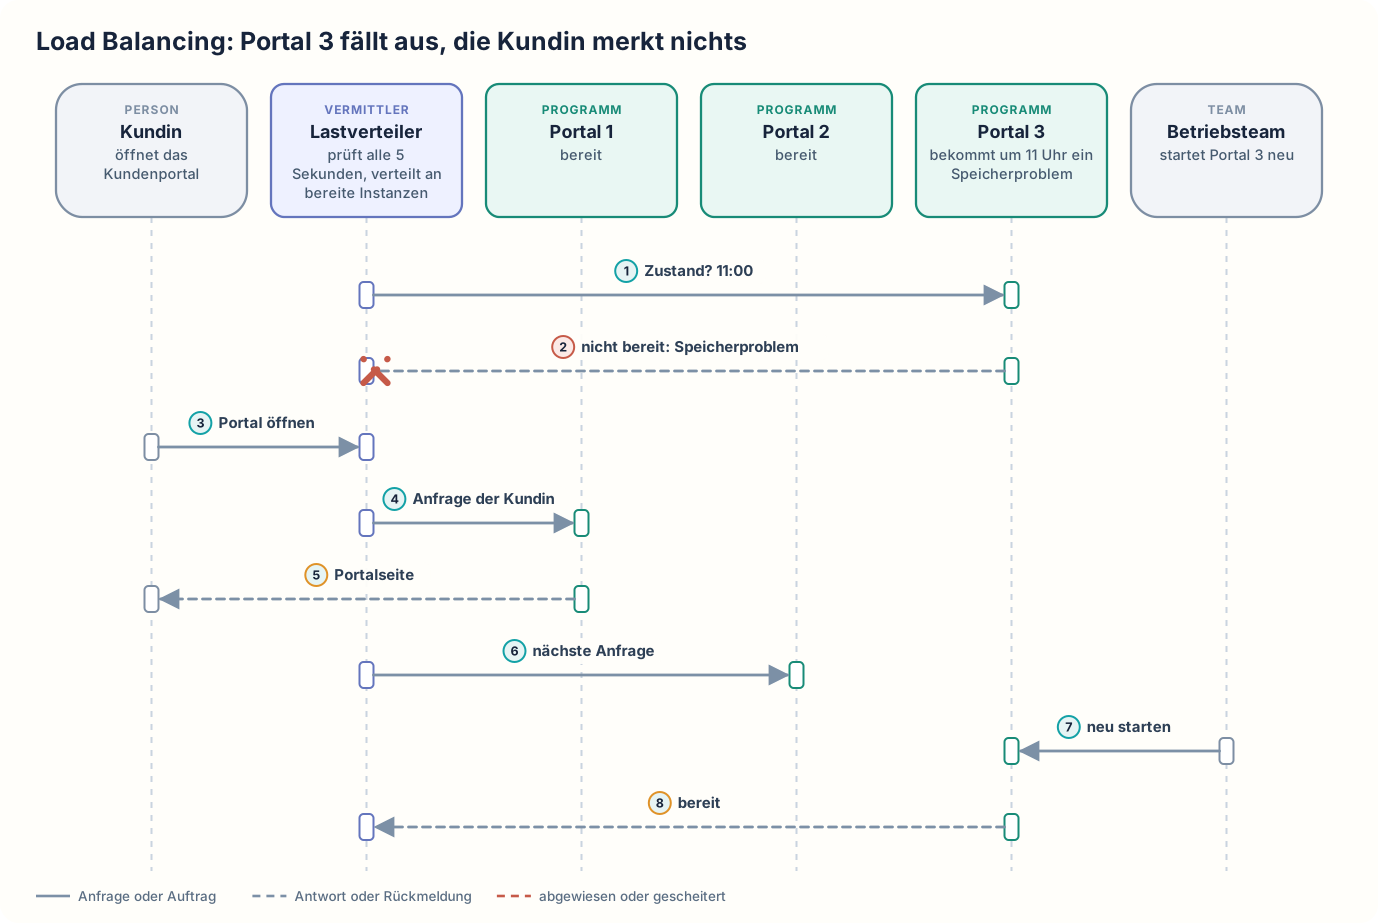
Das Kundenportal läuft als drei Instanzen auf je einem eigenen Server. Eine Instanz ist ein laufendes Exemplar eines Programms. Die drei Instanzen heißen Portal 1, Portal 2 und Portal 3. Der Lastverteiler fragt alle fünf Sekunden jede Instanz nach ihrem Zustand. So bemerkt der Lastverteiler einen Ausfall nach wenigen Sekunden, und die Abfragen belasten die Instanzen kaum. Um 11 Uhr bekommt Portal 3 ein Speicherproblem und meldet sich nicht mehr bereit. Der Lastverteiler schickt Portal 3 ab sofort keine neuen Anfragen mehr. In diesem Moment öffnet eine Kundin das Kundenportal. Ihre Anfrage geht an den Lastverteiler, und der Lastverteiler gibt die Anfrage an Portal 1 weiter und nicht an Portal 3. Portal 1 liefert die Portalseite, und die Kundin bemerkt von der Störung nichts. Die nächste Anfrage eines anderen Kunden gibt der Lastverteiler an Portal 2. Bis Portal 3 wieder bereit ist, verteilt der Lastverteiler alle Anfragen auf Portal 1 und Portal 2. Das Betriebsteam, das die Server betreut, startet Portal 3 neu. Bei der nächsten Prüfung meldet sich Portal 3 wieder bereit, und der Lastverteiler bezieht Portal 3 wieder in die Verteilung ein.
Für jede Anfrage wählt der Lastverteiler eine Instanz nach einem festgelegten Verfahren. Beim Verfahren Reihum, englisch Round Robin, kommt Portal 1 an die Reihe, dann Portal 2, dann Portal 3, dann wieder Portal 1. Bei der gewichteten Verteilung erhalten Server mit mehr Rechenleistung einen größeren Anteil der Anfragen. Beim Verfahren wenigste Verbindungen erhält die Instanz mit den wenigsten gerade laufenden Anfragen die nächste Anfrage. Bei der Verteilung nach Merkmal gehen Anfragen mit demselben Merkmal immer an dieselbe Instanz. Ein solches Merkmal ist zum Beispiel die Kundennummer. Manche Lastverteiler leiten nur Netzverbindungen weiter, ohne den Inhalt der Anfrage zu lesen. Andere Lastverteiler lesen die Webanfrage. Solche Lastverteiler können nach der aufgerufenen Seite des Kundenportals verteilen. Außerdem können solche Lastverteiler die verschlüsselte Verbindung zum Browser selbst entschlüsseln, damit die Instanzen das nicht tun müssen. Solche Lastverteiler können der Anfrage auch Angaben hinzufügen, etwa von welchem Rechner die Anfrage ursprünglich kam.
Antwortet eine Instanz auf die Zustandsabfrage gar nicht, behandelt der Lastverteiler sie wie eine Instanz, die „nicht bereit“ meldet. Anfragen, die Portal 3 im Moment des Ausfalls gerade bearbeitete, rettet der Lastverteiler nicht. Sie gehen verloren, wenn sie nicht wiederholt werden können. Bekommt der Lastverteiler von Portal 3 auf eine laufende Anfrage keine Antwort mehr, heißt das aber nicht, dass Portal 3 die Anfrage nicht ausgeführt hat. Hatte ein Kunde gerade eine Schadenmeldung abgeschickt, kann die Schadenmeldung bereits gespeichert sein. Eine solche Anfrage darf nur dann bei einer anderen Instanz wiederholt werden, wenn die Wiederholung keine zweite Schadenmeldung anlegt.
Load Balancing: Portal 3 fällt aus, die Kundin merkt nichts
Wann ist es sinnvoll und wann nicht?
Load Balancing lohnt sich
- Eine Anwendung läuft auf mehr als einem Server, weil ein Server allein nicht genug Anfragen bearbeiten kann oder weil die Anwendung einen Ausfall überstehen soll. Ein einzelner Server kann nur eine begrenzte Zahl von Anfragen gleichzeitig bearbeiten, weil seine Rechenleistung und sein Arbeitsspeicher begrenzt sind. Fällt der einzelne Server aus, ist das Kundenportal nicht mehr erreichbar.
- Ohne Lastverteiler müsste jeder Browser die Adressen aller drei Server kennen und selbst wählen. Dann landen womöglich alle Kunden beim ersten Server, während die anderen Server nichts zu tun haben. Fällt ein Server aus, schicken die Browser weiter Anfragen an diesen Server, weil sie von dem Ausfall nichts wissen.
- Die Zahl der Anfragen schwankt. Einzelne Server fallen durch ein Speicherproblem aus oder werden für eine Wartung abgeschaltet. Trotzdem sollen Kunden eine einzige Adresse verwenden, auch wenn Instanzen hinzukommen, wegfallen oder neu gestartet werden. Das Betriebsteam kann dann Portal 3 neu starten, ohne dass sich für die Kunden etwas ändert. Ohne Lastverteiler müssten die Browser von jeder Instanz erfahren, die hinzukommt oder wegfällt.
- Jede Instanz kann jede Anfrage bearbeiten, weil keine Instanz zwischen zwei Anfragen etwas nur bei sich speichert. Dann kann der Lastverteiler jede Anfrage an eine beliebige bereite Instanz geben. Solche Programme heißen Stateless Services. Ohne Lastverteiler müssten die Browser trotzdem selbst eine Instanz wählen und würden weiter Anfragen an eine ausgefallene Instanz schicken.
Load Balancing ist nicht das Richtige
- Instanzen halten Daten, die ein Kunde während seines Besuchs eingegeben hat, nur in ihrem eigenen Speicher, etwa eine halb ausgefüllte Schadenmeldung. Ein Lastverteiler, der jede Anfrage frei auf die Instanzen verteilt, gibt die nächste Anfrage dieses Kunden womöglich an eine andere Instanz, und dort fehlt die halb ausgefüllte Schadenmeldung. Stattdessen stellt das Betriebsteam den Lastverteiler so ein, dass er einen Kunden immer an dieselbe Instanz leitet. Diese feste Zuordnung heißt Sticky Sessions. So findet der Kunde seine halb ausgefüllte Schadenmeldung bei jeder Anfrage wieder. Die Last verteilt sich dabei ungleichmäßig, weil ein Kunde mit vielen Anfragen bei seiner Instanz bleibt. Fällt diese Instanz aus, ist die halb ausgefüllte Schadenmeldung trotzdem verloren.
- Die Anwendung läuft nur auf einem einzigen Server, und ein zweiter ist nicht geplant. Dann rufen die Browser den Server direkt unter seiner Adresse auf. Das Betriebsteam muss keinen Lastverteiler einrichten, aktualisieren und überwachen. Reicht der Server nicht mehr aus und ist keine Ausfallsicherheit nötig, ersetzt das Betriebsteam den Server durch einen mit mehr Rechenleistung und Arbeitsspeicher, wie bei Vertical versus Horizontal Scaling beschrieben.
- Das Kundenportal antwortet zu langsam, und der Engpass liegt in der gemeinsamen Datenbank, auf die Portal 1, Portal 2 und Portal 3 zugreifen. Weitere Instanzen, an die der Lastverteiler Anfragen verteilt, schicken dann nur noch mehr Abfragen an die Datenbank, und die Antworten werden nicht schneller. Stattdessen entlastet das Betriebsteam zuerst die Datenbank, etwa indem es Abfragen nur zum Lesen auf Kopien der Datenbank verteilt (Read Replicas). Die Versicherung bezahlt so keine weiteren Server für Instanzen, die die Antworten nicht schneller machen.
- Es ist hinnehmbar, dass manche Kunden nach dem Ausfall eines Servers eine Zeit lang Fehlerseiten sehen. Dann trägt das Betriebsteam im Domain Name System, abgekürzt DNS, unter dem Namen des Kundenportals die Adressen aller drei Server ein. DNS ist der Dienst, der Namen wie die Adresse des Kundenportals in Serveradressen übersetzt. Ein Lastverteiler, den das Betriebsteam einrichten und überwachen müsste, entfällt. Browser und Netze speichern die erhaltenen Adressen aber eine Zeit lang zwischen. Nach einem Ausfall schicken Browser deshalb weiter Anfragen an den ausgefallenen Server, bis die Frist für das Zwischenspeichern abgelaufen ist.
- Ein Dienst innerhalb des Rechenzentrums ruft einen anderen Dienst auf. Ein Lastverteiler wäre dann ein zusätzliches Programm, an das jede interne Anfrage zuerst geht und das das Betriebsteam ausfallsicher betreiben muss. Stattdessen erfragt das aufrufende Programm die Adressen der Instanzen bei einem Verzeichnis der laufenden Instanzen und wählt selbst eine Instanz aus. Dafür gibt es Service Discovery. Das Verzeichnis prüft regelmäßig, ob jede Instanz noch antwortet, und streicht ausgefallene Instanzen. Die Anfrage geht dann direkt an die gewählte Instanz, und der Lastverteiler entfällt.
Nachteile und typische Fehler
Jede Anfrage läuft zusätzlich über den Lastverteiler, deshalb muss der Lastverteiler selbst ausfallsicher betrieben werden. Üblich ist ein zweites Exemplar desselben Lastverteilers auf einem eigenen Server. Fällt der erste Lastverteiler aus, übernimmt der zweite dessen Adresse, sodass die Kunden weiterhin dieselbe Adresse verwenden. Beide Lastverteiler müssen eingerichtet, aktualisiert und überwacht werden. Das Betriebsteam muss passend zur Anwendung festlegen, wie oft der Lastverteiler die Instanzen nach ihrem Zustand fragt, wann eine Instanz als gestört gilt und wann wieder als bereit. Der Lastverteiler schafft außerdem keine zusätzliche Rechenleistung. Die Instanzen brauchen deshalb genug Reserve, damit Portal 1 und Portal 2 die Anfragen von drei Instanzen bearbeiten können, wenn Portal 3 ausfällt. Für diese Reserve bezahlt die Versicherung im Normalbetrieb Server, die nicht voll ausgelastet sind.
Typische Fehler und woran man sie erkennt:
- Falsch eingestellte Zustandsabfragen: Der Lastverteiler nimmt bereite Instanzen aus der Verteilung oder lässt gestörte darin. Wartet der Lastverteiler zum Beispiel nur eine halbe Sekunde auf die Antwort auf seine Zustandsabfrage, gilt Portal 2 schon als gestört, wenn Portal 2 unter vielen Anfragen etwas langsamer antwortet. Prüft die Zustandsabfrage nur, ob das Programm läuft, meldet sich Portal 2 auch dann bereit, wenn Portal 2 die Datenbank nicht mehr erreicht und jede Anfrage mit einer Fehlerseite beantwortet. Erkennbar ist das an Instanzen, die ständig zwischen „bereit“ und „nicht bereit“ wechseln, oder an Fehlerseiten, obwohl der Lastverteiler alle Instanzen als bereit führt.
- Anfragen mit ungleicher Rechenzeit: Manche Anfragen brauchen viel mehr Rechenzeit als andere. Beim Verfahren Reihum erhält jede Instanz trotzdem jede dritte Anfrage. Erhält Portal 1 dabei mehrere dieser aufwendigen Anfragen kurz nacheinander, rechnet Portal 1 noch daran, während Portal 2 und Portal 3 schon frei sind. Weitere Anfragen an Portal 1 warten in dieser Zeit. Erkennbar ist das an einer Instanz mit hoher Auslastung, obwohl alle Instanzen gleich viele Anfragen erhalten.
- Lange offene Verbindungen: Manche Verbindungen bleiben lange offen, zum Beispiel für Anzeigen, die sich laufend aktualisieren. Der Lastverteiler gibt eine solche Verbindung beim Öffnen an eine Instanz, und dort bleibt die Verbindung, bis der Browser sie schließt. Startet das Betriebsteam eine vierte Instanz, erhält Portal 4 nur Verbindungen, die Browser danach neu öffnen. Die offenen Verbindungen bleiben bei Portal 1, Portal 2 und Portal 3, und die Last verteilt sich nur langsam um. Erkennbar ist das an einer neu gestarteten Instanz, die kaum Anfragen erhält.
- Zu knappe Reserve: Portal 1 und Portal 2 schaffen die Anfragen von drei Instanzen nicht. Ist zum Beispiel jede Instanz im Normalbetrieb zu 80 Prozent ausgelastet, verteilt der Lastverteiler nach dem Ausfall von Portal 3 dreimal 80 Prozent auf zwei Instanzen. Auf Portal 1 und Portal 2 kommen dann je 120 Prozent dessen, was eine Instanz bearbeiten kann. Portal 1 und Portal 2 antworten dann immer langsamer, bis auch sie sich nicht mehr bereit melden. Erkennbar ist das an steigenden Antwortzeiten kurz nach dem Ausfall einer einzelnen Instanz.
- Einzelner Lastverteiler: Es gibt keinen zweiten Lastverteiler, und der einzige fällt aus. Erkennbar ist das, wenn das Kundenportal nicht erreichbar ist, obwohl alle drei Instanzen laufen.
Weiterführend
Verwandte Ansätze
- Reverse Proxy: ein Programm, das Anfragen stellvertretend für interne Server annimmt. Viele Lastverteiler sind zugleich ein Reverse Proxy.
- Health Checks: die Zustandsabfragen, an denen der Lastverteiler bereite Instanzen erkennt.
- Consistent Hashing: ein Verfahren zum Verteilen nach Merkmal, bei dem beim Hinzufügen oder Wegfallen einer Instanz nur wenige Zuordnungen wechseln.
Werkzeuge und Umsetzungen
- HAProxy: Lastverteiler für Netzverbindungen und Webanfragen.
- NGINX: Webserver, der auch als Lastverteiler arbeitet.
- Envoy: ein Programm, das Verbindungen stellvertretend annimmt und weiterleitet, mit vielen Verteilverfahren und laufender Zustandsprüfung.
- Traefik: Lastverteiler, der neue Dienste in Umgebungen mit Containern automatisch erkennt. Ein Container ist ein abgeschlossenes Paket aus einem Programm und allem, was das Programm zum Laufen braucht.
- Keepalived: sorgt dafür, dass ein zweiter Lastverteiler bei Ausfall des ersten dessen Adresse übernimmt.
Quellen
- Microsoft: Load-balancing options: unterscheidet Lastverteiler, die nur Netzverbindungen weiterleiten, von solchen, die Webanfragen lesen, und nennt die Überwachung der Instanzen als Auswahlkriterium.
- AWS: How Elastic Load Balancing works: beschreibt, wie ein Lastverteiler den Zustand seiner Ziele prüft, Anfragen nur an gesunde Ziele schickt und welche Verteilverfahren er dafür nutzt.
- HAProxy: Backends: Dokumentation der Verteilverfahren Reihum, wenigste Verbindungen und Verteilung nach Merkmal sowie der Zustandsprüfung einzelner Server.