
Vertical versus Horizontal Scaling
Größere Maschine oder mehr Maschinen
Die Idee und ihr Nutzen
Das Portal einer Versicherung, über das Kunden Schäden melden, läuft auf einem einzigen Portalserver mit 4 Prozessorkernen, also 4 Recheneinheiten, die gleichzeitig arbeiten können. Am Montagmorgen melden besonders viele Kunden Schäden. Dann ist dieser Server überlastet, die Seiten laden langsam, und manche Kunden brechen die Schadenmeldung ab. Das Team, das das Portal betreibt, kann den Portalserver durch einen stärkeren Rechner ersetzen, zum Beispiel mit 32 Prozessorkernen und mehr Arbeitsspeicher. Oder es stellt mehrere gleichwertige Portalserver nebeneinander, auf denen jeweils dasselbe Portal läuft, und ein Lastverteiler verteilt die Anfragen der Kunden auf sie. Beides heißt Skalieren: Das System wird so erweitert, dass es eine wachsende Zahl von Anfragen bewältigt. Den Portalserver durch einen stärkeren zu ersetzen, heißt vertikale Skalierung. Zusätzliche Portalserver danebenzustellen, heißt horizontale Skalierung.

Wie funktioniert es?
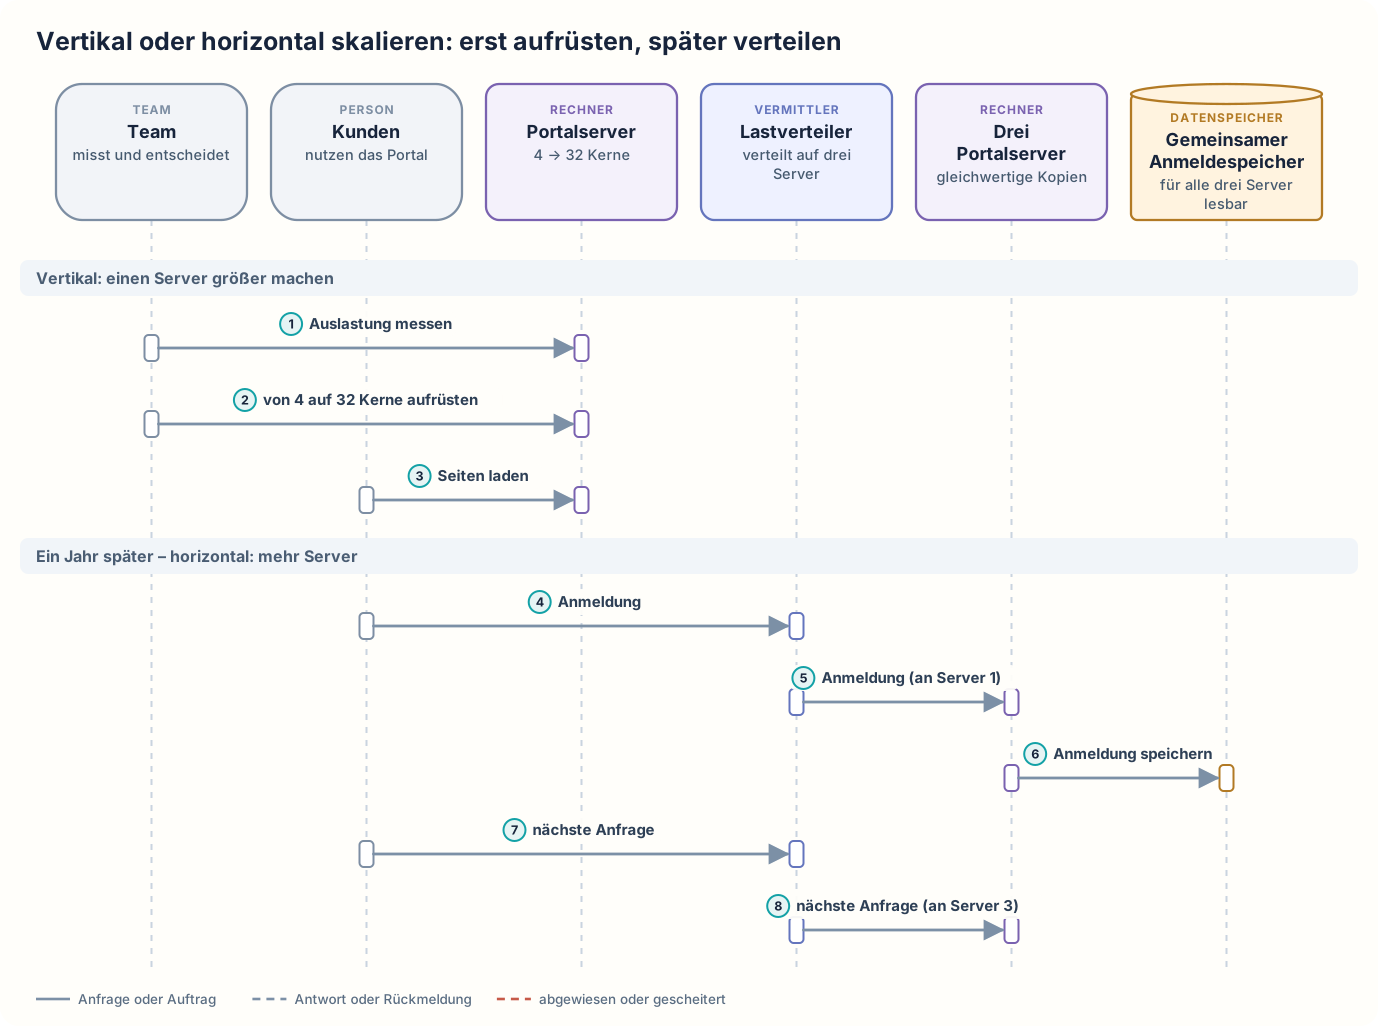
Am Montagmorgen zwischen 8 und 10 Uhr misst das Team, wie stark der Portalserver, die Datenbank des Portals und das Netzwerk ausgelastet sind und in welchem Teil des Systems die Anfragen der Kunden am längsten warten. Der Portalserver ist zu 95 Prozent ausgelastet, die Datenbank nur zu 40 Prozent. Der Portalserver ist also der Engpass, der Teil, der das ganze System bremst. Das Team rüstet ihn von 4 auf 32 Kerne auf. 32 Kerne hat der größte Rechner, den das Rechenzentrum der Versicherung anbietet. Weil jeder Prozessorkern für sich rechnet, bearbeitet ein Portalserver mit 32 Kernen mehr Anfragen gleichzeitig als einer mit 4 Kernen. Das Portal läuft dabei unverändert auf einem einzigen Server, und die Seiten laden für die Kunden wieder so schnell wie an ruhigen Tagen, bis die Last die Grenze des stärksten verfügbaren Rechners erreicht.
Ein Jahr später hat sich die Zahl der Kunden verdoppelt, und auch der aufgerüstete Portalserver stößt an seine Grenze. Außerdem soll das Portal den Ausfall eines Servers überstehen. Das Team betreibt deshalb drei gleichwertige Portalserver, Server 1 bis Server 3. Jede Anfrage eines Kunden geht zuerst an einen Lastverteiler, der sie an einen der drei Portalserver weiterschickt. Drei Server sind es, damit beim Ausfall eines Servers die beiden übrigen die Last tragen können, solange jeder höchstens zu zwei Dritteln ausgelastet ist; bei nur zwei Servern dürfte jeder höchstens halb ausgelastet sein. Ein Kunde meldet sich an, und der Lastverteiler schickt diese Anfrage an Server 1. Server 1 legt die Anmeldung nicht nur in seinem eigenen Arbeitsspeicher ab, sondern im gemeinsamen Anmeldespeicher, den alle drei Portalserver lesen können. Die nächste Anfrage des Kunden schickt der Lastverteiler an Server 3. Server 3 liest die Anmeldung aus dem gemeinsamen Anmeldespeicher, und der Kunde bleibt angemeldet.
Erst die Messung während der Lastspitze zeigt, welcher Teil des Systems der Engpass ist. Bei der horizontalen Skalierung läuft auf jedem der drei Portalserver ein Exemplar desselben Portals. Der Lastverteiler ist ein Programm, das die Anfragen der Kunden annimmt und jede an einen der drei Portalserver schickt. Der gemeinsame Anmeldespeicher hält fest, welche Kunden angemeldet sind. Deshalb spielt es keine Rolle, welcher Portalserver eine Anfrage bearbeitet. Zusätzliche Portalserver helfen nur, wenn alle auf die benötigten Daten zugreifen können, also auf die Anmeldungen im gemeinsamen Anmeldespeicher und auf die Schadenfälle in der Datenbank. Außerdem muss das Team regeln, was passiert, wenn zwei Portalserver gleichzeitig denselben Datensatz ändern, etwa denselben Schadenfall.
Fällt einer der drei Portalserver aus, schickt der Lastverteiler neue Anfragen nur noch an die beiden anderen, sofern er den Ausfall bemerkt. Die Kunden bleiben angemeldet, weil die beiden anderen Portalserver die Anmeldungen aus dem gemeinsamen Anmeldespeicher lesen. Anfragen, die der ausgefallene Portalserver gerade bearbeitete, gehen allerdings verloren, und die Kunden müssen sie wiederholen. Mehrere Portalserver machen das Portal also nur dann ausfallsicher, wenn der Lastverteiler den Ausfall erkennt und die übrigen Portalserver die Last allein tragen können. Bei der vertikalen Skalierung gibt es nur einen Portalserver. Fällt dieser Portalserver aus, ist das ganze Portal nicht erreichbar.
Vertikal oder horizontal skalieren: erst aufrüsten, später verteilen
Wann ist es sinnvoll und wann nicht?
Vertikale Skalierung passt
- Die Messung zeigt den Portalserver als Engpass, und ein stärkerer Rechner ist verfügbar und bezahlbar. Die vertikale Skalierung ist dann oft der erste Schritt, weil das Portal dafür nicht umgebaut werden muss. Für die horizontale Skalierung bräuchte das Team zusätzlich einen Lastverteiler und den gemeinsamen Anmeldespeicher.
- Das Portal hält Anmeldungen oder andere Angaben über Kunden nur im Arbeitsspeicher eines Servers, und das lässt sich nicht ändern. Mit mehreren Portalservern müsste sich ein Kunde dann neu anmelden, sobald seine nächste Anfrage bei einem anderen Portalserver landet. Das verhindern nur Sticky Sessions, bei denen der Lastverteiler jeden Kunden immer an denselben Portalserver schickt. Fällt dieser Portalserver aus, sind die Anmeldungen seiner Kunden trotzdem verloren. Ein einzelner stärkerer Portalserver kommt ohne diese Zuordnung aus.
Vertikale Skalierung passt nicht
- Schon der stärkste verfügbare Rechner arbeitet an seiner Grenze. Dann stellt das Team zusätzliche Portalserver neben den vorhandenen, und ein Lastverteiler verteilt die Anfragen auf alle. Weitere Portalserver kann das Team hinzufügen, solange die Datenbank und der gemeinsame Anmeldespeicher die Last tragen.
- Das Portal muss den Ausfall eines Servers überstehen. Mit nur einem Portalserver ist das ganze Portal bei dessen Ausfall nicht erreichbar, auch wenn dieser Portalserver 32 Kerne hat. Dann betreibt das Team mehrere Portalserver, auf die ein Lastverteiler die Anfragen verteilt. Fällt ein Portalserver aus, schickt der Lastverteiler die neuen Anfragen an die übrigen, und das Portal bleibt erreichbar.
- Die hohe Last tritt nur zu bestimmten Zeiten auf, etwa montags zwischen 8 und 10 Uhr. Ein stärkerer Portalserver liefe dann die ganze Woche, obwohl er nur in diesen Stunden gebraucht wird. Stattdessen richtet das Team Autoscaling ein: Ein Programm startet zusätzliche Portalserver automatisch, sobald die Last steigt, und beendet sie wieder, wenn die Last sinkt. Die zusätzlichen Portalserver laufen dann nur in diesen Stunden, statt dass das Team die ganze Woche einen stärkeren Portalserver oder drei Portalserver betreibt.
- Der Engpass liegt in einem anderen Teil des Systems, etwa in der Datenbank. Dann hilft weder ein stärkerer noch ein zusätzlicher Portalserver. Das Team richtet dann Lesekopien der Datenbank ein, auf die die Portalserver ihre Leseanfragen verteilen; das heißt Read Replicas. Oder das Portal hält häufig gelesene Daten in einem Zwischenspeicher bereit und fragt die Datenbank seltener; das heißt Caching. Beides entlastet die Datenbank, ohne dass das Team Portalserver aufrüstet oder hinzufügt.
Nachteile und typische Fehler
Bei der vertikalen Skalierung sind große Rechner teuer, und sehr große Rechner werden überproportional teuer: Ein Rechner mit doppelt so vielen Prozessorkernen kostet mehr als doppelt so viel. Der Umzug auf einen stärkeren Rechner erfordert oft eine kurze Unterbrechung. Die horizontale Skalierung setzt voraus, dass das Portal auf mehreren Rechnern gleichzeitig laufen kann. Mit dem Lastverteiler und dem gemeinsamen Anmeldespeicher kommen Bausteine hinzu, die das Team betreiben und überwachen muss, und jeder weitere Rechner erhöht diesen Aufwand. Auf den gemeinsamen Anmeldespeicher sind alle Portalserver angewiesen. Ist der gemeinsame Anmeldespeicher gestört, können die Portalserver keine Anmeldung mehr lesen. Jeder zusätzliche Portalserver öffnet außerdem eigene Verbindungen zur Datenbank und erhöht so die Last auf der Datenbank.
Typische Fehler und woran man sie erkennt:
- Falscher Engpass: Das Team bestellt mehr Portalserver, obwohl alle Portalserver auf eine überlastete Datenbank warten. Das Portal bleibt auch mit zehn Servern langsam. Jeder zusätzliche Portalserver öffnet eigene Verbindungen zur Datenbank, und die überlastete Datenbank muss noch mehr Verbindungen bedienen. Erkennbar ist das an einer Datenbank nahe voller Auslastung, während die Portalserver kaum etwas zu tun haben.
- Anmeldung im Arbeitsspeicher: Die Anmeldung eines Kunden liegt nur im Arbeitsspeicher des Servers, den der Lastverteiler zuerst gewählt hat. Landet die nächste Anfrage auf einem anderen Server, muss sich der Kunde neu anmelden. Erkennbar ist das an Kunden, die mitten in der Schadenmeldung wieder auf der Anmeldeseite landen.
- Gleichzeitige Änderungen: Ein Kunde schickt kurz hintereinander zwei Ergänzungen zu seinem Schadenfall, zum Beispiel aus zwei Browserfenstern. Der Lastverteiler schickt die erste Ergänzung an Server 1 und die zweite an Server 2. Beide Portalserver lesen den Schadenfall im selben Stand, ergänzen ihn und speichern ihn zurück. Die zweite Speicherung überschreibt die erste Ergänzung, ohne dass es jemand bemerkt. Erkennbar ist das an fehlenden Angaben in Schadenfällen, die Kunden nachweislich eingegeben haben.
- Zu knapp bemessen: Drei Portalserver tragen die Last am Montagmorgen nur gemeinsam. Ist jeder der drei Portalserver dann zu 80 Prozent ausgelastet, müssten die beiden übrigen nach einem Ausfall je 120 Prozent tragen. Sie sind überlastet, und das Portal wird trotzdem langsam. Erkennbar ist das an einer Auslastung jedes Servers, die im Normalbetrieb schon über zwei Dritteln liegt.
Weiterführend
Verwandte Ansätze
- Load Balancing: beschreibt, wie der Lastverteiler die Anfragen auf die drei Portalserver verteilt und ausgefallene Server erkennt.
- Stateless Services: Dienste, die keine Angaben über einzelne Kunden im eigenen Arbeitsspeicher halten. Erst so kann jeder der drei Portalserver jede Anfrage bearbeiten.
Quellen
- Microsoft: Design to scale out: begründet, warum jedes Exemplar einer Anwendung jede Anfrage bearbeiten können soll, warum Anmeldungen nicht im Arbeitsspeicher eines Servers liegen sollen und warum zusätzliche Webserver nicht helfen, wenn die Datenbank der Engpass ist.
- Microsoft: Architecture strategies for optimizing scaling and partitioning: unterscheidet das Vergrößern eines vorhandenen Rechners vom Hinzufügen weiterer Rechner und beschreibt, wie Anmeldungen in einen gemeinsamen Speicher ausgelagert werden.