
Read Replicas
Lesende Anfragen auf Kopien verteilen
Die Idee und ihr Nutzen
Die Datenbank des Schadenportals einer Versicherung speichert neue Schadenmeldungen, beantwortet sehr viele Suchanfragen und liefert die Daten für Berichte. Während ein großer Bericht läuft, dauert das Speichern einer neuen Schadenmeldung spürbar länger. Neben dieser Datenbank, der Hauptdatenbank, laufen deshalb eine oder mehrere zusätzliche Datenbanken, die fortlaufend alle Änderungen der Hauptdatenbank übernehmen. Speichert die Hauptdatenbank eine neue Schadenmeldung, steht diese Schadenmeldung kurz darauf auch in jeder zusätzlichen Datenbank. Suchseiten und Berichte lesen aus diesen zusätzlichen Datenbanken, und die Hauptdatenbank hat mehr Rechenleistung für das Speichern neuer Daten frei. Solche zusätzlichen Datenbanken heißen Read Replicas, auf Deutsch Lesekopien, weil die Anwendung aus ihnen nur liest und nie in sie schreibt.

Wie funktioniert es?
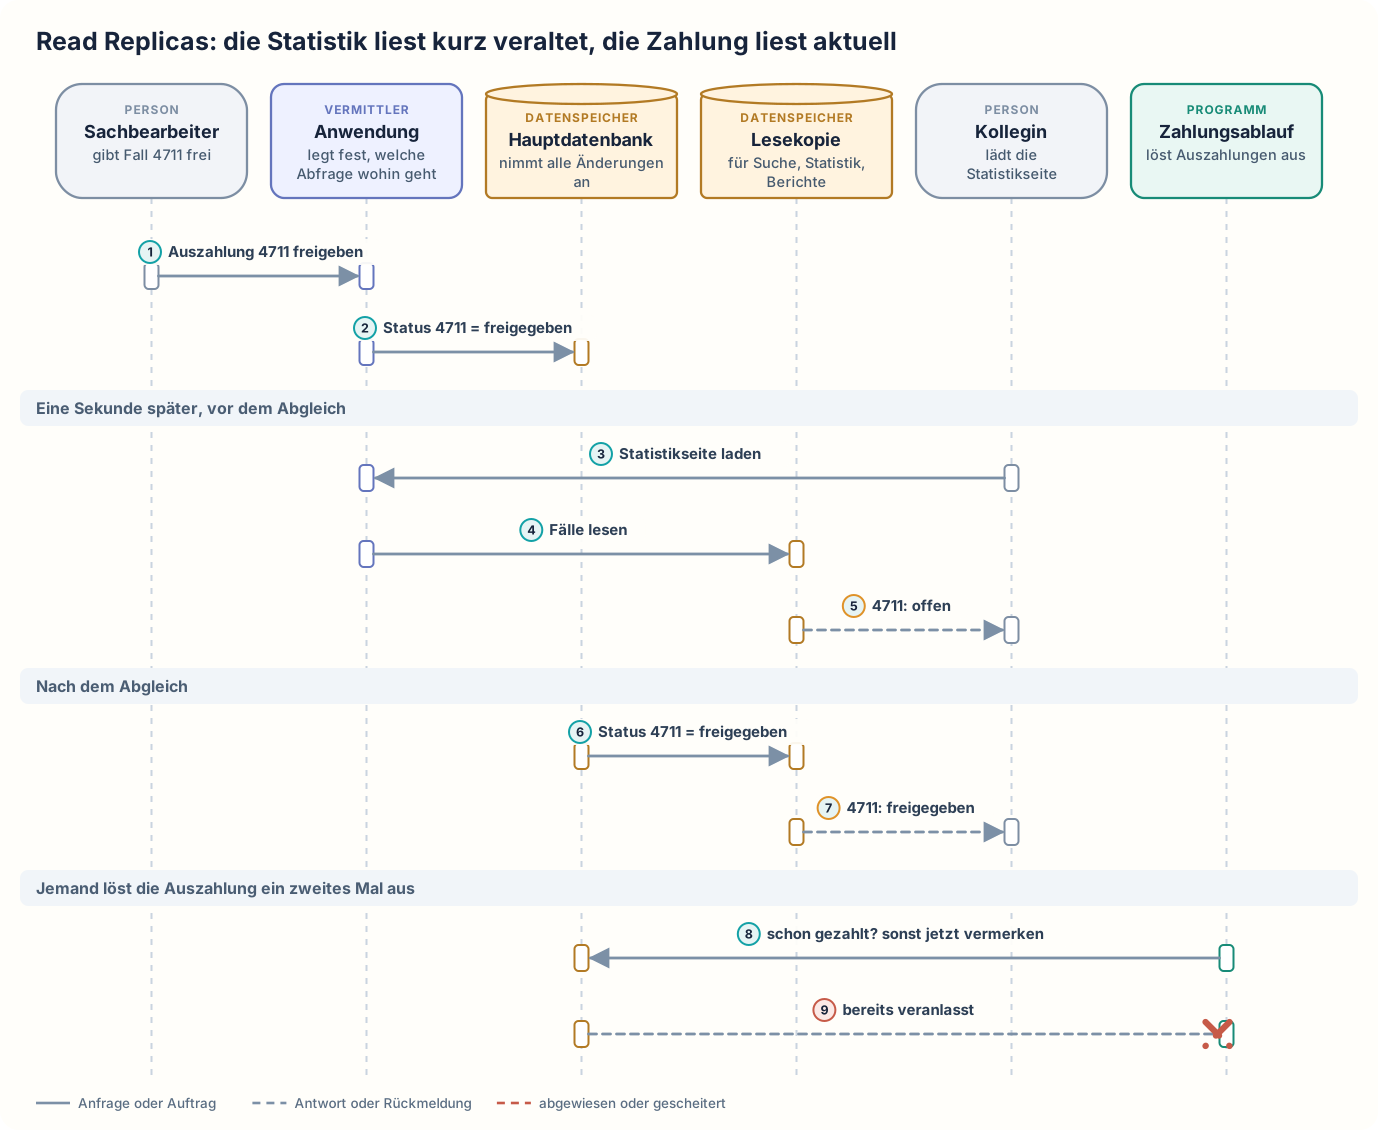
Die Anwendung des Schadenportals legt fest, welche Abfrage an welche Datenbank geht. Ein Sachbearbeiter gibt die Auszahlung für Fall 4711 frei. Die Anwendung speichert den Status „freigegeben“ nur in der Hauptdatenbank. Eine Sekunde später lädt eine Kollegin des Sachbearbeiters die Statistikseite. Die Anwendung liest dafür von der Lesekopie, weil das Team des Schadenportals für die Statistikseite einen kurz veralteten Stand ausdrücklich zugelassen hat. Die Lesekopie hat die Änderung noch nicht übernommen und meldet für Fall 4711 noch „offen“. Kurz darauf überträgt die Hauptdatenbank die Änderung an die Lesekopie, und die Statistikseite zeigt nun ebenfalls „freigegeben“. Danach versucht jemand, die Auszahlung für Fall 4711 ein zweites Mal auszulösen. Der Zahlungsablauf ist das Programm, das Auszahlungen auslöst. Der Zahlungsablauf verlässt sich nicht auf die Lesekopie. Der Zahlungsablauf prüft an der Hauptdatenbank, ob für diesen Zahlungsauftrag bereits eine Zahlung veranlasst wurde, und hält die Zahlung dort fest, falls noch keine veranlasst ist. Prüfen und Festhalten erledigt der Zahlungsablauf in einem einzigen Schritt, den die Hauptdatenbank gegen gleichzeitige Zugriffe schützt: Solange dieser Schritt läuft, kann keine zweite Auszahlungsanfrage für Fall 4711 prüfen, ob schon gezahlt wurde. Die Hauptdatenbank meldet „bereits veranlasst“, und die zweite Auszahlung wird nicht ausgelöst.
Eine Lesekopie enthält dieselben Tabellen und Daten wie die Hauptdatenbank und läuft auf einem eigenen Rechner. Die Hauptdatenbank bleibt die einzige Datenbank, in der das Schadenportal Daten speichert oder ändert. Die Hauptdatenbank überträgt jede Änderung an die Lesekopien, meist ohne darauf zu warten, dass eine Lesekopie die Änderung übernommen hat. Diese Art der Übertragung heißt asynchron. Dadurch liegt jede Lesekopie immer ein wenig hinter der Hauptdatenbank zurück, im Normalfall um Sekundenbruchteile bis wenige Sekunden, bei hoher Last oder Netzstörungen auch deutlich länger. Wie weit eine Lesekopie zurückliegt, heißt Rückstand. Das Team des Schadenportals misst den Rückstand laufend. Wächst der Rückstand über eine festgelegte Grenze, nimmt das Team die Lesekopie aus der Nutzung, bis sie aufgeholt hat.
Welche Abfrage von einer Lesekopie lesen darf, legt das Team des Schadenportals für jede Art von Abfrage ausdrücklich fest. Für Suchseiten, Statistiken und Berichte ist ein kurz veralteter Stand meist unproblematisch, deshalb lesen sie von einer Lesekopie. Für die Entscheidung, ob eine Auszahlung schon veranlasst wurde, kann ein veralteter Stand dagegen zu einer doppelten Auszahlung führen. Vor solchen Entscheidungen liest die Anwendung von der Hauptdatenbank. Das Lesen an der Hauptdatenbank allein würde aber keine doppelte Auszahlung verhindern: Kämen zwei Auszahlungsanfragen gleichzeitig, könnten beide „noch nicht gezahlt“ lesen und dann beide eine Zahlung auslösen.
Read Replicas: die Statistik liest kurz veraltet, die Zahlung liest aktuell
Wann ist es sinnvoll und wann nicht?
Read Replicas lohnen sich
- Eine Anwendung liest viel mehr, als sie schreibt. Im Schadenportal kommen zum Beispiel auf jede neue Schadenmeldung viele Suchanfragen. Ohne Lesekopien beantwortet die Hauptdatenbank alle Suchanfragen und hat weniger Rechenleistung für das Speichern neuer Schadenmeldungen frei. Mit Lesekopien schickt die Anwendung die Suchanfragen an die Lesekopien.
- Für einen großen Teil der Leseanfragen reicht ein kurz veralteter Stand aus. Beispiele sind Suchseiten, Übersichten und Berichte. Ohne Lesekopien gehen auch diese Leseanfragen an die Hauptdatenbank, obwohl ihnen ein Stand von vor einigen Sekunden genügen würde.
- Lange laufende Berichte verlangsamen das Speichern neuer Daten auf der Hauptdatenbank. Ein Monatsbericht für die Sachbearbeitung liest zum Beispiel Hunderttausende Schadenfälle auf einmal. Liest der Monatsbericht von einer Lesekopie, wird das Speichern neuer Schadenmeldungen während des Berichts nicht mehr spürbar langsamer.
- Es kommen immer mehr Suchanfragen hinzu. Ohne Lesekopien muss das Team des Schadenportals die Hauptdatenbank auf einen immer größeren Rechner setzen, und ein einzelner Rechner lässt sich nicht beliebig vergrößern. Mit Lesekopien kann das Team des Schadenportals weitere Lesekopien einrichten, statt die Hauptdatenbank selbst zu vergrößern.
- Für einen Ausfall der Hauptdatenbank soll ein fast aktueller Datenbestand bereitstehen. Ohne Lesekopie muss das Team die Hauptdatenbank aus der letzten Sicherung wiederherstellen, und alle Änderungen seit dieser Sicherung fehlen. Eine Lesekopie kann dann die Rolle der Hauptdatenbank übernehmen, wenn vorher festgelegt ist, wer diesen Wechsel auslöst und wie die Anwendung danach ihre Änderungen an die bisherige Lesekopie schickt.
Read Replicas sind nicht das Richtige
- Die Hauptdatenbank ist vor allem durch Schreibvorgänge überlastet. Lesekopien machen das Schreiben nicht schneller, denn jede Lesekopie muss alle Schreibvorgänge ebenfalls übernehmen. Dann teilt das Team des Schadenportals die Daten nach Sharding auf mehrere Datenbanken auf. Jede dieser Datenbanken speichert nur die Änderungen ihres Teils der Daten, und keine Datenbank muss alle Schreibvorgänge bewältigen.
- Die Anwendung kann nicht für jede Art von Abfrage festlegen, ob die Abfrage von einer Lesekopie lesen darf, zum Beispiel weil die Suchseite und der Zahlungsablauf dieselbe Abfrage nutzen. Dann liest die Anwendung weiterhin alle Daten von der Hauptdatenbank, und das Team des Schadenportals setzt die Hauptdatenbank bei Bedarf auf einen Rechner mit mehr Rechenleistung. Schickte die Anwendung stattdessen alle lesenden Anfragen an Lesekopien, könnte zum Beispiel der Zahlungsablauf nach einem veralteten Stand eine zweite Auszahlung auslösen.
- Die meisten Leseanfragen betreffen immer wieder dieselben Daten, etwa häufig aufgerufene Schadenakten. Eine Lesekopie hielte für diese wenigen Schadenakten eine vollständige Kopie aller Daten auf einem weiteren Rechner bereit. Dann richtet das Team des Schadenportals nach Caching einen Zwischenspeicher ein, der häufig gelesene Daten im Arbeitsspeicher bereithält. Die Anwendung liest eine häufig aufgerufene Schadenakte dann meist aus dem Zwischenspeicher statt aus der Hauptdatenbank. Ein weiterer Rechner mit einer vollständigen Kopie aller Daten entfällt. Ein Monatsbericht über Hunderttausende Fälle liest dagegen jeden Fall nur einmal und findet im Zwischenspeicher kaum etwas.
- Berichte brauchen die Daten anders geordnet als in den Tabellen der Anwendung, oder sie führen Daten aus mehreren Systemen zusammen. Eine Lesekopie enthält dagegen nur die Daten des Schadenportals, und zwar in denselben Tabellen wie die Hauptdatenbank. Dann richtet die Versicherung ein Data Warehouse ein, eine eigene Datenbank für Auswertungen. Das Data Warehouse übernimmt die Daten regelmäßig aus dem Schadenportal und den übrigen Systemen und speichert sie so, wie die Berichte sie brauchen. Die Berichte müssen die Daten dann nicht bei jedem Aufruf selbst aus mehreren Systemen zusammensuchen und umrechnen.
Nachteile und typische Fehler
Jede Lesekopie läuft auf einem eigenen Rechner, der betrieben, überwacht und bezahlt werden muss. Die Regeln, welche Abfrage von einer Lesekopie lesen darf, muss das Team des Schadenportals bei jeder neuen Abfrage mitpflegen.
Typische Fehler und woran man sie erkennt:
- Wachsender Rückstand: Bei hoher Last, großen Änderungen oder Netzstörungen wächst der Rückstand einer Lesekopie auf Minuten, und Nutzer sehen deutlich veraltete Daten. Erkennbar ist das am gemessenen Rückstand der Lesekopie und an Rückfragen zu Fällen, deren angezeigter Status nicht stimmt.
- Entscheidung auf der Lesekopie: Der Zahlungsablauf ist so eingestellt, dass er von der Lesekopie liest. Der Zahlungsablauf veranlasst die Auszahlung für Fall 4711 und hält sie an der Hauptdatenbank fest. Kurz darauf löst jemand die Auszahlung ein zweites Mal aus. Der Zahlungsablauf fragt die Lesekopie, ob für Fall 4711 schon gezahlt wurde. Die Lesekopie hat den Vermerk noch nicht übernommen und meldet „noch nicht gezahlt“, und der Zahlungsablauf löst eine zweite Auszahlung aus. Erkennbar ist das an doppelten Zahlungen kurz nach einer Freigabe.
- Prüfen und Festhalten getrennt: Der Zahlungsablauf prüft an der Hauptdatenbank, ob schon gezahlt wurde, und hält die Zahlung erst in einem zweiten Schritt fest. Zwei Auszahlungsanfragen für Fall 4711 kommen fast gleichzeitig. Für beide Anfragen meldet die Hauptdatenbank „noch nicht gezahlt“, weil noch keine der beiden Zahlungen festgehalten ist. Der Zahlungsablauf löst zwei Auszahlungen aus. Erkennbar ist das an doppelten Zahlungen mit fast gleichem Zeitpunkt.
- Verlust beim Rollenwechsel: Die Hauptdatenbank bestätigt eine neue Schadenmeldung. Danach fällt die Hauptdatenbank aus, bevor sie die Änderung an die Lesekopie übertragen hat. Die Lesekopie übernimmt die Rolle der Hauptdatenbank, und in der Lesekopie fehlt die bestätigte Schadenmeldung. Erkennbar ist das an bestätigten Schadenmeldungen, die nach dem Wechsel nicht mehr auffindbar sind.
Weiterführend
Verwandte Ansätze
- Replication: erklärt, wie die Hauptdatenbank ihre Änderungen an Kopien überträgt und worin sich das Warten auf eine Bestätigung vom sofortigen Antworten unterscheidet. Lesekopien nutzen diese Übertragung, um lesende Anfragen zu verteilen.
- Eventual Consistency: beschreibt die Zusage, dass Kopien ohne neue Änderungen irgendwann denselben Stand erreichen, so wie die Lesekopie nach der Übertragung Fall 4711 ebenfalls als „freigegeben“ zeigt.
- CQRS: trennt Schreiben und Lesen grundsätzlicher, mit einem eigenen Lesemodell für lesende Anfragen. Eine Lesekopie enthält dagegen dieselben Tabellen wie die Hauptdatenbank.
- Idempotency: sorgt dafür, dass ein wiederholter Auszahlungsauftrag für Fall 4711 keine zweite Zahlung auslöst.
Quellen
- AWS: Working with DB instance read replicas: beschreibt am Beispiel von Amazon RDS, wie Lesekopien Änderungen der Hauptdatenbank asynchron übernehmen, lesende Anfragen aufnehmen und bei einem Ausfall zur eigenständigen Datenbank gemacht werden können.
- PostgreSQL Global Development Group: Hot Standby: Dokumentation der Datenbank PostgreSQL zu Kopien, die nur lesende Abfragen annehmen, mit dem Hinweis, dass ihre Daten der Hauptdatenbank mit messbarer Verzögerung folgen.