
Sharding
Daten auf mehrere Server verteilen
Die Idee und ihr Nutzen
Die Schadenplattform einer Versicherung speichert inzwischen so viele Schadenakten, dass ein einzelner Datenbankserver die Datenmenge und die vielen Schreibvorgänge nicht mehr bewältigt. Deshalb verteilt das Team, das die Schadenplattform betreibt, die Akten auf mehrere Datenbankserver. Auf jedem Datenbankserver läuft dieselbe Datenbanksoftware mit denselben Tabellen, nur mit anderen Akten. Eine feste Regel bestimmt, auf welchem Server eine Akte liegt: Beginnt der Name des Kunden mit A bis H, liegt seine Akte auf dem Server A bis H, bei I bis P auf dem Server I bis P und bei Q bis Z auf dem Server Q bis Z. Jede Anfrage geht zuerst an den Shard-Router, ein Programm, das die Anfrage nach dieser Regel an den richtigen Server weiterleitet. Jeder Server speichert dadurch nur die Akten seines Buchstabenbereichs und beantwortet nur die Anfragen dazu. Diese Aufteilung heißt Sharding; das englische Wort shard bedeutet Scherbe oder Bruchstück. Ein Shard ist hier der Teil der Akten, der auf einem Server liegt, etwa alle Akten von A bis H.

Wie funktioniert es?
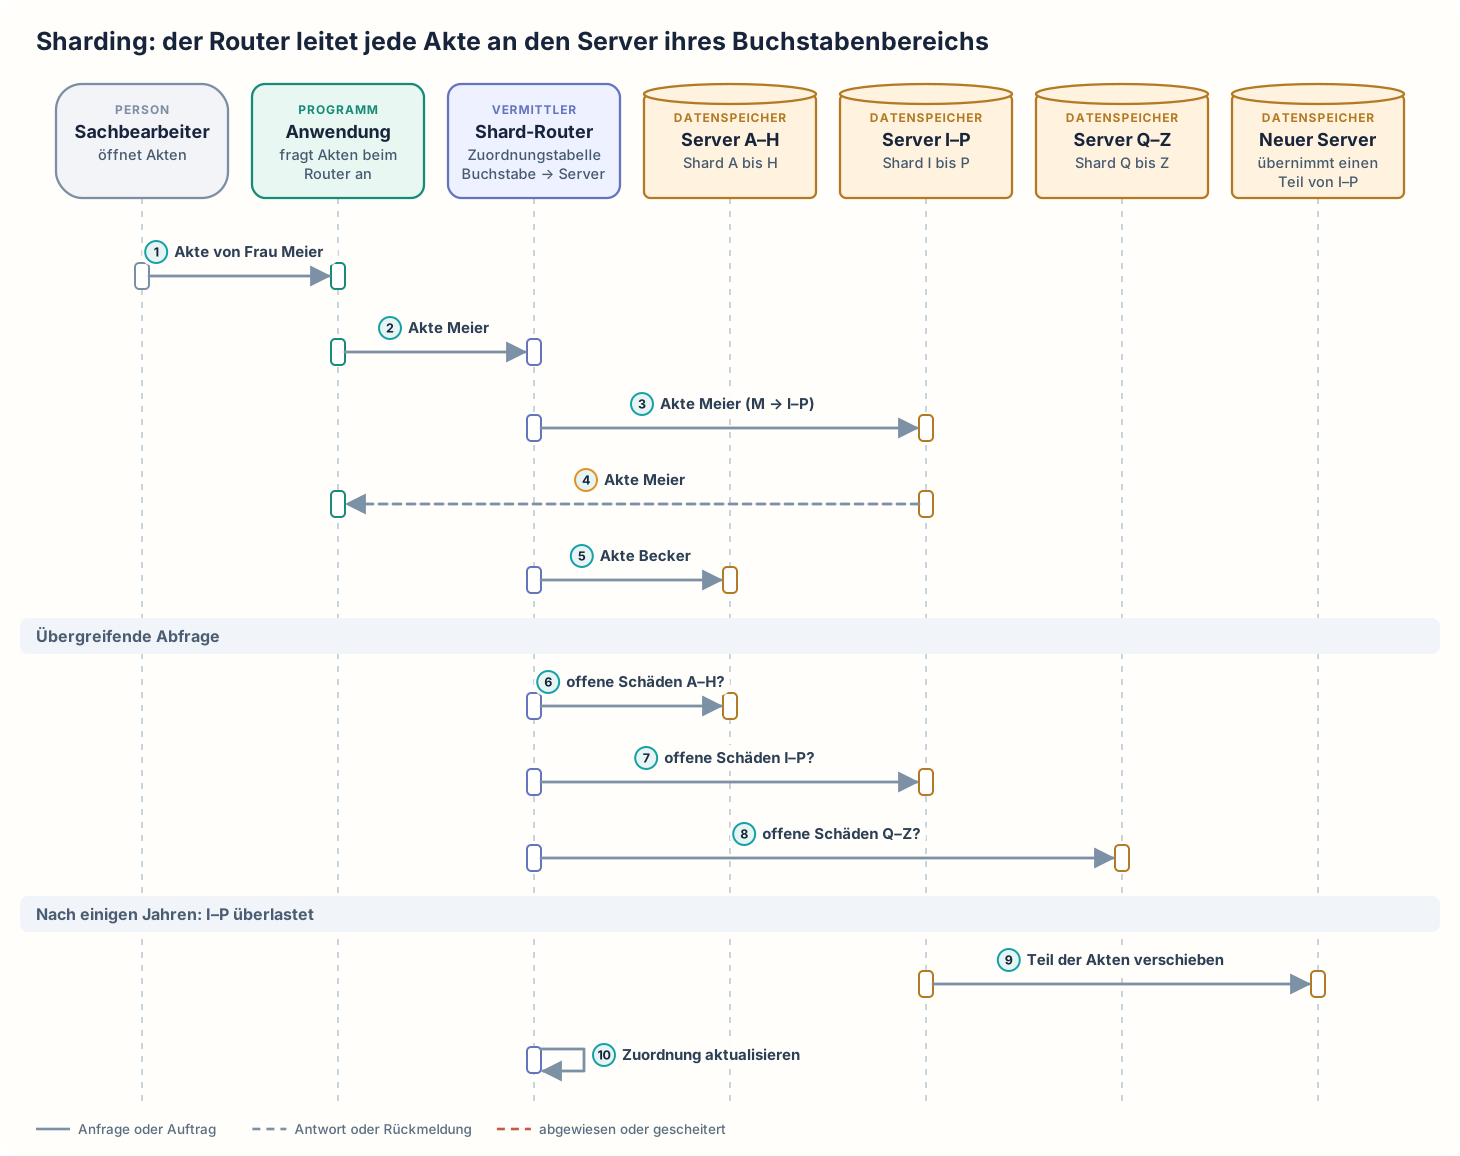
Ein Sachbearbeiter öffnet die Schadenakte von Frau Meier. Die Anwendung, mit der die Sachbearbeiter arbeiten, gibt die Anfrage an den Shard-Router. Der Shard-Router erkennt am Anfangsbuchstaben M den Bereich I bis P und leitet die Anfrage nur an den Server I bis P. Der Server I bis P liefert die Akte. Gleichzeitig laufen Anfragen zu anderen Kunden auf den anderen Servern; die Anfrage zur Akte Becker geht an den Server A bis H. Braucht die Anwendung die Summe der offenen Schäden über alle Kunden, fragt der Shard-Router dagegen alle drei Server. Jeder Server liefert sein Teilergebnis, und der Shard-Router führt die Teilergebnisse zusammen. Nach einigen Jahren ist der Server I bis P überlastet. Im Gebiet der Versicherung sind besonders viele Kunden mit Namen wie Meier, Müller oder Neumann versichert, und mit der wachsenden Zahl der Akten kommt der Server I bis P deshalb als erster an seine Grenze. Das Team teilt den Bereich I bis P auf, verschiebt einen Teil der Akten auf einen neuen Server und aktualisiert danach die Zuordnung im Shard-Router.
Das Merkmal, nach dem die Akten verteilt werden, heißt Verteilungsschlüssel; bei der Schadenplattform ist es der Anfangsbuchstabe des Kundennamens. Weil alle Akten eines Kunden zum selben Kundennamen gehören, liegen sie auf demselben Server, und eine Anfrage zu einem Kunden braucht nur diesen Server. Welcher Server welchen Buchstabenbereich hält, steht in einer Zuordnungstabelle im Shard-Router. Der Shard-Router liest bei jeder Anfrage den Kundennamen, schlägt in der Zuordnungstabelle nach und leitet die Anfrage an den zuständigen Server weiter. Die Anwendung muss deshalb nicht wissen, auf welchem Server eine Akte liegt. Ob jeder Server ähnlich viel zu tun hat, hängt vor allem vom Verteilungsschlüssel ab. Ein aus der Kundennummer berechneter Wert, etwa der Rest beim Teilen der Kundennummer durch die Zahl der Server, verteilt die Akten gleichmäßiger als der Anfangsbuchstabe, weil sich fortlaufend vergebene Kundennummern gleichmäßig auf alle Reste verteilen; in der Praxis verwenden Teams deshalb oft einen solchen Schlüssel.
Während des Umzugs auf den neuen Server darf keine Änderung verloren gehen, die ein Sachbearbeiter an einer umziehenden Akte vornimmt. Nach dem Umzug darf keine Anfrage mehr einen veralteten Stand vom alten Server lesen. Ändert ein Kunde seinen Nachnamen, gehören seine Akten plötzlich in einen anderen Bereich; für solche Fälle braucht die Zuordnung eine eigene Regel. Das Team trägt die Akten dieses Kunden zum Beispiel in der Zuordnungstabelle weiter beim alten Server ein oder verschiebt sie auf den Server des neuen Buchstabenbereichs. Fällt einer der drei Server aus, sind nur die Akten seines Bereichs nicht erreichbar. Akten aus den anderen Bereichen bleiben verfügbar, solange der Shard-Router läuft.
Sharding: der Router leitet jede Akte an den Server ihres Buchstabenbereichs
Wann ist es sinnvoll und wann nicht?
Sharding lohnt sich
- Die Datenmenge oder die Zahl der Schreibvorgänge ist für einen einzelnen Datenbankserver zu groß. Zu den Millionen Akten der Schadenplattform kommen jeden Tag Tausende neue Meldungen, Notizen und Dokumente hinzu. Der Speicher des Datenbankservers wird knapp, und bei vielen gleichzeitigen Änderungen kommt der Server mit dem Schreiben nicht mehr nach. Sachbearbeiter warten dann spürbar länger, wenn sie eine Akte speichern.
- Ein Server mit mehr Speicher und mehr Prozessoren hilft nur eine Zeit lang. Ein solcher Server wäre teuer, und irgendwann gibt es keinen stärkeren mehr zu kaufen. Mit Sharding nimmt das Team stattdessen einen weiteren Server hinzu.
- Die meisten Anfragen betreffen nur einen Buchstabenbereich. Bei der Schadenplattform betrifft eine Anfrage meist die Akten eines einzelnen Kunden. Auf einem einzelnen Datenbankserver warten alle diese Anfragen auf denselben Server. Mit Sharding bearbeitet jede dieser Anfragen nur ein Server, und die anderen Server bearbeiten gleichzeitig andere Anfragen.
Sharding ist nicht das Richtige
- Fehlende Indizes oder ungünstig geschriebene Abfragen machen die Datenbank langsam. Ein Index ist ein Suchverzeichnis der Datenbank, mit dem sie eine Akte findet, ohne alle Akten zu durchsuchen. Mit Sharding liefen dieselben langsamen Abfragen dann nur auf mehreren Servern. Stattdessen legt das Team die fehlenden Indizes an und schreibt die Abfragen um, alles auf dem einen Datenbankserver. Weitere Server, ein Shard-Router und das Umverteilen von Akten entfallen.
- Ein Datenbankserver mit mehr Speicher und mehr Prozessoren ist noch bezahlbar. Dann ersetzt das Team den bisherigen Datenbankserver durch einen solchen Server. Für eine Weile reicht das, und alle Akten bleiben auf einem Server, ohne Shard-Router und ohne Umverteilen. Den Vergleich zwischen einem stärkeren Server und mehreren Servern nebeneinander beschreibt Vertical versus Horizontal Scaling.
- Der Engpass entsteht beim Lesen, nicht beim Schreiben. Sharding bräuchte auch dafür eine Verteilungsregel, den Shard-Router und das Umverteilen der Akten. Dann richtet das Team Read Replicas ein, zusätzliche Datenbanken mit einer Kopie aller Daten, die Lesezugriffe übernehmen. Weil alle Daten auf jeder dieser Datenbanken liegen, ist keine Verteilungsregel nötig. Auch ein Cache, ein Zwischenspeicher, der häufig gelesene Akten bereithält, entlastet die Datenbank beim Lesen, ohne dass Akten verteilt werden müssen.
- Nur eine einzelne Tabelle ist zu groß, etwa die Tabelle mit den Dokumenten zu den Akten. Sharding würde alle Tabellen auf mehrere Server verteilen, obwohl nur diese eine zu groß ist. Dann zerlegt das Team diese Tabelle mit Partitioning in Teile, die auf demselben Server liegen bleiben. Weitere Datenbankserver und ein Shard-Router entfallen.
- Viele Abfragen und Änderungen betreffen Daten vieler Kunden zugleich. Beispiele sind Auswertungen über alle Schäden oder Buchungen, die mehrere Kunden gemeinsam ändern. Dann lässt das Team alle Akten auf einem Datenbankserver und richtet für die Auswertungen Read Replicas ein. Mit Sharding müsste der Shard-Router jede solche Abfrage an alle drei Server schicken und die Teilergebnisse zusammensetzen. Eine Buchung für Kunden auf verschiedenen Servern bräuchte zudem eine gemeinsame Transaktion über mehrere Server.
Nachteile und typische Fehler
Eine Abfrage, die mehrere Server betrifft, muss der Shard-Router an jeden dieser Server schicken und aus den Teilergebnissen zusammensetzen. Eine gemeinsame Transaktion über mehrere Server hinweg, bei der alle Änderungen gemeinsam gespeichert oder verworfen werden, ist nur mit zusätzlichen Verfahren möglich. Bei einem solchen Verfahren fragt zum Beispiel ein Programm erst alle beteiligten Server, ob sie speichern können, und gibt erst danach allen den Befehl zum Speichern. Das Umverteilen von Akten braucht Zeit. Wie viele Akten beim Hinzufügen eines Servers umziehen müssen, hängt schon vom gewählten Verteilungsschlüssel ab. Statt eines Datenbankservers betreibt das Team mehrere: Sicherungen, Überwachung und Änderungen am Aufbau der Tabellen müssen für jeden Server einzeln laufen; eine neue Spalte muss das Team zum Beispiel auf allen Servern anlegen. Alle Anfragen laufen über den Shard-Router; er muss deshalb selbst ausfallsicher sein.
Typische Fehler und woran man sie erkennt:
- Ungleichmäßiger Schlüssel: Viele Kunden tragen Namen wie Meier, Müller oder Neumann. Auf dem Server I bis P liegt deshalb zum Beispiel die Hälfte aller Akten, auf den beiden anderen Servern je ein Viertel. Der Shard-Router schickt dem Server I bis P dann doppelt so viele Anfragen wie jedem der anderen Server. Erkennbar ist das an einem Server mit hoher Auslastung und langen Antwortzeiten, während die übrigen wenig zu tun haben.
- Verlorene Änderung beim Umzug: Das Team kopiert eine Akte vom Server I bis P auf den neuen Server. Danach ändert ein Sachbearbeiter die Akte, und der Shard-Router leitet die Änderung noch an den Server I bis P. Dann stellt das Team die Zuordnung im Shard-Router um, und auf dem neuen Server fehlt die Änderung. Erkennbar ist das an Notizen oder Dokumenten, die nach dem Umzug in einer Akte fehlen.
- Veralteter Stand: Der Shard-Router liest nach dem Umzug noch eine Zeit lang vom alten Server. Erkennbar ist das an Akten, die je nach Anfrage unterschiedliche Stände zeigen.
- Akte im falschen Bereich: Eine Kundin heiratet und heißt nun Zimmer statt Meier. Ohne eigene Regel sucht der Shard-Router ihre Akten auf dem Server Q bis Z, obwohl sie noch auf dem Server I bis P liegen. Erkennbar ist das an Akten, die nach einer Namensänderung nicht mehr gefunden werden.
- Ausfall des Shard-Routers: Der Shard-Router fällt aus, und keine Anfrage erreicht mehr einen Datenbankserver, obwohl alle drei laufen. Erkennbar ist das an Fehlern bei allen Akten zugleich.
Weiterführend
Verwandte Ansätze
- Consistent Hashing: ein Rechenverfahren für den Verteilungsschlüssel, bei dem ein neuer Server nur einen Teil der Daten eines bisherigen Servers übernimmt. Es verringert den Umzug beim Hinzufügen eines Servers.
- Replication: kopiert Daten auf mehrere Rechner. In der Praxis wird oft jeder Shard zusätzlich repliziert, damit sein Bereich den Ausfall eines Servers übersteht.
Quellen
- Microsoft: Sharding pattern: beschreibt im Azure Architecture Center die Wahl des Verteilungsschlüssels, Verteilung über eine Zuordnungstabelle, nach Bereichen oder nach einem berechneten Wert, das Umverteilen, überlastete Shards und Abfragen über alle Shards.
- MongoDB: Sharding: Dokumentation einer Datenbank mit eingebautem Sharding. Sie beschreibt den Verteilungsschlüssel, den Router
mongos, an den jede Anfrage zuerst geht, die Verteilung nach Bereichen oder berechneten Werten und Abfragen ohne Schlüssel, die an alle Shards gehen.