
Consistent Hashing
Schlüssel so verteilen, dass beim Umbau wenig umzieht
Die Idee und ihr Nutzen
Eine Versicherung hält die Stammdaten von 2 Millionen Kunden in einem Zwischenspeicher, einem Cache, der auf drei Servern verteilt ist und die Daten schneller liefert als die Kundendatenbank. Vor dem Jahresendgeschäft soll ein vierter Server hinzukommen. Eine einfache Verteilregel teilt eine aus der Kundennummer berechnete Zahl durch die Zahl der Server und nimmt den Rest als Servernummer. Mit dieser Regel müssten beim vierten Server etwa drei von vier Kunden auf einen anderen Server umziehen, und ihre Daten müssten neu aus der Kundendatenbank geladen werden. Ein anderes Verfahren berechnet aus Kundennummern und Servernamen Plätze auf einem gedachten Kreis. Jeder Kunde gehört zu dem Server, der auf dem Kreis im Uhrzeigersinn als nächster folgt. Der neue Server übernimmt dadurch nur etwa ein Viertel der Kunden, und die übrigen Daten bleiben, wo sie sind. Dieses Verfahren heißt Consistent Hashing. Hashing bedeutet das Berechnen einer festen Zahl aus einer Nummer oder einem Namen.

Wie funktioniert es?
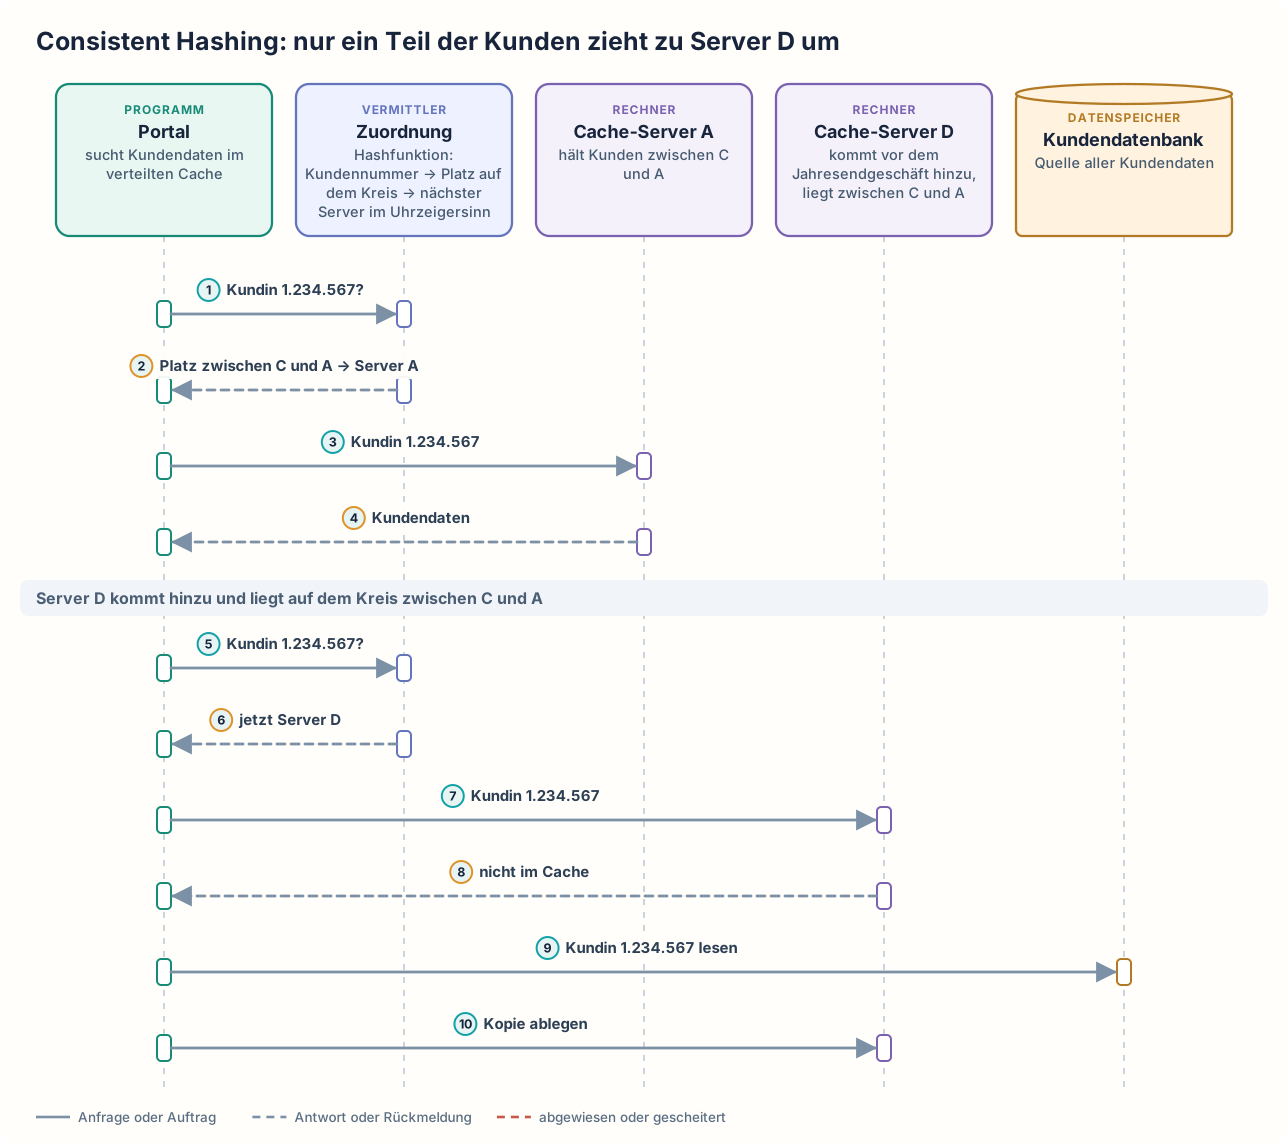
Das Portal der Versicherung liest Kundenstammdaten zuerst aus dem Cache und lädt die Daten eines Kunden nur dann aus der Kundendatenbank, wenn sie im Cache fehlen. Der Cache läuft zunächst auf den drei Cache-Servern A, B und C. Welcher Cache-Server für einen Kunden zuständig ist, berechnet ein Programmteil des Portals namens „Zuordnung“. Das Portal braucht die Daten der Kundin 1.234.567 und fragt deshalb zuerst die „Zuordnung“. Die „Zuordnung“ berechnet für die Kundin einen Platz auf dem Kreis zwischen C und A. Zuständig ist der nächste Server im Uhrzeigersinn, also Cache-Server A. Das Portal liest die Daten bei Cache-Server A. Cache-Server A hat eine Kopie und liefert die Daten aus dem Cache. Ein solcher Fund im Cache heißt Treffer. Vor dem Jahresendgeschäft kommt Cache-Server D hinzu, der auf dem Kreis zwischen der Kundin und Cache-Server A liegt. Fragt das Portal die „Zuordnung“ danach erneut, ist jetzt Cache-Server D zuständig. Cache-Server D übernimmt nur die Kunden zwischen C und D, die bisher zu Cache-Server A gehörten. Alle anderen Kunden bleiben, wo sie sind. Das Portal fragt Cache-Server D. Cache-Server D ist noch leer und meldet „nicht im Cache“. Das Portal liest die Daten der Kundin deshalb einmal aus der Kundendatenbank und legt eine Kopie bei Cache-Server D ab. Ab jetzt liefert Cache-Server D die Daten der Kundin.
Der Cache ist auf mehrere Server verteilt, weil die Daten von 2 Millionen Kunden und die Zahl der Anfragen für einen einzelnen Server zu viel wären. Auf allen Cache-Servern läuft dasselbe Cache-Programm, aber jeder Cache-Server hält nur einen Teil der Kunden. Bei jeder Anfrage muss sich deshalb ausrechnen lassen, welcher Server für einen Kunden zuständig ist, ohne erst alle Server zu fragen. Das übernimmt die „Zuordnung“ mit einer Hashfunktion. Eine Hashfunktion ist eine Rechenvorschrift, die aus einem Text oder einer Nummer eine scheinbar zufällige, aber für dieselbe Eingabe immer gleiche Zahl macht. Die einfache Verteilregel teilt diese Zahl durch die Anzahl der Server und nimmt den Rest der Division als Servernummer. Bei drei Servern ist der Rest 0, 1 oder 2. Kommt ein vierter Server hinzu, wird durch vier geteilt, und für im Durchschnitt drei von vier Kunden ergibt sich ein anderer Server. Liefert die Hashfunktion für einen Kunden zum Beispiel die Zahl 10, ist der Rest bei drei Servern 1 und bei vier Servern 2.
Consistent Hashing rechnet stattdessen mit einem gedachten Kreis, auf dem die Zahlen von 0 bis etwa 4 Milliarden im Uhrzeigersinn angeordnet sind, also alle Zahlen, die die Hashfunktion liefern kann. Nach der größten Zahl folgt wieder die 0. Jeder Server erhält einen Platz auf dem Kreis, den die Hashfunktion aus seinem Namen berechnet. Jeder Kunde erhält ebenso einen Platz, den die Hashfunktion aus seiner Kundennummer berechnet. Ein Kunde gehört zu dem Server, der auf dem Kreis im Uhrzeigersinn als nächster folgt. Das Verfahren legt nur fest, wo ein Kunde liegt. Daten zwischen den Servern kopiert es nicht.
Bei nur einem Platz je Server wären die Abschnitte zwischen den Servern auf dem Kreis zufällig unterschiedlich lang, und ein Server bekäme vielleicht doppelt so viele Kunden wie ein anderer. Auch wie viele Kunden beim Hinzufügen umziehen, hinge davon ab, wo Cache-Server D auf dem Kreis landet. Deshalb erhält jeder Server viele Plätze auf dem Kreis, etwa 100. Mehr Plätze würden die Kunden kaum noch gleichmäßiger verteilen, aber die Liste der Plätze verlängern, in der die „Zuordnung“ bei jeder Anfrage sucht. Diese Plätze heißen virtuelle Knoten. Jeder Server hat dann kurze und lange Abschnitte, die sich in der Summe ausgleichen, und jeder der Cache-Server A, B, C und D hält ungefähr gleich viele Kunden. Cache-Server D übernimmt dann an jedem seiner Plätze einen kleinen Abschnitt von einem der drei bisherigen Server. Insgesamt zieht etwa ein Viertel der Kunden um statt drei Viertel wie bei der einfachen Verteilregel.
Fällt ein Server weg, gilt dasselbe umgekehrt: Seine Kunden gehören nun zum jeweils nächsten Server im Uhrzeigersinn, und nur diese Kunden müssen neu geladen werden.
Consistent Hashing: nur ein Teil der Kunden zieht zu Server D um
Wann ist es sinnvoll und wann nicht?
Consistent Hashing lohnt sich
- Daten liegen in einem verteilten Cache oder einer verteilten Datenbank, und Server kommen häufig hinzu oder fallen weg. Ein Beispiel sind zusätzliche Server vor einer Lastspitze wie dem Jahresendgeschäft. Mit der einfachen Verteilregel zieht bei jeder solchen Änderung der größte Teil der Kunden auf einen anderen Server um.
- Die Kundendatenbank, aus der das Portal fehlende Daten nachlädt, soll beim Umbau nicht überlastet werden. Mit der einfachen Verteilregel sucht das Portal nach dem Hinzufügen von Cache-Server D drei von vier Kunden auf einem anderen Server, findet sie dort nicht und lädt sie aus der Kundendatenbank nach. Innerhalb weniger Minuten muss die Kundendatenbank dann die Daten von drei Vierteln der 2 Millionen Kunden liefern, also von 1,5 Millionen Kunden, genau dann, wenn wegen des Jahresendgeschäfts ohnehin viel los ist. Mit Consistent Hashing liefert sie nur die Daten der etwa 500.000 umgezogenen Kunden einmal nach.
- Ein Lastverteiler, der Anfragen auf mehrere Server verteilt, soll die Anfragen eines Kunden an denselben Server schicken. Kommt ein Server hinzu, sollen nur wenige Kunden einen anderen Server bekommen. Mit der einfachen Verteilregel bekämen beim vierten Server drei von vier Kunden einen anderen Server.
Consistent Hashing ist nicht das Richtige
- Die Zahl der Server bleibt dauerhaft gleich. Dann zieht nie ein Kunde um, auch nicht mit der einfachen Verteilregel. Die „Zuordnung“ berechnet den Server deshalb mit dieser Regel, also mit dem Rest der Division durch die Zahl der Server. Die virtuellen Knoten muss niemand einrichten, und die „Zuordnung“ sucht nicht bei jeder Anfrage in der Liste der Plätze.
- Das Portal fragt oft ganze Bereiche ab, etwa alle Kunden mit Nummern von 1000 bis 2000. Die Hashfunktion verteilt benachbarte Nummern aber über den ganzen Kreis, sodass etwa die Kunden 1000 und 1001 meist bei verschiedenen Cache-Servern liegen. Stattdessen legt das Entwicklungsteam des Portals eine Tabelle an, die jedem Bereich einen Server zuordnet. Dieses Vorgehen heißt bereichsweise Aufteilung (Partitioning). Für einen Bereich fragt das Portal dann nur den einen Server, der für diesen Bereich zuständig ist, statt alle Cache-Server. Welche Bereiche bei einem neuen Server umziehen, legt das Entwicklungsteam in der Tabelle selbst fest. Dafür muss das Entwicklungsteam die Tabelle pflegen, und die „Zuordnung“ liest sie bei jeder Anfrage.
Nachteile und typische Fehler
Jedes weitere Programm, das den Cache nutzt, enthält einen eigenen Programmteil wie die „Zuordnung“ des Portals. Alle diese Programmteile müssen dieselbe Hashfunktion und dieselbe Liste der Server verwenden. Die Serverliste muss deshalb zentral gepflegt und an alle Programme verteilt werden. Die virtuellen Knoten müssen eingerichtet und ihre Zahl je Server festgelegt werden. Wer alle Kunden mit Nummern von 1000 bis 2000 braucht, muss alle Cache-Server fragen, weil diese Kunden verstreut liegen. Auch mit Consistent Hashing ziehen beim Hinzufügen eines Servers Kunden um, und die Kundendatenbank muss die Daten dieser Kunden nachliefern, beim vierten Server die Daten von etwa 500.000 Kunden.
Typische Fehler und woran man sie erkennt:
- Fehlende virtuelle Knoten: Jeder Server hat nur einen Platz auf dem Kreis, und die Kunden werden ungleich verteilt. Ein Server kann dann zum Beispiel doppelt so viele Kunden halten wie ein anderer. Erkennbar ist das an stark unterschiedlicher Belegung und Auslastung der Cache-Server.
- Häufig abgefragter Kunde: Ein einzelner Kunde wird sehr häufig abgefragt. Die „Zuordnung“ berechnet für diesen Kunden auch mit virtuellen Knoten immer denselben Cache-Server, und das Portal schickt alle Anfragen nach diesem Kunden an diesen einen Cache-Server. Der Cache-Server erhält dann mehr Anfragen, als er rechtzeitig beantworten kann. Erkennbar ist das an einem Server mit hoher Last, obwohl er nicht mehr Kunden hält als die anderen.
- Abweichende Serverliste: Die Serverliste in der „Zuordnung“ des Portals enthält Cache-Server D schon. Die Serverliste eines anderen Programms, das denselben Cache nutzt, enthält Cache-Server D noch nicht. Das Portal legt eine Kopie der Daten der Kundin 1.234.567 bei Cache-Server D ab. Das andere Programm liest dieselbe Kundin weiter bei Cache-Server A, wo noch die alte Kopie liegt. Die Daten der Kundin liegen dann zweimal im Cache, bei Cache-Server A und bei Cache-Server D. Erkennbar ist das an Kunden, deren Daten auf zwei Cache-Servern liegen.
- Erweiterung zur Spitzenzeit: Cache-Server D kommt erst hinzu, wenn das Jahresendgeschäft schon läuft. Das Portal findet dann ein Viertel der 2 Millionen Kunden, also 500.000 Kunden, nicht mehr im Cache und lädt ihre Daten aus der Kundendatenbank nach. Erkennbar ist das an einer Lastspitze der Kundendatenbank direkt nach dem Hinzufügen.
- Geänderte Hashfunktion: Eine neue Version des Portals tauscht in der „Zuordnung“ die Hashfunktion aus, und fast alle Kunden erhalten einen neuen Platz auf dem Kreis. Das Portal sucht dann fast jeden Kunden auf einem anderen Cache-Server als bisher und lädt seine Daten aus der Kundendatenbank nach. Erkennbar ist das daran, dass das Portal direkt nach der Umstellung fast keinen Kunden mehr im Cache findet.
Weiterführend
Verwandte Ansätze
- Sharding: verteilt die Daten einer Datenbank auf mehrere Server und verwendet dafür oft Consistent Hashing.
- Load Balancing: verteilt Anfragen auf Server. Manche Lastverteiler nutzen Consistent Hashing, damit ein Kunde beim selben Server bleibt.
- Caching: erklärt, warum ein Cache Daten zwischenspeichert und welche Risiken dabei entstehen.
Werkzeuge und Umsetzungen
- Apache Cassandra: verteilte Datenbank, die ihre Daten über einen solchen Kreis mit virtuellen Knoten auf die Server verteilt.
- Envoy: ein Programm, das Netzverbindungen stellvertretend annimmt und weiterleitet. Envoy kann Anfragen mit dem Verfahren Ring Hash oder dem verwandten Verfahren Maglev auf Server verteilen.
- HAProxy: Lastverteiler, der Anfragen nach einem Schlüssel wie der Kundennummer immer demselben Server zuordnen kann.
- groupcache: Cache-Bibliothek für die Programmiersprache Go, die Schlüssel über einen solchen Kreis den Servern zuordnet. Sie wird nur noch selten geändert, zuletzt im November 2024.
Quellen
- David Karger, Eric Lehman, Tom Leighton u. a.: Consistent Hashing and Random Trees: Originalaufsatz von 1997, der das Verfahren für verteilte Caches einführt und zeigt, dass beim Hinzufügen eines Caches nur ein kleiner Teil der Einträge umzieht.
- Giuseppe DeCandia u. a.: Dynamo: Amazon's Highly Available Key-value Store: Aufsatz von 2007, der den Kreis im Einsatz beschreibt, die ungleiche Last bei einem Platz je Server benennt und virtuelle Knoten als Abhilfe einführt.