
Partitioning
Daten nach einem Schlüssel aufteilen
Die Idee und ihr Nutzen
Eine Versicherung speichert alle Buchungen seit 2007 in einer einzigen Datenbanktabelle namens buchung. Die Tabelle enthält inzwischen 900 Millionen Zeilen aus zwanzig Jahren, doch die meisten Abfragen betreffen nur ein einzelnes Jahr. Deshalb zerlegt die Datenbank die große Tabelle intern in kleinere Teile, die Partitionen, hier eine Partition pro Buchungsjahr. Eine Abfrage für das Jahr 2025 liest dann nur die Partition 2025 und lässt die übrigen Partitionen aus. Diese Aufteilung heißt Partitioning, auf Deutsch Partitionierung.

Wie funktioniert es?
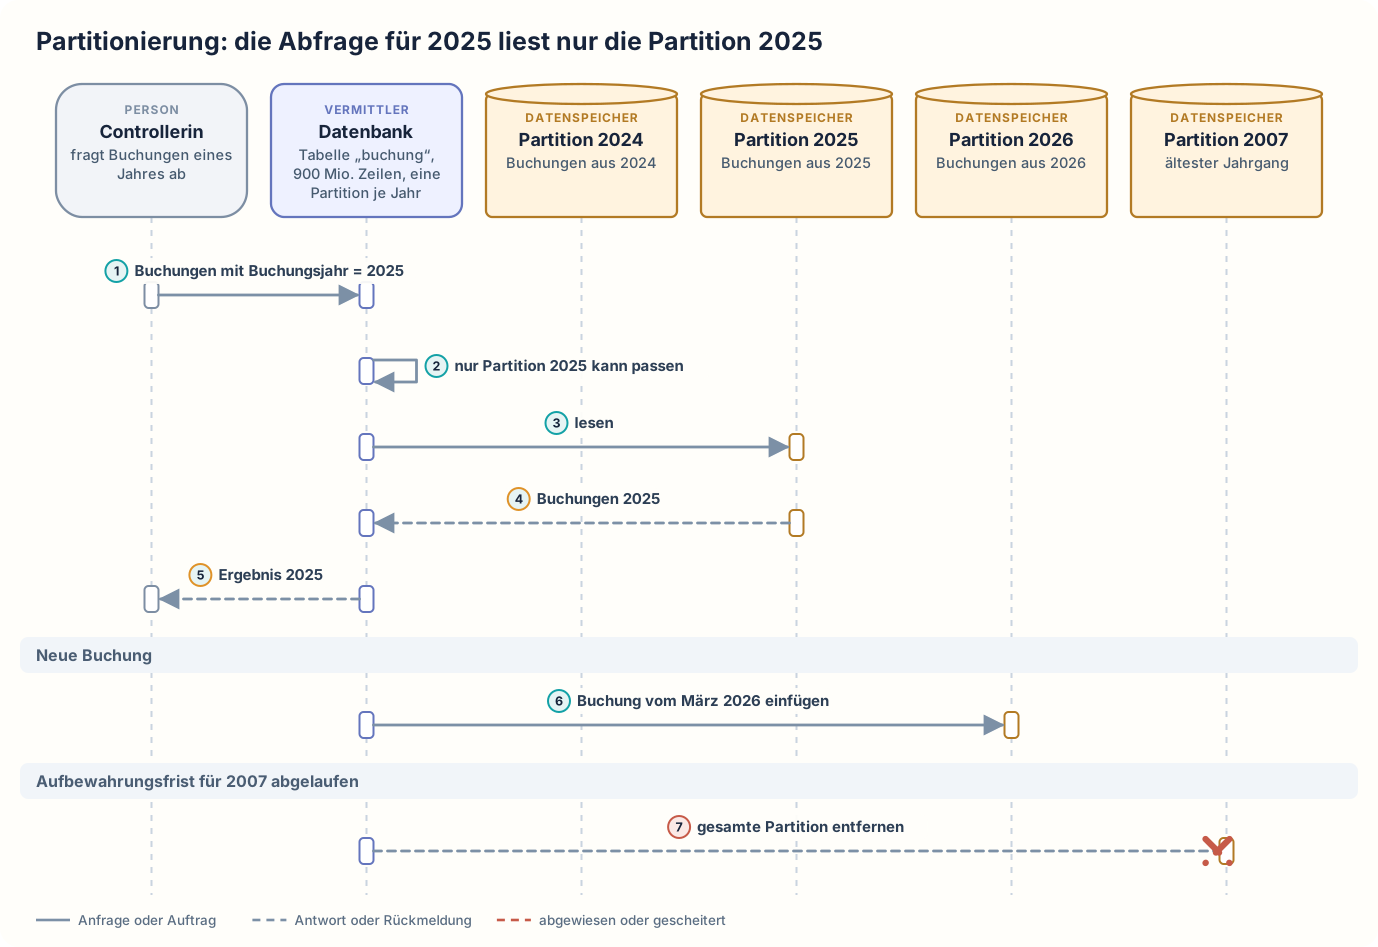
Eine Controllerin, die die Zahlen des Unternehmens auswertet, fragt alle Buchungen des Jahres 2025 ab. Ihre Abfrage enthält die Bedingung „Buchungsjahr gleich 2025“. Aus dieser Bedingung erkennt die Datenbank, dass nur die Partition 2025 passende Zeilen enthalten kann. Die Datenbank liest nur die Partition 2025, nicht die Partitionen 2024, 2026 und die älteren Jahrgänge. Danach gibt die Datenbank der Controllerin die Buchungen des Jahres 2025 zurück. Wie viel schneller das gegenüber der ganzen Tabelle ist, hängt von den Indizes ab und davon, wie viele Zeilen die Abfrage am Ende liefert. Indizes sind Verzeichnisse, mit denen die Datenbank passende Zeilen findet, ohne die ganze Tabelle durchzulesen. Ein Index auf die Kundennummer verzeichnet zum Beispiel zu jeder Kundennummer die Zeilen mit den Buchungen dieses Kunden. Die Datenbank sortiert eine neue Buchung vom März 2026 anhand ihres Buchungsjahrs in die Partition 2026 ein. Ist die Aufbewahrungsfrist für den Jahrgang 2007 abgelaufen, entfernt die Datenbank die gesamte Partition 2007 mit einem einzigen Befehl, statt zig Millionen Zeilen einzeln zu löschen. Das ist nur zulässig, wenn keine Buchung aus dem Jahrgang 2007 mehr gebraucht wird, etwa für einen laufenden Rechtsstreit.
Das Merkmal, nach dem die Datenbank die Zeilen aufteilt, heißt Partitionsschlüssel, hier das Buchungsjahr. Beim Einrichten legt das Team, das die Datenbank betreut, den Partitionsschlüssel fest und erzeugt für jedes Jahr von 2007 bis 2026 eine Partition. Danach entscheidet die Datenbank beim Speichern selbst anhand des Partitionsschlüssels, in welche Partition eine Zeile gehört. Für Programme und Abfragen bleibt buchung eine einzige Tabelle. Dass die Datenbank bei einer Abfrage die nicht passenden Partitionen überspringt, heißt Partition Pruning, auf Deutsch etwa Zurückschneiden. Das Überspringen funktioniert nur, wenn sich die Bedingung der Abfrage direkt auf den Partitionsschlüssel bezieht. Bei der Tabelle buchung überspringt die Datenbank Partitionen also bei einer Bedingung auf das Buchungsjahr, nicht aber bei einer Bedingung auf ein anderes Feld wie das Schadendatum.
Die Aufteilung nach Buchungsjahr ist eine Aufteilung nach Bereichen (englisch Range): Jede Partition nimmt einen Wertebereich auf, etwa alle Buchungen eines Jahres oder eines Monats. Diese Art eignet sich gut für Daten mit einem Datum. Bei der Aufteilung nach Listen (List) nimmt jede Partition bestimmte, aufgezählte Werte auf. Eine Partition kann zum Beispiel alle Buchungen der Sparte Kfz aufnehmen und eine andere alle Buchungen der Sparte Hausrat. Ebenso lässt sich nach Ländern aufteilen. Bei der Aufteilung nach Streuwert (Hash) ist der Partitionsschlüssel zum Beispiel die Kundennummer. Die Datenbank berechnet daraus mit einer festen Rechenregel eine Zahl, den Streuwert, und ordnet die Zeile danach einer von beispielsweise 16 Partitionen zu. So verteilen sich die Zeilen etwa gleichmäßig.
Statt einen abgelaufenen Jahrgang zu entfernen, kann die Datenbank die ganze Partition auch in ein Archiv verschieben. Beides setzt voraus, dass das Datenbanksystem das Entfernen und Verschieben ganzer Partitionen unterstützt und keine Verweise aus anderen Tabellen mehr auf Buchungen der Partition zeigen, etwa aus einer Tabelle mit Zahlungen auf die zugehörige Buchung von 2007. Die Tabelle buchung liegt auf einem einzigen Server in einer relationalen Datenbank, also einer Datenbank, die Daten in Tabellen mit Zeilen und Spalten speichert und mit der Abfragesprache SQL abgefragt wird. Alle Partitionen liegen auf diesem Server. Die Partitionierung verteilt die Daten nicht von selbst auf mehrere Rechner und unterscheidet sich darin vom Sharding, bei dem die Teile auf verschiedenen Servern liegen. Die Aufteilung nach einem Schlüssel gibt es auch außerhalb von Datenbanken. Nachrichtenplattformen zum Beispiel teilen einen Nachrichtenstrom in mehrere Teilströme auf.
Partitionierung: die Abfrage für 2025 liest nur die Partition 2025
Wann ist es sinnvoll und wann nicht?
Partitioning lohnt sich
- Eine sehr große Tabelle wird überwiegend in klar abgegrenzten Ausschnitten abgefragt. Beispiele sind Abfragen nach Jahr oder nach Sparte. Ohne Partitionierung durchsucht die Datenbank für die Buchungen eines Jahres die ganze Tabelle mit 900 Millionen Zeilen oder einen Index über alle diese Zeilen. Mit Partitionierung liest die Datenbank nur die Partition dieses Jahres.
- Alte Daten müssen regelmäßig archiviert oder gelöscht werden. Buchungen müssen eine bestimmte Zahl von Jahren aufbewahrt und danach gelöscht werden. Ohne Partitionierung muss die Datenbank dafür zig Millionen einzelne Zeilen suchen und löschen. Ein solcher Löschvorgang läuft lange, belastet die Datenbank und kann andere Abfragen in dieser Zeit verlangsamen. Mit Partitionierung entfernt die Datenbank den abgelaufenen Jahrgang als ganze Partition mit einem einzigen Befehl.
- Die Indizes einer Tabelle sind so groß geworden, dass Anlegen, Pflegen und Sichern spürbar Zeit und Speicherplatz brauchen. Die Tabelle
buchungwächst jedes Jahr um viele Millionen Zeilen, und die Indizes wachsen mit. Mit Partitionierung hat jede Partition eigene, kleinere Indizes, die sich schneller anlegen, pflegen und sichern lassen. - Neue Daten kommen fast nur für den neuesten Ausschnitt hinzu, und ältere Daten werden nur noch gelesen. Bei der Versicherung kommen neue Buchungen fast nur für das laufende Jahr hinzu. Ohne Partitionierung trägt die Datenbank jede neue Buchung in einen Index über alle zwanzig Jahrgänge ein, der mit jedem Jahr größer wird. Mit Partitionierung schreibt die Datenbank fast nur in die Partition 2026, und nur deren Indizes ändern sich.
- Viele Programme lesen und schreiben dieselbe Tabelle. Bei der Versicherung sind das die Buchhaltung, das Controlling und nächtliche Auswertungen. Würde das Team die Buchungen stattdessen auf eine eigene Tabelle je Jahr verteilen, müsste es alle diese Programme ändern. Mit Partitionierung arbeiten die Programme mit der einen Tabelle
buchungweiter.
Partitioning ist nicht das Richtige
- Die Tabelle ist klein. Bei wenigen Zeilen dauert das Lesen der ganzen Tabelle kaum länger als das Lesen einer einzelnen Partition, und Partitionen würden keine Abfrage merklich beschleunigen. Dann lässt das Team die Tabelle ungeteilt und muss keine Partitionen anlegen und entfernen.
- Die meisten Abfragen enthalten keine Bedingung auf den Partitionsschlüssel, sondern filtern zum Beispiel nach dem Schadendatum. Mit Partitionen müsste die Datenbank dann bei fast jeder Abfrage alle 20 Partitionen einzeln durchsuchen. Stattdessen lässt das Team die Tabelle ungeteilt und legt einen Index auf das Schadendatum an. Die Datenbank durchsucht dann einen einzigen Index statt 20.
- Ein einzelner Server reicht für die Datenmenge oder die Zahl der Abfragen nicht mehr aus. Partitionierung hilft dann nicht, weil alle Partitionen auf demselben Server liegen. Stattdessen verteilt das Team die Zeilen mit Sharding auf mehrere Server. Jeder dieser Server speichert nur einen Teil der Zeilen und beantwortet nur die Abfragen zu diesem Teil.
- Die meisten Abfragen betreffen nur ein Jahr und liefern nur wenige Zeilen, etwa die Buchungen eines Kunden im Jahr 2025. Mit einem passenden Index, etwa auf Buchungsjahr und Kundennummer, findet die Datenbank diese wenigen Zeilen auch in der ungeteilten Tabelle direkt, und eine Partition je Jahr würde die Abfrage kaum schneller machen. Dann legt das Team diesen Index an und lässt die Tabelle ungeteilt. Das Team muss dann keine Partitionen anlegen und entfernen. Beim Löschen ganzer Jahrgänge hilft ein Index allerdings nicht: Die Datenbank muss die Zeilen eines Jahrgangs dann einzeln löschen.
- Alte Jahrgänge werden nur noch selten gelesen. Sie müssen dann nicht in der Tabelle stehen, die Buchhaltung und Controlling täglich abfragen. Dann verschiebt das Team die alten Jahrgänge in eine eigene Archivtabelle oder in ein Data Warehouse, eine eigene Datenbank für Auswertungen. Wer eine alte Buchung braucht, fragt die Archivtabelle oder das Data Warehouse ab. Die Tabelle
buchungenthält danach nur noch die Buchungen der letzten Jahre, und ihre Indizes bleiben klein, ohne dass das Team Partitionen anlegen und entfernen muss.
Nachteile und typische Fehler
Die Wahl des Partitionsschlüssels ist entscheidend und lässt sich später nur mit großem Aufwand ändern, weil dafür alle Zeilen neu verteilt werden müssen. Die Datenbank kann Regeln über alle Partitionen hinweg nur eingeschränkt prüfen. Ein Beispiel ist die Regel, dass eine Belegnummer in der gesamten Tabelle nur einmal vorkommt. Ein anderes ist die Regel, dass Verweise aus anderen Tabellen gültig sind. Solche Prüfungen müssen dann die Programme übernehmen, die in die Tabelle schreiben, oder die Regel muss den Partitionsschlüssel enthalten. Die Belegnummer ist dann nur noch je Buchungsjahr eindeutig. Im Betrieb müssen neue Partitionen rechtzeitig angelegt und abgelaufene entfernt werden. Das Team braucht dafür einen festen Ablauf oder ein Werkzeug, das Partitionen im Voraus anlegt. Abfragen müssen so geschrieben sein, dass sie den Partitionsschlüssel nutzen. Das betrifft auch Auswertungen, die Buchhaltung und Controlling selbst schreiben.
Typische Fehler und woran man sie erkennt:
- Ungleich große Partitionen: Ein ungünstiger Schlüssel erzeugt sehr ungleich große Partitionen. Ein Beispiel ist eine Aufteilung nach Sparte, bei der die Sparte Kfz 90 Prozent aller Zeilen enthält und die anderen Sparten fast leer sind. Eine Abfrage auf Kfz liest dann weiterhin 90 Prozent aller Zeilen. Erkennbar ist das an einer Partition, die fast so groß ist wie früher die ganze Tabelle, und an Abfragen auf Kfz, die kaum schneller geworden sind.
- Fehlende Partition: Am 1. Januar fehlt die Partition für das neue Jahr. Die Datenbank findet für die neuen Buchungen keine passende Partition und kann die Buchungen je nach Einstellung nicht speichern. Erkennbar ist das an Fehlermeldungen beim Buchen ab Mitternacht des Jahreswechsels.
- Abfrage ohne Partitionsschlüssel: Eine Auswertung filtert nach dem Schadendatum statt nach dem Buchungsjahr, und die Datenbank liest alle 20 Partitionen. Statt eines einzigen Index für die ganze Tabelle durchsucht die Datenbank dann 20 Indizes, einen je Partition. Erkennbar ist das an Abfragen, die nach der Umstellung langsamer sind als vorher.
- Doppelte Belegnummer: Die Datenbank prüft die Eindeutigkeit der Belegnummer nur innerhalb einer Partition. Die Buchhaltung bucht 2025 einen Beleg mit einer Nummer, die es im Jahrgang 2024 schon gibt, und die Datenbank speichert die Buchung ohne Fehlermeldung in der Partition 2025. Erkennbar ist das an Abstimmungsfehlern in der Buchhaltung.
- Zu früh gelöscht: Das Team entfernt die Partition 2007 nach Ablauf der Aufbewahrungsfrist, obwohl Buchungen daraus wegen eines Rechtsstreits noch gebraucht werden. Erkennbar ist das erst, wenn jemand diese Buchungen anfordert und sie nur noch in einer Sicherung zu finden sind.
Weiterführend
Verwandte Ansätze
- Consistent Hashing: verteilt Schlüssel so auf Server, dass beim Hinzufügen oder Entfernen eines Servers nur wenige Daten umziehen müssen.
- Message Ordering: Nachrichtenplattformen halten die Reihenfolge von Nachrichten innerhalb eines Teilstroms ein, nicht über alle Teilströme hinweg.
Werkzeuge und Umsetzungen
- PostgreSQL: Datenbank mit eingebauter Partitionierung nach Bereichen, Listen und Streuwerten.
- MariaDB: Datenbank, die Tabellen mit mehreren Verfahren partitionieren kann.
- pg_partman: Erweiterung für PostgreSQL, die zeitbasierte Partitionen automatisch im Voraus anlegt und abgelaufene Partitionen entfernt.
- Apache Kafka: Nachrichtenplattform, die jeden Nachrichtenstrom in Partitionen aufteilt, die parallel verarbeitet werden können.
Quellen
- PostgreSQL: Table Partitioning: Projektdokumentation zur Aufteilung nach Bereichen, Listen und Streuwert, zum Überspringen nicht passender Partitionen, zum schnellen Entfernen ganzer Partitionen und zur Bedingung, dass Eindeutigkeitsregeln den Partitionsschlüssel enthalten müssen.
- Microsoft: Data partitioning guidance: erklärt, warum der Partitionsschlüssel schwer nachträglich zu ändern ist und wie ungleich belastete Partitionen entstehen. Microsoft meint mit Partitionierung dort auch die Verteilung auf getrennte Datenspeicher, also das, was diese Seite Sharding nennt.