
Data Warehouse
Aufbereitete Daten für Auswertungen
Die Idee und ihr Nutzen
Die Geschäftsleitung einer Versicherung möchte jeden Monat sehen, wie viel Geld für Schäden ausgezahlt wurde, aufgeteilt nach Sparte wie Kfz oder Hausrat und nach Region. Die dafür nötigen Angaben liegen in zwei verschiedenen Systemen und sind dort teilweise unterschiedlich benannt. Die Sparte Kfz heißt im Vertragssystem zum Beispiel mal „KFZ“ und mal „Kraftfahrt“. Die Versicherung legt deshalb einen eigenen Datenbestand für Auswertungen an. Sie übernimmt Kopien der benötigten Daten in diesen Datenbestand, vereinheitlicht die Kopien und stellt daraus geprüfte Tabellen für Berichte bereit. So berechnen alle Abteilungen dieselbe Kennzahl nach derselben Regel. Ein solcher Datenbestand heißt Data Warehouse, auf Deutsch Datenlager.

Wie funktioniert es?
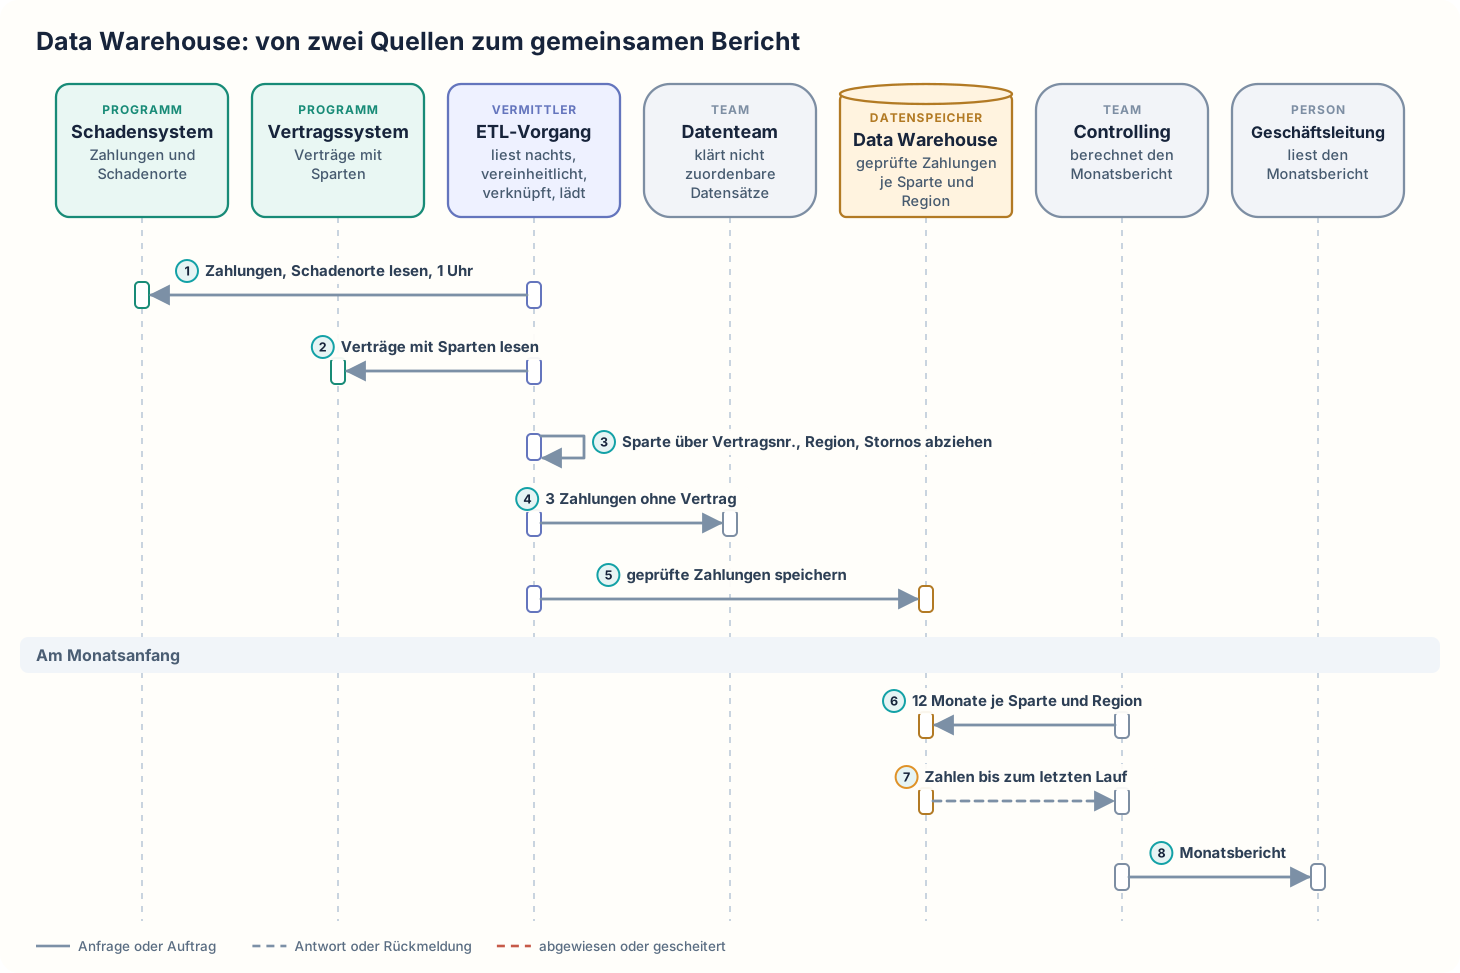
Ein Datenteam betreibt das Data Warehouse und den ETL-Vorgang, einen Programmlauf, der jede Nacht Daten ausliest, umwandelt und in das Data Warehouse lädt. Um 1 Uhr liest der ETL-Vorgang die Zahlungen und Schadenorte aus dem Schadensystem und danach die Verträge mit ihren Sparten aus dem Vertragssystem. Der ETL-Vorgang liest nachts, weil dann in beiden Systemen wenig los ist; die Arbeit darin läuft während des Auslesens weiter. Der ETL-Vorgang ordnet jeder Zahlung über die Vertragsnummer ihre Sparte zu. Im Vertragssystem heißt dieselbe Sparte mal „KFZ“, mal „Kfz“, mal „Kraftfahrt“, und der ETL-Vorgang macht daraus eine einzige Sparte. Aus dem Schadenort leitet er die Berichtsregion ab, und stornierte Zahlungen zieht er ab. In dieser Nacht findet der ETL-Vorgang drei Zahlungen, deren Vertragsnummer im Vertragssystem fehlt. Er meldet sie dem Datenteam, statt ihre Sparte zu raten. Danach speichert der ETL-Vorgang die geprüften Zahlungen im Data Warehouse, und erst jetzt sehen Abfragen den neuen Stand. Am Monatsanfang fragt das Controlling im Data Warehouse die Zahlungen der letzten 12 Monate je Sparte und Region ab und berechnet daraus den Monatsbericht. Zwölf Monate umfassen ein ganzes Jahr, sodass jahreszeitliche Häufungen wie Sturmschäden im Winter die Summen je Sparte und Region nicht verzerren. Der Bericht enthält alle Zahlungen bis zum letzten erfolgreichen nächtlichen Lauf. Erfasst ein Sachbearbeiter am Vormittag eine Zahlung, erscheint die Zahlung erst nach dem nächsten Lauf. Das Controlling gibt den Monatsbericht an die Geschäftsleitung weiter. Die Geschäftsleitung und die Schadenabteilung lesen denselben Bericht und sehen dieselben Zahlen.
Schadensystem und Vertragssystem sind operative Systeme: Sachbearbeiter erfassen und ändern darin den ganzen Tag einzelne Schäden und Verträge, und beide Systeme sind für viele kurze Zugriffe auf einzelne Datensätze gebaut. Die beiden Systeme gehören verschiedenen Fachbereichen, wurden zu verschiedenen Zeiten eingeführt und benennen dieselben Dinge deshalb nicht einheitlich. Die Tabellen im Data Warehouse enthalten nur Kopien. Geändert werden Zahlungen und Verträge weiterhin nur in den operativen Systemen. Das Data Warehouse liegt meist in einer Datenbank, die Summen über Millionen Zeilen schnell berechnet, etwa weil sie die Daten spaltenweise speichert. Welche Felder übernommen werden und nach welchen Regeln gerechnet wird, vereinbart das Datenteam vorher mit Schadenabteilung, Vertragsbereich und Controlling. Eine solche Regel legt zum Beispiel fest, dass stornierte Zahlungen abgezogen werden. Der Name ETL steht für die englischen Wörter Extract, Transform, Load, auf Deutsch Auslesen, Umwandeln, Laden. „Laden“ bezeichnet hier das Speichern im Data Warehouse, nicht das spätere Öffnen eines Berichts. Bei einer verbreiteten Abwandlung werden die Rohkopien zuerst ins Data Warehouse geladen und erst dort umgewandelt. Diese Abwandlung heißt entsprechend ELT.
Die Tabellen im Data Warehouse werden nach den Merkmalen angeordnet, nach denen Berichte die Beträge zusammenfassen. Eine übliche Anordnung ist das Sternschema: Eine Tabelle in der Mitte enthält alle einzelnen Zahlungen mit Betrag, und darum herum beschreiben weitere Tabellen Zeit, Sparte und Region. Über gemeinsame Kennungen kann ein Bericht die Beträge nach jedem dieser Merkmale zusammenfassen, etwa alle Zahlungen für Kfz in der Region Nord im März. Soll ein Bericht auch frühere Zuordnungen zeigen, muss das Data Warehouse diese früheren Stände ausdrücklich aufbewahren. Ist zum Beispiel ein Kunde mit seinem Vertrag in eine andere Region umgezogen, braucht ein solcher Bericht auch die Region vor dem Umzug.
Scheitert ein nächtlicher Lauf, etwa weil das Vertragssystem nicht erreichbar ist, bleiben die Tabellen auf dem Stand des letzten erfolgreichen Laufs. Berichte zeigen dann ältere Zahlen, bis das Datenteam den Lauf wiederholt hat.
Data Warehouse: von zwei Quellen zum gemeinsamen Bericht
Wann ist es sinnvoll und wann nicht?
Ein Data Warehouse lohnt sich
- Wiederkehrende Berichte und Kennzahlen müssen verlässlich und für alle gleich sein. Rechnen das Controlling und die Schadenabteilung die Summen jeweils selbst aus, melden sie oft unterschiedliche Zahlen. Das Controlling zieht zum Beispiel stornierte Zahlungen ab und die Schadenabteilung nicht. In der Sitzung der Geschäftsleitung streiten die Teilnehmer dann über die richtige Zahl statt über die Entscheidung. Mit einem Data Warehouse werden „KFZ“, „Kfz“ und „Kraftfahrt“ einmal nach einer vereinbarten Regel vereinheitlicht und nicht in jeder Abteilung neu.
- Auswertungen reichen über lange Zeiträume und über mehrere Quellsysteme hinweg. Große Auswertungen über zwölf Monate direkt im Schadensystem zu rechnen, bremst das Schadensystem, während Sachbearbeiter darin arbeiten. Im Data Warehouse bremst die Auswertung das Schadensystem nicht.
- Aufsichtsbehörden oder Wirtschaftsprüfer verlangen nachvollziehbare Zahlen. Ohne Data Warehouse rechnet jede Abteilung nach eigenen Regeln, und niemand kann einem Prüfer zeigen, wie eine Zahl im Bericht entstanden ist. Die vereinbarten Regeln des ETL-Vorgangs zeigen, wie jede Zahl im Bericht entstanden ist, etwa dass stornierte Zahlungen abgezogen sind.
Ein Data Warehouse ist nicht das Richtige
- Entscheidungen brauchen sofort neue Daten. Die Schadenabteilung will zum Beispiel während eines Sturms stündlich sehen, wie viel Geld schon ausgezahlt wurde. Ein nur nachts befülltes Data Warehouse zeigt eine Zahlung erst am nächsten Morgen. Dann wertet ein eigenes Programm des Datenteams jede neue Zahlung aus, sobald das Schadensystem sie meldet, und niemand wartet bis zum nächsten Lauf. Dieses Vorgehen heißt Stream Processing. Eine laufende Übernahme ins Data Warehouse ist auch möglich, muss aber eigens eingerichtet und überwacht werden.
- Die Daten bestehen vor allem aus Fotos und PDF-Dokumenten, und noch ist offen, welche Fragen später gestellt werden. Solche Dateien liefern nicht von selbst Berichtszahlen. Ihre Inhalte müssen dafür erst ausgelesen werden, etwa durch Texterkennung. Dann bewahrt die Versicherung die Dateien in ihren ursprünglichen Formaten in einem Data Lake auf, einem großen Speicher für Rohdaten. Tabellen und Aufbereitungsregeln baut das Datenteam erst, wenn eine konkrete Frage auftaucht. Ein Data Warehouse kann später aufbereitete Daten aus dem Data Lake beziehen.
- Alle benötigten Angaben liegen in einem einzigen System mit einheitlichen Begriffen, und die Berichte werten nur wenige Daten aus. Es gibt dann keine unterschiedlichen Namen zu vereinheitlichen und keine Daten aus zwei Systemen zu verknüpfen. Deshalb genügt oft eine Lesekopie dieses Systems. Das ist eine Kopie seiner Datenbank, die das Datenbanksystem selbst laufend nachführt. Die Berichte laufen auf der Lesekopie, ohne die Sachbearbeiter zu bremsen. Einen ETL-Vorgang, der gebaut und gepflegt werden muss, braucht die Versicherung dann nicht.
- Die Fachbereiche sollen die Aufbereitung ihrer Daten selbst verantworten, statt sie einem Datenteam zu übergeben. Im Data Warehouse liegt die Aufbereitung aber beim Datenteam. Stattdessen bereitet die Schadenabteilung die Zahlungen selbst auf, der Vertragsbereich die Verträge, und beide stellen ihre Daten mit Beschreibung und Ansprechpartner für andere bereit. Dieses Vorgehen heißt Data Mesh. Das Datenteam muss die Bedeutung der Daten dann nicht bei Schadenabteilung und Vertragsbereich erfragen und betreut nur noch die gemeinsame Technik für Speicher und Zugriffsrechte.
Nachteile und typische Fehler
Die Daten im Data Warehouse sind nur so aktuell wie der letzte erfolgreiche Lauf des ETL-Vorgangs. Eine neue Frage kann zusätzliche Quelldaten, Tabellen oder Aufbereitungsregeln erfordern. Wie lange das dauert, hängt davon ab, was bereits vorhanden ist. Der ETL-Vorgang muss gebaut und dauerhaft gepflegt werden. Jede Änderung in einem Quellsystem, etwa ein umbenanntes Feld, muss im ETL-Vorgang nachgezogen werden. Das Data Warehouse ist außerdem eine eigene Datenbank mit eigenem Speicherplatz, eigenen Zugriffsrechten und einem Datenteam, das die Läufe überwacht und nicht zuordenbare Datensätze klärt. Die Fachbereiche müssen ihre Rechenregeln mit diesem Datenteam abstimmen, bevor eine Kennzahl im Bericht erscheint.
Typische Fehler und woran man sie erkennt:
- Abgebrochene Übernahme: Ein Quellsystem benennt ein Feld um, und der ETL-Vorgang bricht ab oder liest das Feld nicht mehr. Erkennbar ist das an gescheiterten nächtlichen Läufen oder an plötzlich leeren Spalten im Bericht.
- Glaubwürdige falsche Zahlen: Die Aufbereitungsregeln sind falsch umgesetzt. Zum Beispiel zieht der ETL-Vorgang stornierte Zahlungen nicht ab, und die Summen im Monatsbericht sind um die stornierten Beträge zu hoch. Die falschen Zahlen erscheinen besonders glaubwürdig, weil sie aus einer offiziellen Quelle kommen. Erkennbar ist das erst, wenn jemand die Summen mit dem Schadensystem abgleicht.
- Stillschweigend verworfene Datensätze: Der ETL-Vorgang lässt Zahlungen ohne passenden Vertrag einfach weg, statt sie dem Datenteam zu melden. Die Monatssumme ist dann zu niedrig. Erkennbar ist das an einer Abweichung zwischen der Summe im Data Warehouse und der Summe im Schadensystem.
- Unbemerkt veralteter Stand: Mehrere nächtliche Läufe scheitern, ohne dass jemand benachrichtigt wird. Der Bericht zeigt alte Zahlen, ohne dass seine Leser es merken. Erkennbar ist das, wenn der Bericht den Zeitpunkt des letzten erfolgreichen Laufs nicht anzeigt oder dieser Zeitpunkt Tage zurückliegt.
Weiterführend
Verwandte Ansätze
- Batch Processing: verarbeitet große Datenmengen gesammelt in festen Läufen. So wird ein Data Warehouse typischerweise befüllt.
- Materialized View: vorberechnete Abfrageergebnisse, wie sie auch in Data Warehouses genutzt werden.
Werkzeuge und Umsetzungen
- ClickHouse: Datenbank, die Daten spaltenweise speichert und dadurch Auswertungen über sehr viele Zeilen schnell beantworten kann.
- Apache Doris: Datenbank für Auswertungen und Berichte, die Daten spaltenweise speichert und Abfragen auf mehrere Rechner verteilt.
- DuckDB: Datenbank für Auswertungen, die ohne eigenen Server innerhalb eines Programms oder auf dem eigenen Rechner läuft.
- dbt Core: beschreibt den Schritt „Umwandeln“ als versionierten Code in der Abfragesprache SQL, mit Tests.
- Apache Airflow: startet nächtliche ETL-Vorgänge nach Zeitplan und überwacht, ob sie gelingen.
Quellen
- Ralph Kimball, Margy Ross: The Data Warehouse Toolkit, 3rd Edition: Standardwerk von 2013 zum Aufbau der Tabellen eines Data Warehouse, einschließlich der Verfahren, frühere Stände aufzubewahren.
- Google Cloud: Daten-Pipelines für BigQuery migrieren: beschreibt ETL, ELT und die Unterschiede zwischen nächtlicher und laufender Übernahme.
- IBM: ETL, Extrahieren, Umwandeln und Laden: erklärt die drei Schritte und ihre Abwandlung ELT.