
Batch Processing
Große Datenmengen gesammelt verarbeiten
Die Idee und ihr Nutzen
Eine Versicherung muss am Ersten jedes Monats für 1,2 Millionen Verträge den fälligen Beitrag berechnen und der Bank in einer Datei mitteilen, welche Beträge die Bank von welchen Konten abbuchen soll. Statt jeden Beitrag einzeln zu berechnen, sobald er fällig wird, verarbeitet ein Programm alle fälligen Verträge gesammelt in einem geplanten Lauf in der Nacht. Weil der Lauf nachts stattfindet, bremst er tagsüber weder das Kundenportal noch die Sachbearbeiter, obwohl beide dieselbe Vertragsdatenbank nutzen. Diese gesammelte Verarbeitung heißt Batch Processing, auf Deutsch Stapelverarbeitung. Der Stapel sind hier die 1,2 Millionen fälligen Verträge, die das Programm in einem Durchgang abarbeitet.

Wie funktioniert es?
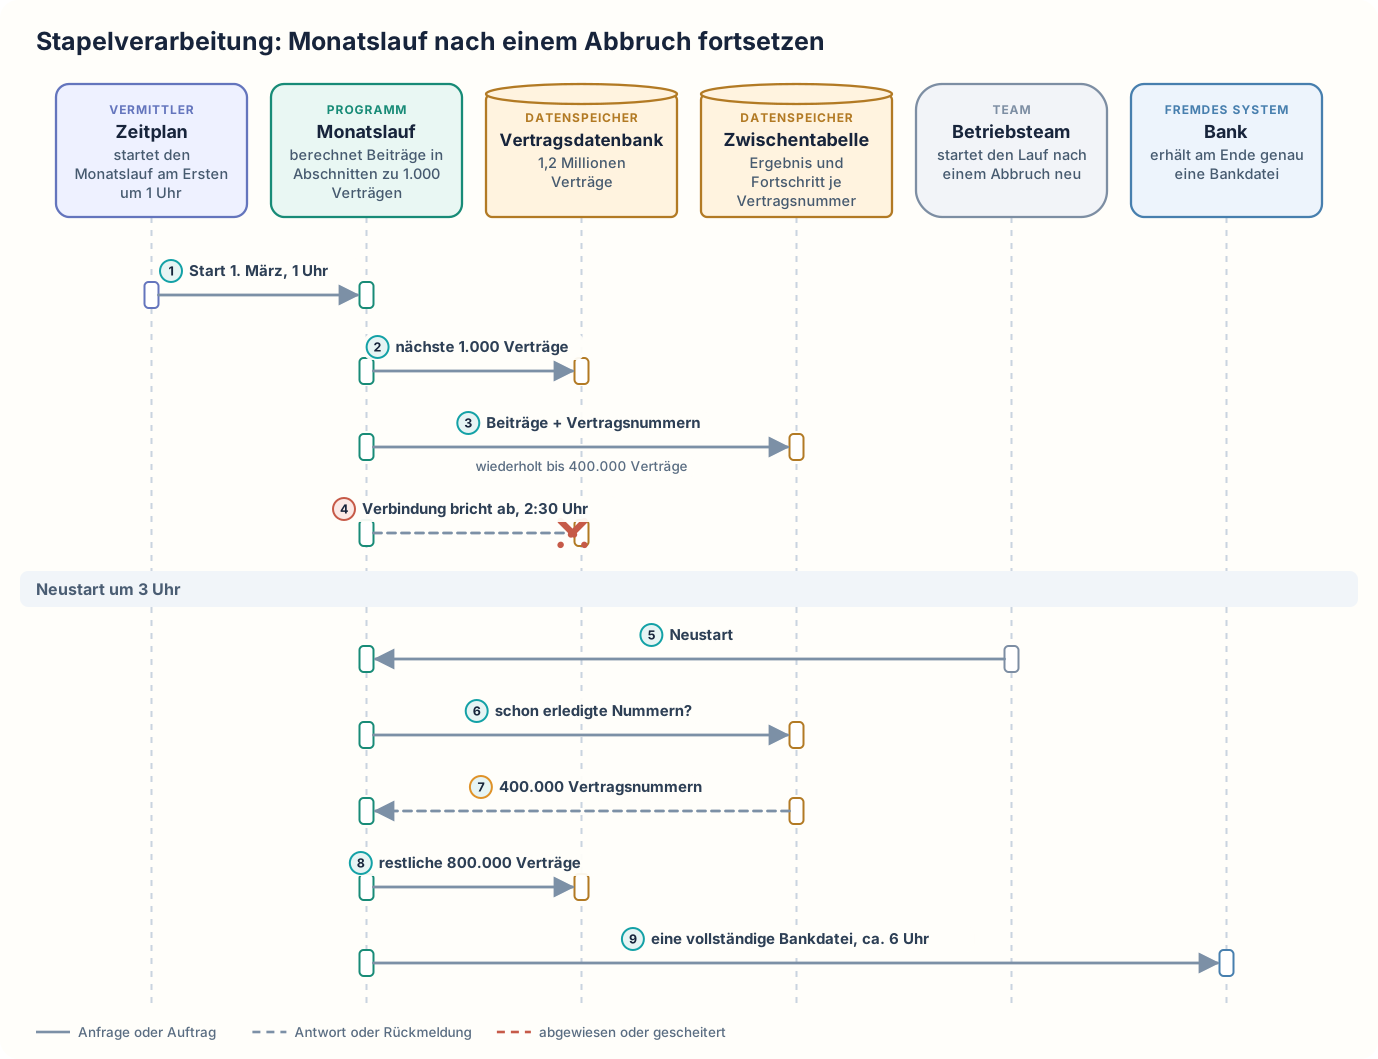
Der Zeitplan ist ein Programm, das andere Programme zu festgelegten Zeiten startet. In der Nacht zum ersten März startet der Zeitplan um 1 Uhr den Monatslauf, das Programm, das die Beiträge berechnet. Der Monatslauf liest die 1,2 Millionen Verträge in Abschnitten zu je 1.000 aus der Vertragsdatenbank. Alle Verträge auf einmal zu laden, bräuchte mehr Arbeitsspeicher, als der Rechner hat. Ein Abschnitt von 1.000 Verträgen belegt wenig Arbeitsspeicher, und bei einem Abbruch muss der Monatslauf höchstens diesen einen Abschnitt neu berechnen. Für jeden Vertrag berechnet der Monatslauf den Beitrag und prüft ihn. Geprüft wird zum Beispiel, ob für den Vertrag ein Konto hinterlegt ist. Jeden Beitrag speichert der Monatslauf zusammen mit der Vertragsnummer in der Zwischentabelle, einer eigenen Tabelle für die Ergebnisse des Laufs. Um 2:30 Uhr, nach 400.000 Verträgen, bricht die Verbindung zur Vertragsdatenbank ab, und der Monatslauf stoppt. An die Bank hat er bis dahin nichts geschickt. Das Betriebsteam überwacht die nächtlichen Läufe. Um 3 Uhr startet das Betriebsteam den Monatslauf neu. Der Monatslauf fragt zuerst die Zwischentabelle nach den Vertragsnummern der schon berechneten Verträge und erhält 400.000 Nummern zurück. Die Verträge mit diesen Nummern überspringt er und berechnet nur die übrigen 800.000 Beiträge. Erst wenn alle 1,2 Millionen Beiträge berechnet und geprüft sind, erzeugt der Monatslauf gegen 6 Uhr eine einzige, vollständige Bankdatei und schickt sie an die Bank. Zum Schluss schreibt der Monatslauf einen Bericht, der am Morgen auf einen Blick zeigt, wie viele Verträge verarbeitet, übersprungen oder abgelehnt wurden.
Der Monatslauf ist ein Stapellauf, also ein Programmlauf, der eine abgegrenzte Menge von Daten in einem Durchgang verarbeitet, hier die fälligen Verträge eines Monats. Für den Monatslauf steht ein festes Zeitfenster zur Verfügung, die Nacht von 1 bis 7 Uhr; ab 7 Uhr arbeiten die ersten Sachbearbeiter. Ein Zeitfenster ist eine vereinbarte Zeitspanne, in der wenig andere Programme auf die Vertragsdatenbank zugreifen. Ein Lauf über 1,2 Millionen Verträge dauert Stunden, und in dieser Zeit kann der Lauf abbrechen, etwa durch einen Netzfehler oder den Neustart eines Servers. Startet das Betriebsteam den Monatslauf nach einem Abbruch von vorn, dauert der Monatslauf noch länger. Setzt das Betriebsteam den Monatslauf fort, ohne zu prüfen, welche Verträge schon berechnet sind, fehlen Beiträge oder stehen doppelt in der Bankdatei. Deshalb steht in der Zwischentabelle zu jedem fertigen Beitrag die Vertragsnummer, und die Zwischentabelle zeigt zugleich den Fortschritt: Jeder Vertrag, der in der Zwischentabelle steht, ist erledigt. Ein Beitrag kann deshalb nicht gespeichert sein, ohne dass sein Vertrag als erledigt gilt, und umgekehrt. Der Monatslauf speichert außerdem jeden Abschnitt von 1.000 Verträgen in einer eigenen Datenbanktransaktion. Eine Datenbanktransaktion fasst mehrere Schreibbefehle so zusammen, dass die Datenbank entweder alle bestätigt oder keinen. Nach einem Abbruch stehen deshalb nur vollständig gespeicherte Abschnitte in der Zwischentabelle. Die Bank ist ein externer Partner: Sie nimmt Abbuchungsaufträge als Datei für einen Zeitraum an und führt die Abbuchungen selbst aus. Wann und wie die Bankdatei entsteht, bestimmt die Versicherung. Wie die Bank die Datei verarbeitet, bestimmt die Versicherung nicht.
Ein Abbruch heißt nicht, dass der zuletzt bearbeitete Abschnitt gespeichert ist. Wurde die Datenbanktransaktion dieses Abschnitts nicht mehr bestätigt, fehlen seine Vertragsnummern in der Zwischentabelle, und der Monatslauf berechnet den Abschnitt nach dem Neustart noch einmal. Die Bankdatei entsteht mit Absicht erst ganz am Ende: Hätte der Monatslauf nach jedem Abschnitt schon Aufträge an die Bank geschickt, wüsste nach dem Abbruch niemand sicher, welche davon angekommen sind. Ob die Bank die fertige Bankdatei angenommen hat, wird in einem eigenen Schritt nach dem Monatslauf kontrolliert. Ein erneuter Start des Monatslaufs darf die Bankdatei nicht ein zweites Mal verschicken, sonst würde den Kunden der Beitrag doppelt abgebucht. Nicht jeder Stapellauf beginnt zu einer festen Uhrzeit. Manche Läufe starten, sobald eine erwartete Datei eintrifft. Sehr große Läufe lassen sich außerdem in Teile zerlegen. Auf mehreren Rechnern läuft dann je ein Exemplar desselben Programms und bearbeitet einen eigenen Teil, beim Monatslauf etwa einen eigenen Bereich von Vertragsnummern. Das geht, weil der Monatslauf jeden Beitrag unabhängig von den übrigen Verträgen berechnet.
Stapelverarbeitung: Monatslauf nach einem Abbruch fortsetzen
Wann ist es sinnvoll und wann nicht?
Stapelverarbeitung lohnt sich
- Sehr viele Datensätze müssen auf einmal verarbeitet werden, und das Ergebnis wird nicht sofort gebraucht. Typische Fälle sind Abrechnungen, Berichte, Datenübernahmen zwischen Systemen und nächtliche Abgleiche. Auch die Anpassung aller Verträge an neue Tarife zum Jahreswechsel gehört dazu. Ohne Stapelverarbeitung liest ein Programm jeden Vertrag mit einer eigenen Anfrage aus der Vertragsdatenbank, statt 1.000 Verträge mit einer Anfrage.
- Die Arbeit würde tagsüber andere Programme bremsen. Würde ein Programm die Beiträge tagsüber und jeweils sofort berechnen, konkurrierte es mit den Anfragen von Kunden und Sachbearbeitern um dieselbe Vertragsdatenbank, und alle Anfragen würden langsamer beantwortet.
- Ein Empfänger erwartet eine vollständige Datei für einen Zeitraum. Die Bank erhält eine einzige Bankdatei für den Monat statt 1,2 Millionen einzelner Aufträge. Werden die Beiträge einzeln bei Fälligkeit berechnet, muss ein zusätzlicher Schritt sie doch wieder zu einer Bankdatei für den Monat zusammenfassen.
- Eine Aufgabe braucht einen abgeschlossenen Zeitraum. Ein Monatsbericht kann erst entstehen, wenn der Monat vorbei ist. Ebenso kann der Bericht an die Versicherungsaufsicht über alle Schadenfälle eines Quartals erst nach dem Quartal entstehen.
Stapelverarbeitung ist nicht das Richtige
- Menschen brauchen das Ergebnis sofort. Ein Sachbearbeiter will zum Beispiel sofort wissen, ob ein gerade gemeldeter Schaden gedeckt ist. Dann verarbeitet das Programm, mit dem der Sachbearbeiter arbeitet, jeden Fall einzeln, sobald er eintrifft. Der Sachbearbeiter erhält die Antwort nach Sekunden und wartet nicht bis zum nächsten Morgen auf einen nächtlichen Lauf.
- Neue Daten treffen ständig ein und sollen nach Sekunden oder wenigen Minuten ausgewertet sein. Ein Beispiel ist eine Betrugsprüfung bei jeder Schadenmeldung. Dann verarbeitet ein Programm die Daten mit Stream Processing, also jedes Ereignis, sobald es eintrifft. Eine verdächtige Schadenmeldung fällt so nach Sekunden auf und nicht erst nach dem nächtlichen Lauf am nächsten Morgen.
- Gebraucht werden sofort verfügbare, vorläufige Zahlen und zusätzlich genaue Zahlen für einen abgeschlossenen Zeitraum. Eine Stapelverarbeitung allein liefert Zahlen erst nach dem nächtlichen Lauf. Dann betreibt die Versicherung eine Lambda Architecture. Darin laufen eine Stapelverarbeitung für die genauen Zahlen und daneben eine sofortige Verarbeitung für die vorläufigen Zahlen. Die vorläufigen Zahlen liegen so schon tagsüber vor und nicht erst nach dem nächtlichen Lauf. Dafür muss die Versicherung beide Verarbeitungen betreiben und pflegen.
- Die Datenmenge ist so klein, dass jeder Vorgang sofort erledigt werden kann, ohne andere Programme spürbar zu bremsen, und kein Empfänger erwartet eine gesammelte Datei für einen Zeitraum. Dann erledigt das Programm jeden Vorgang sofort, sobald er anfällt. Ein eigener Lauf mit Zeitplan, Zwischentabelle und Regeln für den Neustart entfällt.
Nachteile und typische Fehler
Die Ergebnisse liegen erst nach dem Ende des Laufs vor. Der Monatslauf muss in sein Zeitfenster passen. Wächst die Zahl der Verträge, reicht die Nacht irgendwann nicht mehr, und der Monatslauf muss beschleunigt oder auf mehrere Rechner verteilt werden. Damit ein Lauf nach einem Abbruch fortgesetzt werden kann, braucht er eine Zwischentabelle, eine Abfrage des Fortschritts beim Start und einen eigenen Schritt, der die Übergabe an die Bank kontrolliert. Hängen viele Läufe voneinander ab, muss ihre Reihenfolge im Zeitplan gepflegt werden. Ein Beispiel ist die Reihenfolge „erst Beiträge, dann Mahnungen, dann Bericht“. Ein verspäteter Lauf verzögert dabei alle folgenden.
Typische Fehler und woran man sie erkennt:
- Ergebnis und Fortschritt getrennt gespeichert: Der Lauf schreibt die Beiträge in eine Tabelle und den Fortschritt in eine andere. Beim Abbruch sind die Beiträge eines Abschnitts zum Beispiel schon gespeichert, der Fortschritt aber noch nicht. Nach dem Neustart berechnet der Monatslauf diesen Abschnitt noch einmal, und 1.000 Beiträge stehen doppelt in der Bankdatei. Im umgekehrten Fall ist der Fortschritt gespeichert, die Beiträge aber nicht. Der Monatslauf überspringt den Abschnitt dann, und seine 1.000 Beiträge fehlen. Erkennbar ist das an Abweichungen zwischen der Zahl der fälligen Verträge und der Zahl der Einträge in der Bankdatei.
- Bankdatei doppelt verschickt: Die Übertragung der Bankdatei meldet einen Fehler, obwohl die Bank die Bankdatei erhalten hat. Das Betriebsteam startet den Monatslauf erneut. Der Monatslauf schickt dieselbe Bankdatei ein zweites Mal an die Bank. Die Bank führt beide Bankdateien aus und bucht den Kunden den Beitrag doppelt ab. Erkennbar ist das an Beschwerden über doppelte Abbuchungen und an zwei Übertragungen mit demselben Abrechnungsmonat im Protokoll.
- Zeitfenster überschritten: Der Monatslauf ist um 7 Uhr noch nicht fertig und konkurriert mit den Anfragen von Kunden und Sachbearbeitern um die Vertragsdatenbank. Erkennbar ist das an langsamen Seiten im Kundenportal am Morgen des Ersten und an Laufzeiten, die von Monat zu Monat wachsen.
- Abbruch unbemerkt: Der Monatslauf stoppt in der Nacht, ohne dass jemand benachrichtigt wird, und am Morgen fehlt die Bankdatei. Erkennbar ist das erst, wenn die Bank keine Datei erhalten hat oder Beiträge nicht abgebucht wurden.
- Verspäteter Vorgängerlauf: Ein Lauf startet zu seiner festen Zeit, obwohl der Lauf, dessen Ergebnis er braucht, noch nicht fertig ist. Startet etwa der Mahnlauf vor dem Ende des Monatslaufs, verarbeitet der Mahnlauf den Stand vom Vormonat. Erkennbar ist das an Mahnungen für Beiträge, die bereits bezahlt sind.
Weiterführend
Verwandte Ansätze
- Master Worker: teilt einen großen Lauf in Teile auf und verteilt sie auf mehrere Rechner.
- Idempotency: sorgt dafür, dass ein wiederholt ausgeführter Teil eines Laufs kein doppeltes Ergebnis erzeugt.
Werkzeuge und Umsetzungen
- Spring Batch: Rahmenwerk für Stapelläufe in Java. Spring Batch liest und schreibt in Abschnitten, speichert den Fortschritt in einer Datenbank und kann einen abgebrochenen Lauf nach dem letzten gespeicherten Abschnitt fortsetzen.
- Apache Spark: verteilt die Verarbeitung sehr großer Datenmengen auf viele Rechner.
- Apache Airflow: startet Läufe nach Zeitplan und steuert, welcher Lauf erst nach welchem anderen beginnen darf. Die eigentliche Verarbeitung erledigen die gestarteten Programme.
Quellen
- Microsoft: Choose a batch processing technology in Azure: beschreibt Stapelverarbeitung mit Wartezeiten von Minuten bis Stunden zwischen Datenaufnahme und Ergebnis und die Verteilung großer Datenmengen auf viele Rechner.
- Spring Batch: Chunk-oriented Processing: Projektdokumentation zum abschnittsweisen Lesen, Verarbeiten und Schreiben, bei dem jeder Abschnitt innerhalb einer Transaktion geschrieben wird.