
Master Worker
Ein Master zerlegt die Arbeit, Worker erledigen die Teile
Die Idee und ihr Nutzen
Nach einer Tarifänderung muss eine Versicherung für zwei Millionen Verträge den Beitrag neu berechnen. Ein einzelner Rechner bräuchte dafür viele Stunden. Deshalb teilt ein steuerndes Programm, der Master, die Verträge in 2.000 Pakete zu je 1.000 Verträgen. Die Pakete vergibt der Master nacheinander an 40 Exemplare desselben Rechenprogramms, die Worker. Weil jedes Paket dieselbe Berechnung braucht, kann jeder Worker jedes Paket berechnen, und die 40 Worker rechnen gleichzeitig. Die Rechner, die im Rechenzentrum dafür bereitstehen, können höchstens 40 Worker gleichzeitig ausführen. Ein Paket mit 1.000 Verträgen ist in etwa 30 Sekunden berechnet. Stürzt ein Worker ab, vergibt der Master das Paket dieses Workers neu, und verloren ist höchstens diese halbe Minute Rechenarbeit. Dieses Vorgehen heißt Master Worker, auf Deutsch etwa Leiter und Arbeiter.

Wie funktioniert es?
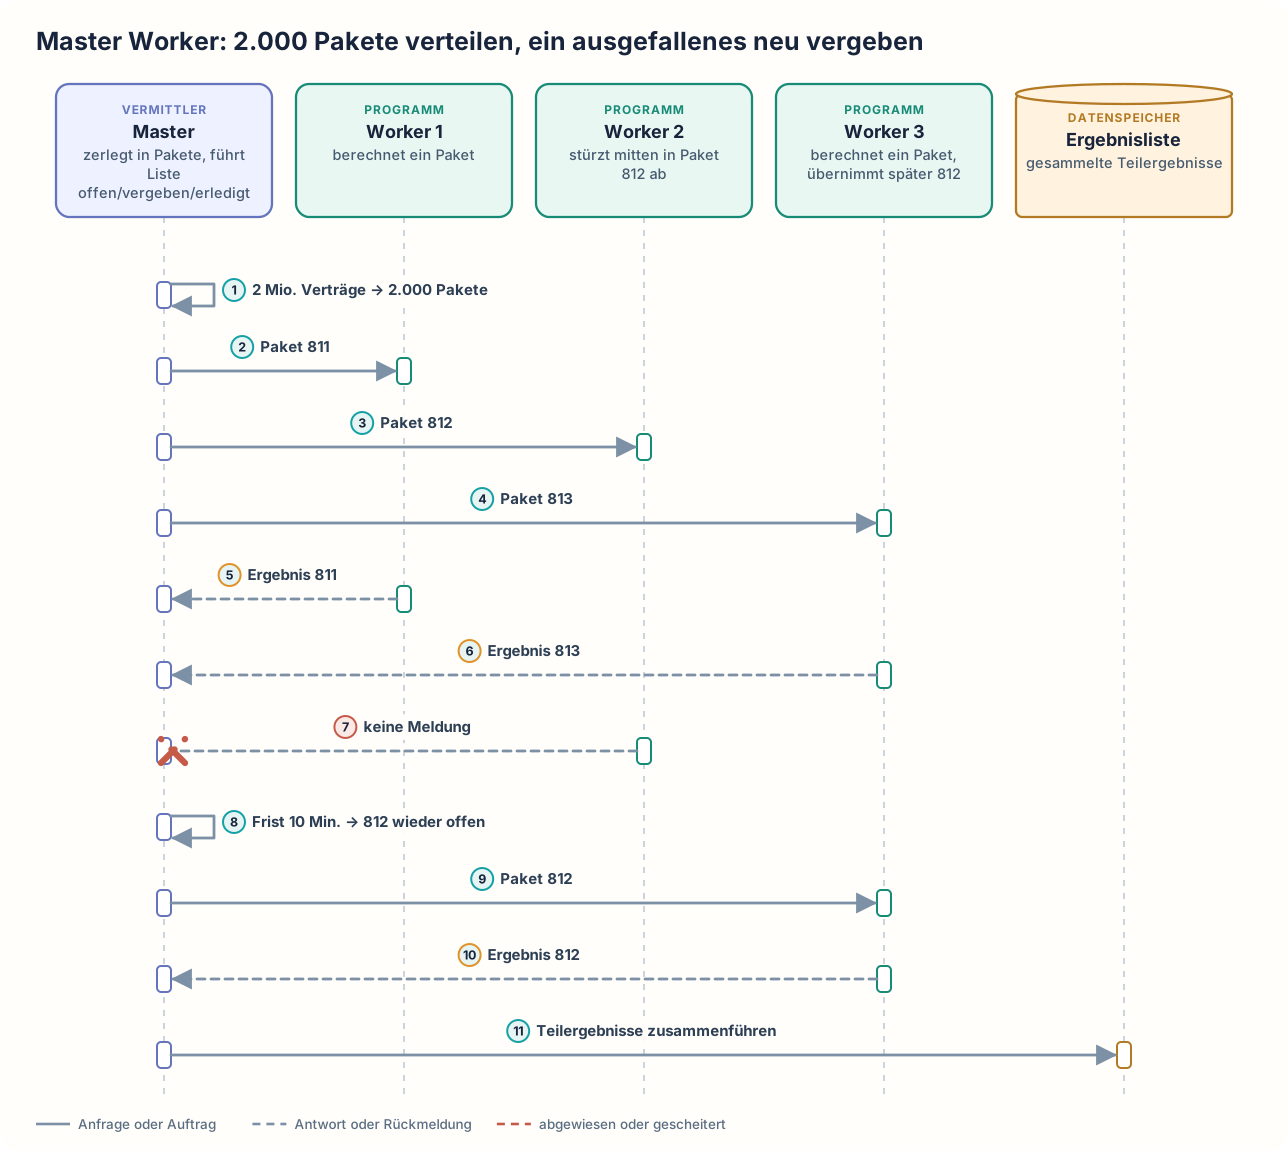
Zuerst teilt der Master die zwei Millionen Verträge in 2.000 Pakete zu je 1.000 Verträgen und trägt jedes Paket als „offen“ in seine Paketliste ein. Jeder der 40 Worker holt sich ein Paket nach dem anderen. Mitten im Lauf erhält Worker 1 Paket 811, Worker 2 Paket 812 und Worker 3 Paket 813. Jedes vergebene Paket setzt der Master auf „vergeben“ und merkt sich eine Frist von zehn Minuten, bis zu der sich der Worker zurückmelden muss. Die Frist ist mit zehn Minuten weit länger als die etwa 30 Sekunden, die ein Paket üblicherweise braucht. So vergibt der Master kein Paket neu, an dem ein langsamer Worker noch rechnet. Worker 1 und Worker 3 melden ihre Ergebnisse. Der Master setzt die Pakete 811 und 813 auf „erledigt“, übernimmt die Ergebnisse und gibt beiden Workern je ein weiteres offenes Paket. Worker 2 stürzt mitten in Paket 812 ab und meldet nichts. Nach Ablauf der Frist setzt der Master Paket 812 wieder auf „offen“ und vergibt Paket 812 an Worker 3. Worker 3 berechnet Paket 812 vollständig und meldet das Ergebnis, und der Master übernimmt dieses Ergebnis. Zuletzt führt der Master alle Teilergebnisse in der Ergebnisliste zusammen. Die Berechnung eines Vertrags dauert etwa 30 Millisekunden, auf einem einzelnen Rechner für alle zwei Millionen Verträge also rund 17 Stunden. Mit 40 Workern dauert der Lauf rechnerisch ein Vierzigstel davon, rund 25 Minuten. Tatsächlich dauert er etwas länger, weil die Worker Vertragsdaten laden müssen, manche Pakete mehr Rechenzeit brauchen als andere und auch das Zusammenführen Zeit braucht.
Nur der Master kennt die Gesamtaufgabe und die Paketliste. Ein Worker kennt nur sein Paket. Die Worker laufen auf einer Gruppe gleichartiger Rechner im Rechenzentrum der Versicherung und lesen die Vertragsdaten aus einer gemeinsamen Datenbank. Jedes Paket hat eine eindeutige Nummer, und für jede Paketnummer übernimmt der Master genau ein Ergebnis. Nur über die Rückmeldungen der Worker erfährt der Master, welches Paket erledigt ist.
Ein Worker, der seine Frist überschritten hat, war vielleicht nur langsam und meldet später doch noch ein Ergebnis. Der Master hat für Paket 812 schon das Ergebnis von Worker 3 übernommen. Käme danach noch ein Ergebnis von Worker 2 für Paket 812, würde der Master dieses Ergebnis verwerfen. Die Regel „genau ein Ergebnis je Paket“ sorgt nur dafür, dass kein Vertrag doppelt im Gesamtergebnis steht. Verschickt ein Worker beim Rechnen zum Beispiel Briefe über den neuen Beitrag, muss der Worker vor jedem Brief prüfen, ob für diesen Vertrag schon ein Brief verschickt wurde. Dasselbe gilt für Zahlungen, die ein Worker auslöst.
Master Worker: 2.000 Pakete verteilen, ein ausgefallenes neu vergeben
Wann ist es sinnvoll und wann nicht?
Master Worker lohnt sich
- Der ganze Bestand liegt zu Beginn vor und besteht aus voneinander unabhängigen Teilen. Jeder Vertrag lässt sich zum Beispiel unabhängig von den anderen neu berechnen. Ohne Master Worker rechnet ein einzelnes Programm alle Verträge nacheinander, obwohl sich die Arbeit aufteilen ließe.
- Ein einzelner Rechner schafft die Aufgabe nicht in der verfügbaren Zeit. Die Neuberechnung muss über Nacht laufen und bis zum Morgen fertig sein, weil die Sachbearbeiter ab Arbeitsbeginn mit den neuen Beiträgen arbeiten. Die rund 17 Stunden auf einem einzelnen Rechner sind dafür zu lang. Mit 40 Workern ist der Lauf in etwa einer halben Stunde fertig.
- Einzelne Ausfälle während des Laufs dürfen den Lauf nicht zum Scheitern bringen. Rechnet ein einzelnes Programm alle Verträge in einem Lauf, beginnt es nach einem Absturz von vorn, wenn es keine Zwischenstände speichert. Mit Master Worker erfordert der Absturz von Worker 2 erfordert nur die Neuberechnung von Paket 812, nicht den ganzen Lauf.
- Verteilt man die Arbeit ohne Steuerung auf viele Rechner, weiß keiner, welche Verträge schon erledigt sind. Ebenso unklar ist, welche Verträge gerade bearbeitet werden und welche nach einem Absturz liegen geblieben sind. Dann werden Verträge doppelt oder gar nicht berechnet. Mit dem Master wird kein Vertrag doppelt in das Gesamtergebnis übernommen.
- Es fallen nächtliche Massenberechnungen oder Simulationen an. Ein Beispiel ist eine Risikosimulation mit zehn Millionen Szenarien, die sich unabhängig voneinander rechnen lassen. Ohne Master Worker rechnet ein einzelnes Programm alle zehn Millionen Szenarien nacheinander.
- Große Datenmengen müssen umgewandelt oder große Bestände durchsucht werden. Ein Beispiel ist die Suche in 500.000 Gutachten nach Stichworten. Ohne Master Worker durchsucht ein einzelnes Programm alle 500.000 Gutachten nacheinander.
- Das Betriebsteam will den Fortschritt verfolgen. Ein einzelnes Programm müsste dafür eigens melden, wie weit es ist. Mit Master Worker zeigt die Paketliste zeigt jederzeit, wie viele der 2.000 Pakete offen, vergeben und erledigt sind.
Master Worker ist nicht das Richtige
- Die Teile hängen stark voneinander ab und müssen ständig Zwischenergebnisse austauschen. Worker 1 kennt aber nur sein Paket 811 und erfährt nichts von Paket 812, das Worker 2 berechnet. Dann schreiben die Entwickler die Berechnung als ein einzelnes Programm für einen Rechner mit vielen Rechenkernen. Ein Rechenkern ist der Teil des Prozessors, der eine Berechnung ausführt. Die Teile der Berechnung lesen ihre Zwischenergebnisse dort direkt aus dem gemeinsamen Arbeitsspeicher, statt sie über das Netz zu schicken.
- Die Aufgabe ist klein. Sind zum Beispiel nur 5.000 Verträge neu zu berechnen, braucht ein einzelnes Programm bei 30 Millisekunden je Vertrag zweieinhalb Minuten. Dann berechnet ein einzelnes Programm die Verträge nacheinander. Ein Master, eine Paketliste und 40 Worker, die eingerichtet und überwacht werden müssen, entfallen. Stürzt das Programm ab, startet das Betriebsteam es neu, und verloren sind höchstens zweieinhalb Minuten Rechenarbeit.
- Die Aufträge kommen einzeln und laufend herein statt als ein großer Bestand, etwa neue Schadenmeldungen. Ein Master zerlegt einen Bestand, der zu Beginn vollständig vorliegt, und bei einzeln eintreffenden Schadenmeldungen gibt es nichts zu zerlegen. Dann legt das Programm, das die Schadenmeldungen annimmt, jede Meldung in eine gemeinsame Warteschlange, also einen Speicher, in dem Aufträge der Reihe nach auf ihre Bearbeitung warten. Mehrere Exemplare desselben Bearbeitungsprogramms holen sich die Meldungen von dort, so wie bei Competing Consumers beschrieben. Stürzt ein Exemplar ab, gibt die Warteschlange die unerledigte Meldung nach einer Frist wieder frei, und ein anderes Exemplar bearbeitet sie. Ein eigener Master, der eingerichtet und überwacht werden muss, entfällt.
- Eine einzelne Anfrage soll gleichzeitig an mehrere Empfänger gehen, und die Antworten sollen gesammelt werden, etwa eine Preisanfrage an mehrere Rückversicherer. Hier gibt es nichts zu zerlegen, denn jeder Rückversicherer soll dieselbe Anfrage erhalten. Dann schickt ein Programm die Anfrage an alle Rückversicherer zugleich und sammelt die Antworten ein, so wie bei Scatter Gather beschrieben. Eine Paketliste mit offenen, vergebenen und erledigten Paketen entfällt.
Nachteile und typische Fehler
Der Master ist ein einzelnes Programm, von dem der ganze Lauf abhängt. Damit nach einem Ausfall des Masters ein Ersatz den Lauf fortsetzen kann, braucht es eine Datenbank, in der die Paketliste dauerhaft gespeichert ist, und eine Regel, wer bei einem Ausfall Master wird. Die Paketgröße ist eine Abwägung: Große Pakete bedeuten wenige Meldungen an den Master, erfordern aber nach einem Absturz viel Neuberechnung. Kleine Pakete erhöhen die Zahl der Meldungen an den Master: Pakete zu je 100 Verträgen ergeben 20.000 Meldungen statt 2.000. Auch die Frist muss passen. Ist die Frist kürzer als die übliche Rechenzeit eines Pakets, vergibt der Master Pakete neu, an denen noch gerechnet wird.
Typische Fehler und woran man sie erkennt:
- Verlorene Paketliste: Der Master fällt aus, und seine Paketliste ist nicht dauerhaft gespeichert. Die Worker können ihre Ergebnisse niemandem mehr melden. Nach dem Neustart weiß der Master nicht mehr, welche Pakete erledigt sind, und beginnt wieder bei Paket 1. Lief die Berechnung schon 20 Minuten, ist die Rechenarbeit dieser 20 Minuten aller 40 Worker verloren. Erkennbar ist das an einem Lauf, der nach einem Absturz des Masters wieder bei Paket 1 anfängt.
- Doppelt übernommen: Der Master prüft die Paketnummer nicht, die Regel „genau ein Ergebnis je Paket“ fehlt. War Worker 2 nicht abgestürzt, sondern nur langsam, meldet Worker 2 sein Ergebnis für Paket 812 nach Worker 3 doch noch. Der Master übernimmt beide Ergebnisse, und die 1.000 Verträge aus Paket 812 stehen zweimal im Gesamtergebnis. Erkennbar ist das an mehr Ergebnissen als Verträgen im Gesamtergebnis, etwa 2.001.000 Ergebnissen für zwei Millionen Verträge.
- Nachzügler: Ein Paket braucht viel mehr Rechenzeit als die anderen. Das zuletzt vergebene Paket enthält zum Beispiel Verträge von Großkunden mit vielen Gebäuden und braucht acht Minuten statt 30 Sekunden. Alle anderen Pakete sind längst erledigt. Der Master kann die Teilergebnisse aber erst zusammenführen, wenn auch dieses Paket gemeldet ist. Erkennbar ist das an 39 untätigen Workern, während ein einzelner Worker noch rechnet.
- Datenbank als Engpass: Die Worker laden große Datenmengen aus derselben Datenbank, und die Datenbank kann die Daten nicht schneller liefern. Erhöht das Betriebsteam die Zahl der Worker zum Beispiel von 20 auf 40, fragen doppelt so viele Worker gleichzeitig Vertragsdaten ab. Die Datenbank liefert aber nicht mehr Daten pro Sekunde als vorher, und jeder Worker wartet doppelt so lange auf seine Vertragsdaten. Erkennbar ist das an einer Laufzeit, die sich trotz mehr Workern nicht verkürzt, während die Datenbank voll ausgelastet ist.
- Doppelte Nebenwirkung: Ein Worker verschickt beim Berechnen Briefe über den neuen Beitrag. Worker 2 hat vor seinem Absturz schon für die ersten 400 Verträge aus Paket 812 Briefe verschickt. Nach Ablauf der Frist berechnet Worker 3 Paket 812 vollständig neu und verschickt Briefe für alle 1.000 Verträge. Die Kunden der ersten 400 Verträge erhalten den Brief zweimal. Erkennbar ist das an Kundenbeschwerden über doppelte Post aus genau den neu vergebenen Paketen.
Weiterführend
Verwandte Ansätze
- Batch Processing: die gesammelte Verarbeitung großer Datenmengen in geplanten Läufen, die oft nach diesem Muster verteilt wird.
- Leader Election: bestimmt unter mehreren bereitstehenden Exemplaren des Master-Programms einen neuen Master, wenn der bisherige ausfällt.
- Idempotency: beschreibt, wie ein Vorgang so gebaut wird, dass eine doppelte Ausführung keine zusätzliche Wirkung hat.
Werkzeuge und Umsetzungen
- Apache Spark: Ein steuerndes Programm zerlegt die Arbeit und verteilt sie auf viele ausführende Programme auf verschiedenen Rechnern.
- Apache Hadoop: verteilt große Stapelverarbeitungen nach demselben Prinzip auf viele Rechner.
- Ray: verteilt Aufgaben in Python-Programmen auf viele Rechner, etwa für Simulationen und maschinelles Lernen.
- Dask: verteilt Berechnungen in Python über einen zentralen Planer auf viele Worker.
- Celery: verteilt Aufgaben in Python über eine Warteschlange an viele Worker.
Quellen
- Jeffrey Dean, Sanjay Ghemawat: MapReduce. Simplified Data Processing on Large Clusters: Aufsatz von 2004, in dem ein Master Aufgaben an freie Worker vergibt, ausgefallene Worker erkennt, deren Aufgaben neu vergibt und doppelte Erledigungsmeldungen ignoriert.
- Apache Spark: Cluster Mode Overview: offizielle Dokumentation, die beschreibt, wie ein steuerndes Programm die Arbeit in Aufgaben zerlegt und an ausführende Programme auf mehreren Rechnern schickt.