
Stream Processing
Daten verarbeiten, sobald sie entstehen
Die Idee und ihr Nutzen
Das Betrugsteam einer Versicherung möchte sofort erfahren, wenn aus einer Region plötzlich ungewöhnlich viele Schadenmeldungen eingehen. Bisher zählt ein nächtlicher Lauf alle Meldungen des Vortags, und das Betrugsteam erfährt von einer solchen Häufung erst am nächsten Morgen. Stattdessen läuft nun dauerhaft ein Programm namens „Auswertung“ und verarbeitet jede neue Meldung, sobald sie eintrifft. Die „Auswertung“ zählt für jede Region, wie viele Meldungen in den letzten zehn Minuten eingegangen sind. In zehn Minuten kommen genug Meldungen zusammen, um eine Häufung von gewöhnlichen Schwankungen zu unterscheiden, und die Warnung kommt trotzdem früh. Überschreitet die Zahl eine festgelegte Grenze, warnt die „Auswertung“ das Betrugsteam innerhalb von Minuten. Dieses Vorgehen heißt Stream Processing, auf Deutsch Datenstromverarbeitung. Datenstrom heißt dabei die fortlaufende Folge der eingehenden Meldungen, die anders als die Meldungen eines abgeschlossenen Tages kein festes Ende hat.

Wie funktioniert es?
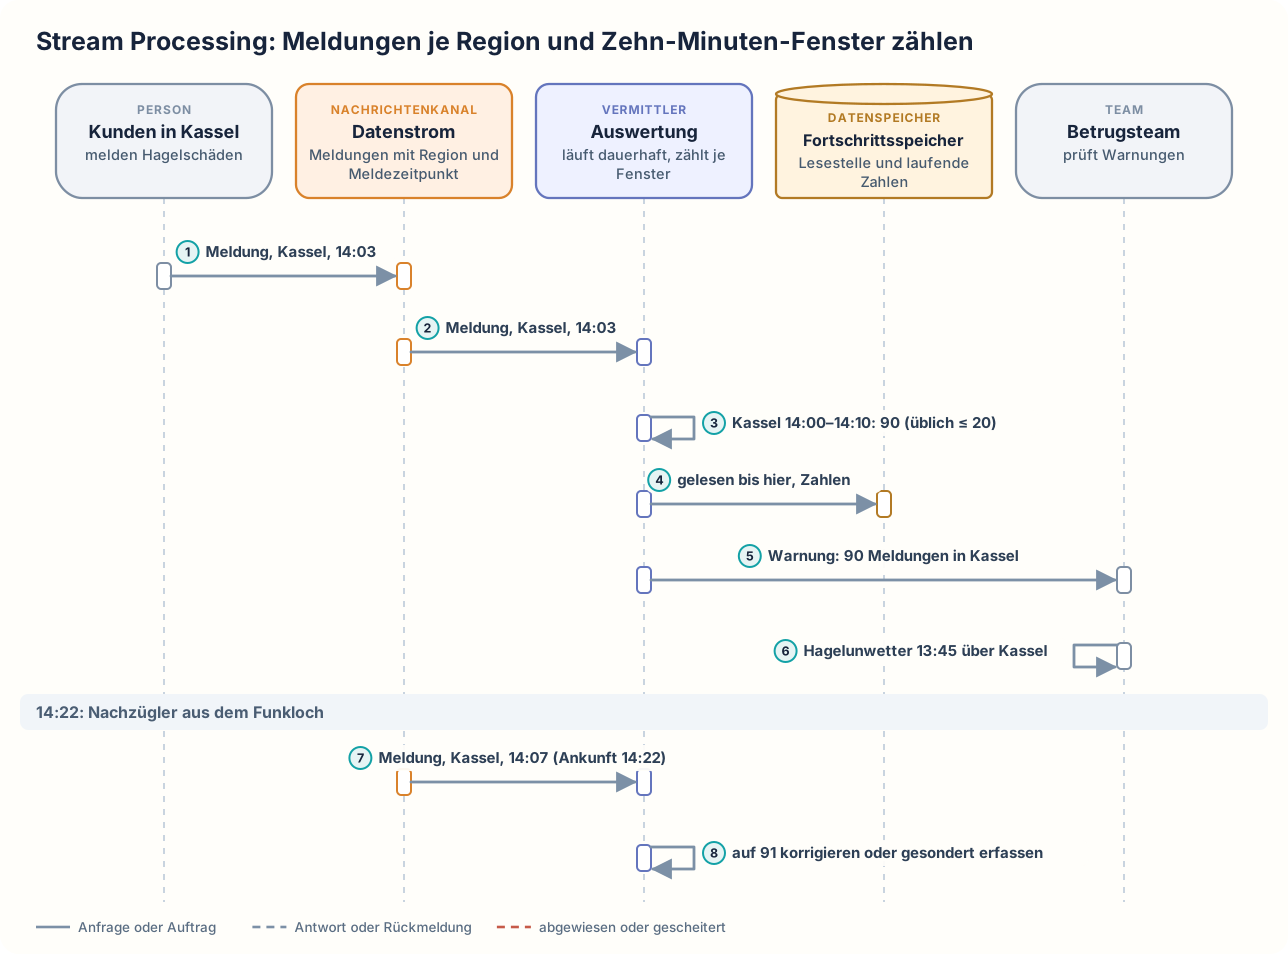
An einem Nachmittag melden Kunden in Kassel Hagelschäden. Jede Meldung wird mit Region und Meldezeitpunkt in den Datenstrom geschrieben. Der Datenstrom liegt auf einer Nachrichtenplattform, also einem Programm, das einzelne Einträge annimmt und in der Reihenfolge ihres Eintreffens bereithält. Jeder Eintrag heißt Ereignis. Ein Beispiel ist „Meldung, Kassel, 14:03“. Die „Auswertung“ zählt in festen Zeitabschnitten von zehn Minuten, die Zeitfenster oder kurz Fenster heißen. Die „Auswertung“ liest das Ereignis sofort, ordnet die Meldung der Region Kassel und dem Fenster von 14:00 bis 14:10 Uhr zu und erhöht die Zahl dieses Fensters. Die „Auswertung“ hat einen eigenen Speicher, den Fortschrittsspeicher. Im Fortschrittsspeicher legt die „Auswertung“ regelmäßig die Lesestelle ab, also das zuletzt gelesene Ereignis, und die Zahlen, die sie gerade führt. In der Region Kassel gehen normalerweise höchstens 20 Meldungen in zehn Minuten ein, und die festgelegte Grenze liegt bei 20 Meldungen. Diesmal erreicht die Zahl im Fenster von 14:00 bis 14:10 Uhr 90 Meldungen. Die Grenze ist überschritten, und die „Auswertung“ warnt das Betrugsteam. Ein Mitarbeiter des Betrugsteams prüft die Warnung und stellt fest, dass um 13:45 Uhr ein schweres Hagelunwetter über Kassel gezogen ist und die meisten Meldungen dazu passen. Ein Kunde schickt um 14:07 Uhr in einem Funkloch eine Meldung ab. Diese Meldung trifft erst um 14:22 Uhr ein. Nach ihrem Meldezeitpunkt gehört die Meldung in das Fenster von 14:00 bis 14:10 Uhr, das bereits abgeschlossen ist. Eine vorher festgelegte Regel entscheidet, ob die „Auswertung“ die Zahl dieses Fensters nachträglich auf 91 korrigiert oder die verspätete Meldung gesondert erfasst.
Das Betrugsteam entscheidet, ob ein Betrug vorliegt. Die „Auswertung“ entscheidet das nicht, denn eine hohe Zahl ist nur ein Anlass zur Prüfung. Bei einem Bericht über einen abgeschlossenen Tag liegen alle Meldungen vor. Beim Datenstrom ist dagegen im Moment der Berechnung oft nicht sicher, ob noch verspätete Meldungen fehlen. Meldet die „Auswertung“ eine Zahl für ein noch offenes Fenster, ist diese Zahl deshalb vorläufig. Die Versicherung legt fachlich fest, ob ein vorläufiges Ergebnis genügt, wann ein Fenster als abgeschlossen gilt und was mit Meldungen geschieht, die danach noch für dieses Fenster eintreffen. Sie legt außerdem fest, ob für die Zuordnung der Zeitpunkt zählt, zu dem der Kunde die Meldung abgeschickt hat, oder der Zeitpunkt, zu dem die Meldung im Datenstrom ankam. Die Meldung aus dem Funkloch gehört nach dem Meldezeitpunkt 14:07 Uhr in das Fenster von 14:00 bis 14:10 Uhr, nach ihrer Ankunft um 14:22 Uhr in das Fenster von 14:20 bis 14:30 Uhr.
Stürzt die „Auswertung“ ab, startet sie mit dem letzten Stand aus dem Fortschrittsspeicher neu und liest ab der dort vermerkten Lesestelle weiter, statt alle Meldungen des Tages erneut zu lesen. Die Ereignisse nach der letzten Sicherung hat die „Auswertung“ vor dem Absturz schon gezählt. Nach dem Neustart liest die „Auswertung“ diese Ereignisse noch einmal. Damit die „Auswertung“ diese Ereignisse nicht doppelt zählt, müssen die Lesestelle und die Zahlen zusammen gesichert werden.
Stream Processing: Meldungen je Region und Zehn-Minuten-Fenster zählen
Wann ist es sinnvoll und wann nicht?
Stream Processing lohnt sich
- Auffälligkeiten müssen innerhalb von Minuten erkannt werden. Nach einem Unwetter versuchen manchmal Betrüger, die Lage auszunutzen, und reichen viele ähnliche, erfundene Meldungen ein. Die Warnung der „Auswertung“ kommt, bevor Auszahlungen für diese Meldungen veranlasst werden, und das Betrugsteam kann einzelne Fälle vorher prüfen. Ein Bericht aus dem nächtlichen Lauf käme dafür zu spät.
- Eine Übersicht soll fortlaufend aktuell sein. Ohne Stream Processing zeigt die Übersicht bis zum nächsten Morgen nur die Zahlen des Vortags. Mit der „Auswertung“ ändert sich die Zahl der Meldungen je Region mit jeder neuen Meldung, und das Betrugsteam kann die Entwicklung während eines Unwetters verfolgen.
- Die Ereignisse treffen ohnehin einzeln und fortlaufend ein. Ein Beispiel sind Meldungen auf einer Nachrichtenplattform. Ohne Stream Processing müssen die Meldungen erst gesammelt werden, damit der nächtliche Lauf sie zählen kann. Die „Auswertung“ zählt jede Meldung, sobald sie auf der Nachrichtenplattform eintrifft.
Stream Processing ist nicht das Richtige
- Die Ergebnisse werden erst am nächsten Tag gebraucht. Eine Warnung innerhalb von Minuten nützt dann niemandem. Stattdessen zählt ein nächtlicher Lauf alle Meldungen des Vortags, wenn sie vollständig vorliegen. Das heißt Batch Processing, auf Deutsch Stapelverarbeitung. Ein solcher Lauf braucht keine Regeln für verspätete Meldungen und keinen Fortschrittsspeicher, weil er nach einem Absturz einfach von vorn beginnt. Er muss auch nicht rund um die Uhr überwacht werden.
- Eine Zahl muss von Anfang an endgültig sein. Beispiele sind eine Abrechnung oder ein Bericht an die Aufsicht. Die „Auswertung“ meldet Zahlen aber schon, solange noch verspätete Meldungen fehlen können, und muss sie dann nachträglich korrigieren. Stattdessen berechnet ein nächtlicher Lauf die Zahl erst, wenn alle Meldungen eines Tages vorliegen. Eine bereits gemeldete Zahl muss danach nicht mehr korrigiert werden.
- Die Versicherung braucht sowohl schnelle vorläufige Zahlen als auch verlässliche Endstände. Die „Auswertung“ allein liefert nur vorläufige Zahlen. Dann betreibt die Versicherung beide Berechnungen nebeneinander: Die „Auswertung“ liefert sofort vorläufige Zahlen, und ein nächtlicher Lauf berechnet die Endstände. Das heißt Lambda Architecture. Das Betrugsteam bekommt so schnelle Warnungen, und Abrechnungen und Berichte stützen sich auf die Endstände.
- Niemand kann die „Auswertung“ rund um die Uhr überwachen. Ein dauerhaft laufendes Programm, das unbemerkt stehen bleibt, liefert keine Warnungen mehr. Dann bleibt es beim nächtlichen Lauf, und das Betrugsteam erfährt von Häufungen erst am nächsten Morgen. Bleibt der nächtliche Lauf stehen, fällt das spätestens am Morgen auf, weil der Bericht fehlt.
Nachteile und typische Fehler
Ereignisse können verspätet, doppelt oder in anderer Reihenfolge eintreffen, als sie entstanden sind. Wie lange die „Auswertung“ bei einem Fenster auf verspätete Meldungen wartet, wie nachträgliche Korrekturen behandelt werden und wie die „Auswertung“ nach einem Absturz ohne doppelte Zählung weiterarbeitet, muss fachlich festgelegt und technisch umgesetzt werden. Ein langes Warten auf verspätete Meldungen macht die Zahl vollständiger, aber die Warnung später. Ein kurzes Warten macht die Warnung schneller, die Zahl aber öfter unvollständig. Die dauerhaft laufende „Auswertung“ muss rund um die Uhr überwacht werden, und die Nachrichtenplattform und der Fortschrittsspeicher müssen ebenfalls betrieben werden. Die Grenze von 20 Meldungen ergibt sich aus keiner technischen Regel; die Versicherung muss sie selbst festlegen, etwa nach den üblichen Meldezahlen der Region Kassel.
Typische Fehler und woran man sie erkennt:
- Doppelte Zählung nach Neustart: Die „Auswertung“ sichert Lesestelle und Zahlen nicht gemeinsam, sondern die Zahlen öfter als die Lesestelle. Nach einem Absturz lädt die „Auswertung“ zum Beispiel Zahlen, in denen 30 Meldungen schon enthalten sind. Die gesicherte Lesestelle liegt aber vor diesen 30 Meldungen. Die „Auswertung“ liest die 30 Meldungen deshalb noch einmal und zählt sie ein zweites Mal. Erkennbar ist das an Zahlen, die nach einem Neustart sprunghaft steigen, ohne dass mehr Meldungen eingegangen sind.
- Falscher Zeitpunkt gezählt: Die „Auswertung“ ordnet Meldungen nach dem Zeitpunkt ihrer Ankunft zu, obwohl der Meldezeitpunkt festgelegt war. Nach einer Störung im Mobilfunknetz treffen die Meldungen aus einer halben Stunde auf einmal ein. Die „Auswertung“ zählt sie alle im Fenster ihrer Ankunft, und dieses eine Fenster überschreitet die Grenze. Erkennbar ist das an Häufungen kurz nach dem Ende einer Störung im Mobilfunknetz.
- Verworfene verspätete Meldungen: Für verspätete Meldungen gibt es keine Regel, und die „Auswertung“ verwirft sie stillschweigend. Erkennbar ist das daran, dass die Summe aller Fenster eines Tages kleiner ist als die Zahl der Meldungen im Bericht des nächtlichen Laufs.
- Zu viele Warnungen: Die Grenze ist zu niedrig gewählt. Nach jedem Unwetter, auch nach einem kleinen, überschreiten die betroffenen Regionen die Grenze dann in jedem Zehn-Minuten-Fenster, und die „Auswertung“ warnt für jedes dieser Fenster. Zwei Stunden haben zwölf Zehn-Minuten-Fenster. Dauert ein Unwetter in drei Regionen zwei Stunden, erhält das Betrugsteam also 36 Warnungen. Irgendwann nimmt das Betrugsteam die Warnungen nicht mehr ernst. Erkennbar ist das an Warnungen, die lange unbearbeitet bleiben.
- Stehengebliebene „Auswertung“: Die „Auswertung“ bleibt unbemerkt stehen, zum Beispiel nach einem Fehler beim Lesen des Datenstroms. Es kommen keine Warnungen mehr, obwohl Meldungen eingehen. Erkennbar ist das an einer wachsenden Zahl ungelesener Ereignisse im Datenstrom.
Weiterführend
Verwandte Ansätze
- Kappa Architecture: verzichtet auf die getrennte Neuberechnung der Lambda Architecture und berechnet auch ältere Ergebnisse, indem die gespeicherten Ereignisse erneut durch die Datenstromverarbeitung laufen.
- Delivery Semantics (At Most Once, At Least Once, Exactly Once): beschreibt, ob ein Ereignis höchstens einmal, mindestens einmal oder genau einmal verarbeitet wird. Davon hängt ab, ob die „Auswertung“ nach einem Neustart eine Meldung doppelt zählt.
- Backpressure: bremst den Zufluss, wenn ein verarbeitendes Programm nicht nachkommt. Die „Auswertung“ kommt zum Beispiel nicht nach, wenn nach einem Unwetter mehr Meldungen eintreffen, als sie zählen kann.
Quellen
- Tyler Akidau: The world beyond batch: Streaming 101: Aufsatz von 2015, der Datenströme ohne festes Ende, den Unterschied zwischen dem Zeitpunkt eines Ereignisses und seiner Verarbeitung, Zeitfenster und das Problem verspäteter Daten erklärt.
- Microsoft: Understand time handling in Azure Stream Analytics: Dokumentation eines Dienstes für Datenstromverarbeitung, die Ereigniszeit und Ankunftszeit unterscheidet und beschreibt, wie lange auf verspätete Ereignisse gewartet wird und wann ein Zeitfenster sein Ergebnis ausgibt.