
Kappa Architecture
Laufende Daten mit demselben Programm erneut auswerten
Die Idee und ihr Nutzen
Eine Versicherung zählt, wie viele Schadenmeldungen aus jeder Region eingehen, und zeigt die Zahlen in einer Übersicht für die Geschäftsleitung. Zu welcher Region eine Meldung gehört, ergibt sich aus der Postleitzahl des Schadenorts. Später ändert die Versicherung die Regionsgrenzen. Soll die Übersicht auch ältere Meldungen nach den neuen Grenzen zeigen, reichen die bisherigen Summen je Region nicht: Die Postleitzahl jeder alten Meldung muss noch einmal einer Region zugeordnet werden. Deshalb bewahrt die Versicherung jede Schadenmeldung mit ihrer Postleitzahl in einem Ereignisprotokoll auf, einer Liste, an die jede neue Meldung hinten angehängt wird und die sich von vorn noch einmal lesen lässt. Ein einziges Programm zählt neue Meldungen, sobald sie eintreffen, und rechnet nach einer Änderung der Regionsgrenzen alle aufbewahrten Meldungen erneut durch. Diese Bauweise heißt Kappa Architecture.

Wie funktioniert es?
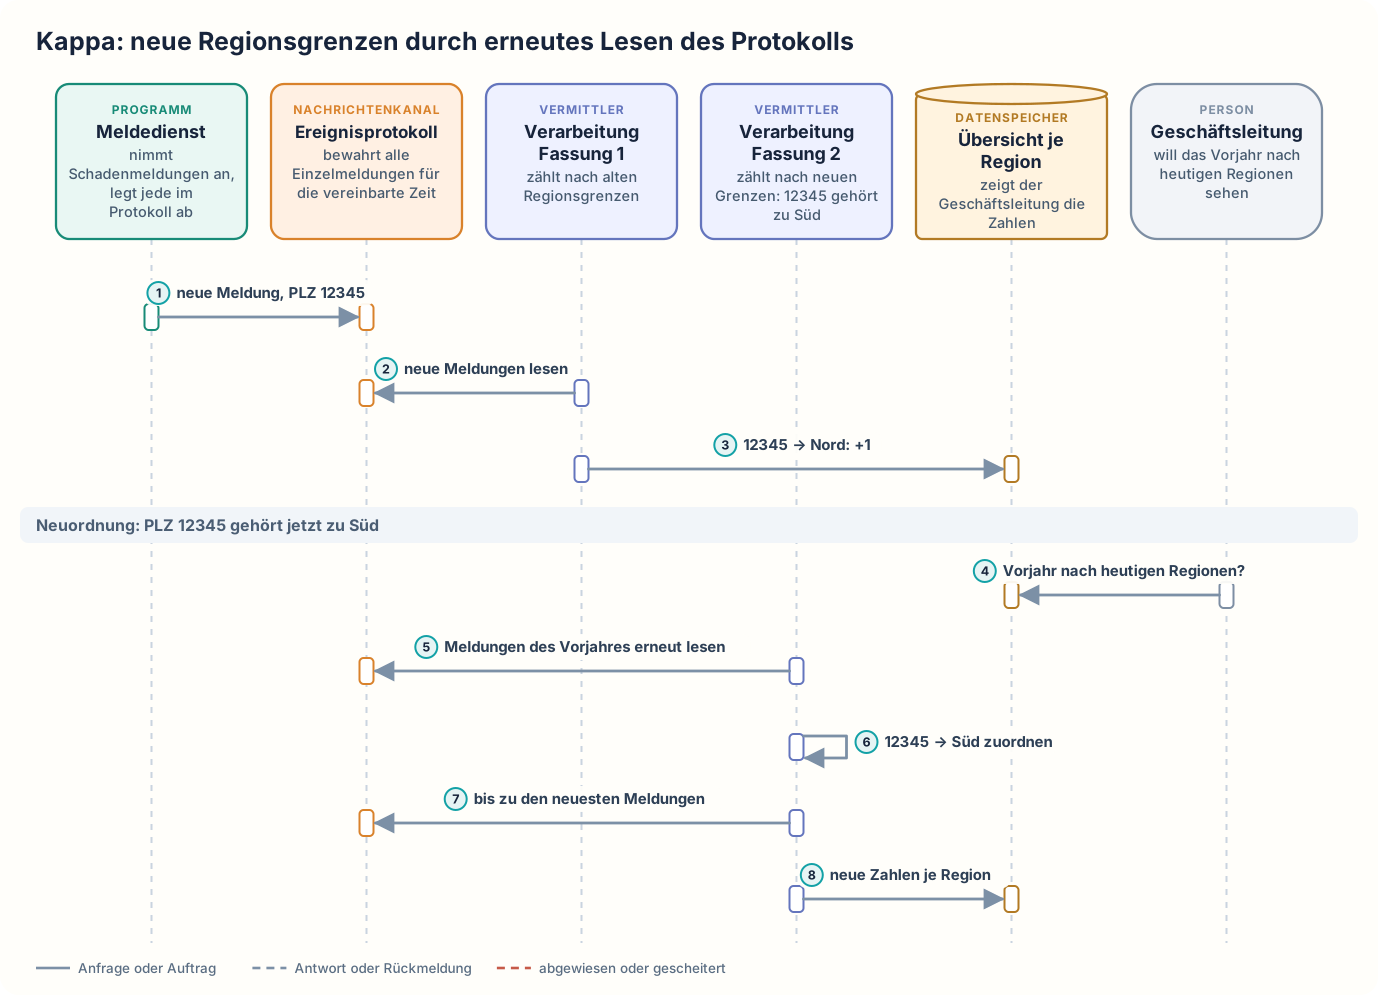
Der Meldedienst nimmt Schadenmeldungen an und legt eine neue Meldung mit der Postleitzahl 12345 und dem Meldedatum im Ereignisprotokoll ab. Das Auswertungsprogramm zählt die Meldungen je Region. Fassung 1 des Auswertungsprogramms liest neue Meldungen aus dem Ereignisprotokoll und zählt die neue Meldung nach den alten Grenzen für die Region Nord. Dann aktualisiert Fassung 1 die Übersicht je Region. Dann ordnet die Versicherung die Regionen neu: Die Postleitzahl 12345 gehört jetzt zu Süd. Die Geschäftsleitung will wissen, wie viele Meldungen im vergangenen Jahr auf die heutigen Regionen entfallen. Deshalb müssen auch die Meldungen des Vorjahres mit dieser Postleitzahl nun Süd zugerechnet werden. Das Datenteam, das für Ereignisprotokoll und Auswertungsprogramm zuständig ist, startet Fassung 2 desselben Auswertungsprogramms. Fassung 2 liest die aufbewahrten Meldungen des Vorjahres von vorn und rechnet Meldungen mit 12345 der Region Süd zu. Währenddessen zählt Fassung 1 weiter, und die Übersicht zeigt weiterhin die Zahlen von Fassung 1. Danach verarbeitet Fassung 2 auch alles, was seit ihrem Start eingetroffen ist. Erst dann stellt das Datenteam die Übersicht auf die Zahlen von Fassung 2 um und beendet Fassung 1.
Ein Ereignis ist hier ein Datensatz über etwas Geschehenes. Ein Beispiel ist „Schaden 4711 wurde am 3. März mit Postleitzahl 12345 gemeldet“. Weil laufend neue Ereignisse hinzukommen, nennt man den Inhalt des Ereignisprotokolls auch einen Datenstrom. Damit ist nicht gemeint, dass die Ereignisse nur vorbeifließen und danach verloren sind. Für eine Neuberechnung müssen die benötigten Einträge gespeichert bleiben. Wie lange die Einträge lesbar bleiben, legt das Datenteam fest. Der Meldedienst legt jede Meldung mit allen Angaben ab, die eine spätere Auswertung braucht, hier vor allem Postleitzahl und Meldedatum. Das Auswertungsprogramm liest die Meldungen, ordnet jede Postleitzahl einer Region zu und schreibt die Zahlen in die Datenbank, aus der die Übersicht je Region liest. Dieses fortlaufende Lesen und Rechnen heißt Stromverarbeitung. Eine eigene Stapelverarbeitung braucht die Kappa Architecture nicht. Eine Stapelverarbeitung wäre ein zweites Programm, das alle alten Daten regelmäßig in großen Paketen neu berechnet. Den Namen Kappa Architecture schlug Jay Kreps 2014 vor, als er die Bauweise als Vereinfachung der älteren Lambda Architecture beschrieb.
Bricht Fassung 2 wegen eines Programmfehlers während des erneuten Lesens ab, bleibt die Übersicht bei den Zahlen von Fassung 1. Das Datenteam behebt den Fehler und startet Fassung 2 erneut von vorn. Die Geschäftsleitung sieht in dieser Zeit weiterhin die Zahlen nach den alten Grenzen und keine unvollständigen neuen Zahlen. Soll ein Bericht dagegen die damals gültigen Regionsgrenzen zeigen, wäre die Neuzuordnung gerade nicht gewünscht. Ob ein Bericht die heutigen oder die damals gültigen Grenzen zeigt, ist eine fachliche Frage, die die Geschäftsleitung entscheidet.
Kappa: neue Regionsgrenzen durch erneutes Lesen des Protokolls
Wann ist es sinnvoll und wann nicht?
Eine Kappa Architecture lohnt sich
- Dieselbe Berechnungsregel soll für neue und für alte Meldungen gelten. Ohne Kappa Architecture zählt oft ein Programm die neuen Meldungen, und ein zweites berechnet alle Meldungen regelmäßig in großen Paketen neu. Dann steht die Regel „Postleitzahl 12345 gehört zu Süd“ in beiden Programmen. Oft sind die beiden Programme sogar in verschiedenen Programmiersprachen geschrieben. Jede Änderung muss dann zweimal umgesetzt und getestet werden. Weichen die beiden Umsetzungen voneinander ab, zeigen die laufende Übersicht und die Neuberechnung unterschiedliche Zahlen.
- Neue Zahlen werden innerhalb von Sekunden gebraucht, und fachliche Regeln der Auswertung ändern sich von Zeit zu Zeit. Ein Beispiel ist die Zuordnung von Postleitzahlen zu Regionen. Eine Neuberechnung einmal am Tag liefert die Zahl einer neuen Meldung erst am nächsten Tag. Ein Programm, das nur neue Meldungen zählt, kann alte Meldungen nach einer Änderung der Regionsgrenzen nicht neu zuordnen.
- Die Meldungen können lange genug aufbewahrt werden, und das erneute Lesen ist fertig, bevor die Geschäftsleitung die neuen Zahlen braucht. Die Geschäftsleitung kann dann das vergangene Jahr nach den heutigen Regionen sehen. Ohne die aufbewahrten Einzelmeldungen gibt es nur die bisherigen Summen je Region, und die Meldungen des Vorjahres lassen sich nicht neu zuordnen.
Eine Kappa Architecture ist nicht das Richtige
- Die historische Auswertung muss Daten aus vielen Quellen verbinden, die nicht im Ereignisprotokoll stehen. Das Auswertungsprogramm einer Kappa Architecture rechnet nur mit dem, was im Ereignisprotokoll steht, und das Datenteam müsste alle anderen Quellen erst laufend in das Ereignisprotokoll übertragen. Stattdessen baut das Datenteam eine Lambda Architecture. Neben dem laufenden Zählen berechnet dort eine eigene Stapelverarbeitung regelmäßig alle Daten in großen Paketen neu und liest dafür auch die anderen Quellen. Das Datenteam muss die Daten der anderen Quellen dann nicht in das Ereignisprotokoll übertragen. Dafür steht die Zuordnung der Postleitzahlen zu Regionen in beiden Programmen.
- Die alten Meldungen können nicht lange genug im Ereignisprotokoll aufbewahrt werden. Eine vollständige Neuberechnung durch erneutes Lesen ist dann nicht möglich. Dann bewahrt das Datenteam die Meldungen dauerhaft in einem gesonderten Datenspeicher auf, und die Stapelverarbeitung der Lambda Architecture rechnet aus diesem Datenspeicher neu. Das Ereignisprotokoll muss die Meldungen nur so lange aufbewahren, bis das laufende Zählen sie verarbeitet hat.
- Die Auswertung muss nur einmal am Tag aktualisiert werden. Ein Auswertungsprogramm, das jede Meldung innerhalb von Sekunden zählt, liefe dann ständig, obwohl die Geschäftsleitung die Zahlen nur einmal am Tag braucht. Stattdessen rechnet das Datenteam die Übersicht einmal am Tag mit einer Stapelverarbeitung über alle gespeicherten Meldungen neu, wie es Batch Processing beschreibt. Nach einer Änderung der Regionsgrenzen zählt schon der nächste Lauf alle Meldungen nach den neuen Grenzen. Ein dauerhaft laufendes Auswertungsprogramm und ein Ereignisprotokoll, das sich von vorn lesen lässt, braucht die Versicherung dann nicht.
Nachteile und typische Fehler
Lange Aufbewahrung braucht Speicher. Außerdem muss das Datenteam festlegen, nach welcher Zeit es Meldungen löscht und wer die aufbewahrten Meldungen mit ihren personenbezogenen Angaben lesen darf. Das erneute Lesen vieler Ereignisse kann lange dauern und beansprucht zusätzliche Rechenzeit. Während einer Neuberechnung laufen zwei Fassungen des Auswertungsprogramms gleichzeitig, und Fassung 2 braucht eigene Ergebnistabellen, bis das Datenteam die Übersicht umstellt. Das Auswertungsprogramm braucht außerdem eigene Regeln für verspätet eingehende Meldungen und für Korrekturen, etwa wenn ein Kunde nachträglich die Postleitzahl berichtigt. Das erneute Lesen des Ereignisprotokolls beantwortet diese fachlichen Fragen nicht.
Typische Fehler und woran man sie erkennt:
- Protokoll zu früh gelöscht: Das Ereignisprotokoll bewahrt die Meldungen nur einige Wochen auf, die Geschäftsleitung will aber das ganze Vorjahr neu sehen. Fassung 2 rechnet nur die noch vorhandenen Meldungen durch, und die Zahlen sind unvollständig. Erkennbar ist das daran, dass die Neuberechnung für das Vorjahr nur Meldungen der letzten Wochen enthält.
- Zu früh umgestellt: Das Datenteam stellt die Übersicht auf Fassung 2 um, bevor Fassung 2 alle seit ihrem Start eingetroffenen Meldungen verarbeitet hat. Die Meldungen, die Fassung 2 noch nicht gelesen hat, fehlen dann in den Zahlen von Fassung 2, und die Übersicht zeigt kurzzeitig zu niedrige Zahlen. Erkennbar ist das an einem Rückgang der Zahlen direkt nach der Umstellung, der danach wieder aufgeholt wird.
- Korrekturen nicht berücksichtigt: Berichtigt ein Kunde nachträglich die Postleitzahl, legt der Meldedienst die Berichtigung als neuen Eintrag ab. Kennt das Auswertungsprogramm keine Regel dafür, zählt es die Meldung nach dem erneuten Lesen sowohl unter der alten als auch unter der berichtigten Postleitzahl. Erkennbar ist das an mehr gezählten Meldungen als tatsächlich gemeldeten Schäden.
- Fehlende Angaben in alten Meldungen: Alle Auswertungen hängen am Aufbau der Einträge im Ereignisprotokoll. Eine neue Auswertung braucht eine Angabe, die der Meldedienst früher nicht im Ereignisprotokoll abgelegt hat. Ein Beispiel ist die Schadenart. Für alte Meldungen lässt sich diese Angabe nicht nachträglich ergänzen, und die Neuberechnung kann diese alten Meldungen nicht zuordnen. Erkennbar ist das an vielen Meldungen ohne Zuordnung in den Zahlen der neuen Fassung.
Weiterführend
Verwandte Ansätze
- Stream Processing: das fortlaufende Lesen und Berechnen der Ereignisse.
- Event Sourcing: verwendet ebenfalls ein Ereignisprotokoll, allerdings als Grundlage für den Zustand einer Anwendung.
- Materialized View: ein vorbereitetes Ergebnis, das eine Übersicht lesen kann, ohne selbst zu rechnen.
Werkzeuge und Umsetzungen
- Apache Kafka: speichert Ereignisse für eine einstellbare Zeit und erlaubt erneutes Lesen innerhalb dieser Aufbewahrungszeit.
- Apache Flink: verarbeitet Ereignisse fortlaufend und kann mit den erneut gelesenen Daten dieselbe Berechnung ausführen.
- Kafka Streams: Bibliothek für fortlaufende Verarbeitung von Kafka-Daten.
- Apache Pulsar: Nachrichtenplattform mit Möglichkeiten zur langfristigen Aufbewahrung und zum erneuten Lesen.
Quellen
- Jay Kreps: Questioning the Lambda Architecture: Aufsatz von 2014, in dem der Name Kappa Architecture vorgeschlagen wird; beschreibt, wie eine zweite Fassung desselben Programms das aufbewahrte Protokoll von vorn liest, in neue Ergebnistabellen schreibt und nach dem Aufholen die alte Fassung ablöst.
- Apache Kafka: Introduction: beschreibt ein verbreitetes Ereignisprotokoll, das Ereignisse nach dem Lesen nicht löscht, die Aufbewahrungszeit je Thema, einem benannten Teil des Protokolls, einstellbar macht und erneutes Lesen erlaubt.