
Data Lake
Rohdaten in beliebigem Format ablegen
Die Idee und ihr Nutzen
Eine Versicherung sammelt Schadenmeldungen, Gutachten, Fotos und Wetterdaten. Welche Fragen sie später mit diesen Daten beantworten will, weiß sie heute noch nicht. Sie bewahrt deshalb zunächst Kopien all dieser Daten in ihren ursprünglichen Formaten in einem großen Speicher auf. Erst wenn eine konkrete Frage auftaucht, wählt ein Analyseteam die passenden Daten aus und bereitet sie für die Auswertung auf. Für die Frage, ob Wetterwarnungen Hagelschäden ankündigen, verknüpft es zum Beispiel jeden Hagelschaden mit den Wetterwarnungen für seine Postleitzahl. Ein durchsuchbares Verzeichnis, der Datenkatalog, hält fest, welche Daten vorhanden sind, wo sie liegen und wer sie erklären kann. Ein solcher Speicher heißt Data Lake, auf Deutsch Datensee.

Wie funktioniert es?
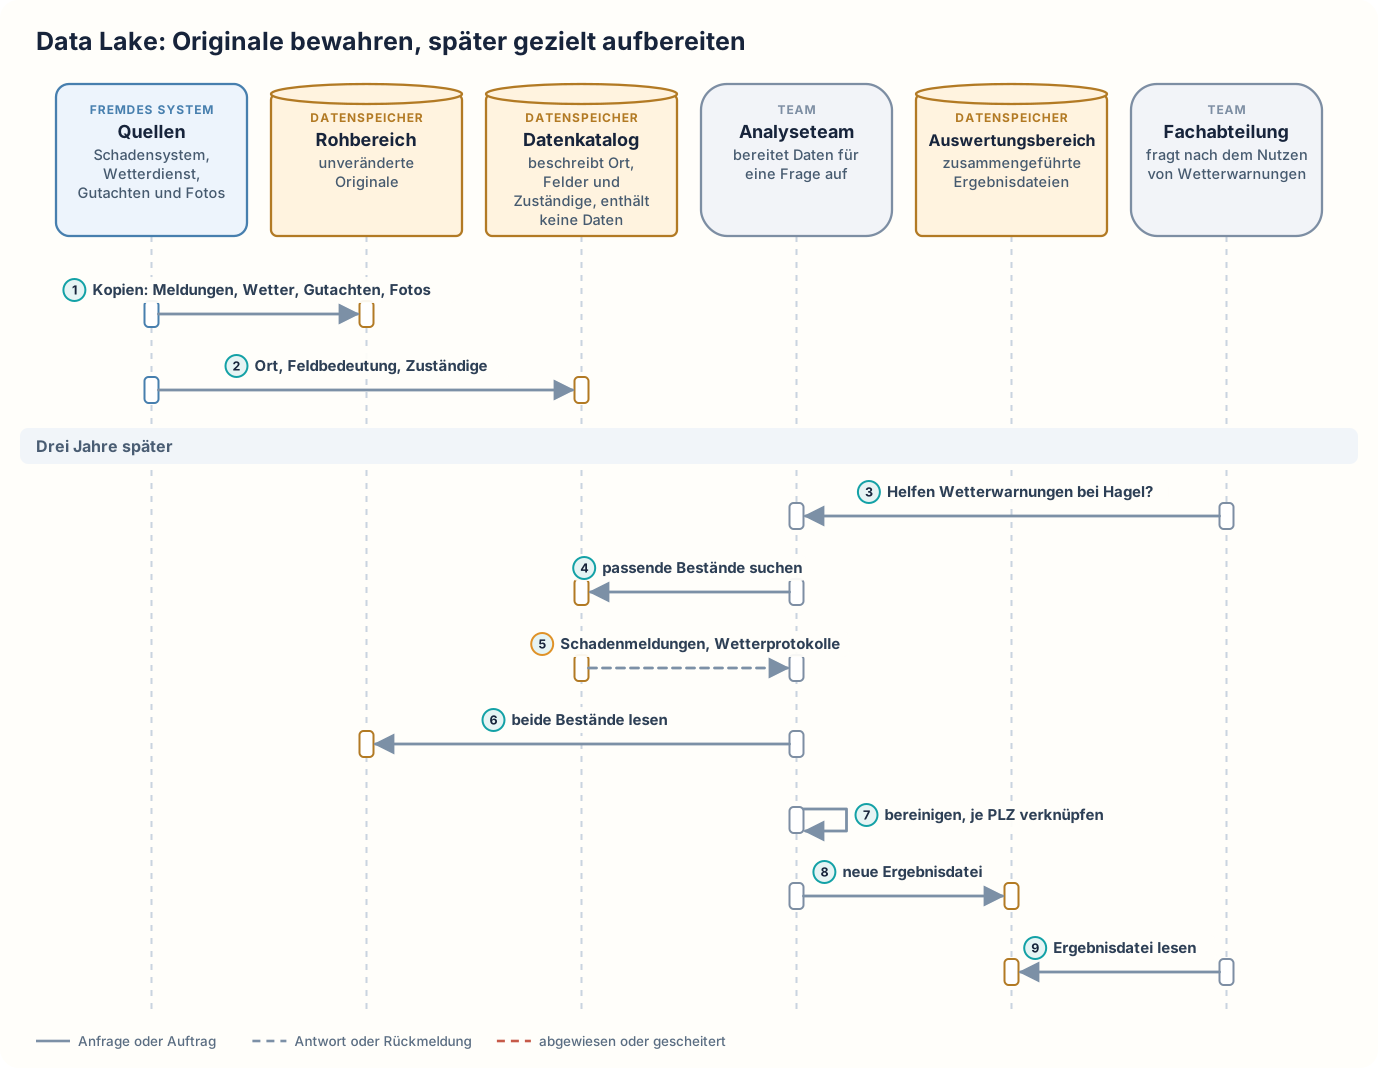
Jeden Tag liefern die Quellen der Versicherung unveränderte Kopien in den Rohbereich des Data Lake, den Teil des Speichers für die Originale. Das Schadensystem, in dem die Versicherung Verträge und Schäden führt, liefert einen Auszug der Schadenmeldungen. Ein externer Wetterdienst liefert seine Wetterprotokolle, und die Ablage für Gutachten und Fotos liefert ihre Dateien. Für jeden dieser Datenbestände steht im Datenkatalog, wo er liegt, wer ihn verantwortet und was seine Felder bedeuten. Drei Jahre später will die Fachabteilung wissen, ob Wetterwarnungen helfen, Hagelschäden früher einzuschätzen. Das Analyseteam sucht im Datenkatalog und findet die zwei nötigen Bestände, die Schadenmeldungen und die Wetterprotokolle. Gutachten und Fotos braucht es für diese Frage nicht. Das Analyseteam legt fest, wie Schadendatum, Postleitzahl und Warnzeitpunkt aus beiden Beständen zu lesen sind, etwa dass das Schadendatum im Format Tag.Monat.Jahr steht, und liest die Originale aus dem Rohbereich. Die Originale bleiben dabei unverändert. Danach entfernt das Analyseteam fehlerhafte Einträge, etwa Schadenmeldungen ohne Postleitzahl, und verknüpft jeden Hagelschaden mit den Warnungen für seine Postleitzahl, die vor dem Schaden herausgegeben wurden. Eine spätere Warnung hätte den Schaden nicht vorhersagen können. Das Analyseteam legt das Ergebnis als neue Datei im Auswertungsbereich ab. Die Fachabteilung untersucht diese Datei. Ob die Daten für verlässliche Vorhersagen reichen, prüft die Fachabteilung gesondert.
Der Data Lake ist ein Speicher für große Dateimengen. Er bewahrt die Originaldateien der Quellen auf und ebenso die Fassungen, die später daraus erzeugt werden. Der Speicher wird oft in getrennte Bereiche gegliedert, die auch „Zonen“ heißen. Außer dem Rohbereich gibt es häufig einen bereinigten Bereich. Dort liegen neue Dateien, in denen zum Beispiel Datumsangaben einheitlich geschrieben und fehlerhafte Postleitzahlen gekennzeichnet sind. Im Auswertungsbereich liegen Dateien, die für eine bestimmte Frage schon zusammengeführt wurden. An den Bereichen erkennt jedes Analyseteam, ob eine Datei ein unverändertes Original ist oder schon bearbeitet wurde. Wie viele Bereiche es gibt, legt jedes Unternehmen selbst fest, und nicht jede Datei durchläuft alle Bereiche. Für die Frage nach den Wetterwarnungen liest das Analyseteam direkt aus dem Rohbereich und legt nichts im bereinigten Bereich ab, weil bisher keine andere Frage diese Daten braucht. Brauchen mehrere Fragen dieselben bereinigten Daten, kann das Analyseteam diese Daten zuvor im bereinigten Bereich ablegen.
Der Datenkatalog enthält nur Beschreibungen der gespeicherten Dateien, nicht die Dateien selbst. Ein Eintrag nennt zum Beispiel den Bestand „Schadenmeldungen“, seinen Speicherort, das Quellsystem, die Bedeutung der Felder „Schadendatum“ und „Postleitzahl“, die zuständige Abteilung und das Datum der letzten Aktualisierung. So findet das Analyseteam die richtige Quelle und weiß, wen es bei Rückfragen anspricht.
Die Originaldateien haben unterschiedliche Formate. Gelesen werden sie mit einem Abfragewerkzeug, einem Programm, das Daten nach einer gestellten Abfrage heraussucht. Zuerst legt das Analyseteam fest, welche Felder eine Datei enthält und wie jedes Feld zu lesen ist. Erst danach kann das Abfragewerkzeug die Datei lesen. Ein Beispiel ist „drittes Feld: Schadendatum im Format Tag.Monat.Jahr“. Diese Beschreibung der Felder steht zum Beispiel als Tabelleneintrag im Datenkatalog. Das Abfragewerkzeug wendet diese Beschreibung erst beim Lesen an. PDF-Gutachten und Fotos brauchen eine eigene Verarbeitung, bevor ihr Inhalt durchsucht oder mit Tabellen verknüpft werden kann. Bei den Gutachten ist das etwa eine Texterkennung.
Ändert das Analyseteam später eine Regel der Aufbereitung, etwa für fehlerhafte Postleitzahlen, liest es die unveränderten Originale erneut und bereitet sie mit der neuen Regel auf. Ein Data Lake beantwortet keine Frage von selbst und garantiert nicht, dass die gesammelten Daten richtig oder vollständig sind.
Manche Data Lakes werden um verwaltete Tabellen erweitert, also um Tabellen, deren Dateien ein eigenes Tabellenformat verwaltet. Angenommen, die bereinigten Schadenfälle liegen verteilt auf vielen Dateien, und 500 Fälle müssen korrigiert werden. Ohne Vorkehrung könnte eine Abfrage mitten in der Korrektur einen halb geänderten Stand lesen. Tabellenformate wie Apache Iceberg oder Delta Lake legen fest, wie eine Tabelle auf viele Dateien verteilt gespeichert wird, und führen zusätzlich eine Liste, welche Dateien zum aktuell gültigen Stand der Tabelle gehören. Das Programm, das die Korrektur schreibt, schreibt zuerst alle korrigierten Dateien. Erst danach veröffentlicht es die neue Liste. Eine Abfrage liest dadurch entweder den alten oder den neuen Stand, nie einen Zwischenstand. Werden solche verwalteten Tabellen auf dem Speicher eines Data Lake für Auswertungen genutzt, spricht man von einem Lakehouse. Diesen Schutz vor Zwischenständen haben nur die verwalteten Tabellen, nicht die Fotos und rohen PDF-Dateien. Ein Data Lake braucht diese Erweiterung nicht.
Data Lake: Originale bewahren, später gezielt aufbereiten
Wann ist es sinnvoll und wann nicht?
Ein Data Lake lohnt sich
- Die Daten vieler unterschiedlicher Quellen sollen für Fragen aufbewahrt werden, die heute noch nicht bekannt sind. Für die heutigen Berichte, etwa die monatliche Schadenstatistik, hat die Versicherung bereits ein Data Warehouse, eine Datenbank mit geprüften Tabellen für bekannte Berichte. Für neue Fragen hilft das Data Warehouse nicht, denn es enthält nur, was für die bekannten Berichte ausgewählt wurde. Wetterprotokolle und Fotos stehen im Data Warehouse gar nicht, und bei der Vereinheitlichung wurden Einzelheiten weggelassen.
- Die Quellsysteme löschen ältere Daten. Taucht in drei Jahren die Frage nach den Wetterwarnungen auf, lassen sich die nötigen Daten aus den Quellsystemen nicht mehr nachträglich beschaffen. Im Data Lake liegen Schadenmeldungen und Wetterprotokolle dann noch vor.
- Für Untersuchungen mit maschinellem Lernen sollen die ursprünglichen Daten später mit anderen Regeln neu aufbereitet werden, etwa die Fotos in anderer Auflösung. Dafür braucht das Analyseteam die unveränderten Originale. Ohne Data Lake liegen nur die schon bearbeiteten Fassungen vor, etwa verkleinerte Fotos, und eine Aufbereitung mit anderen Regeln ist nicht mehr möglich.
- Auch Daten ohne feste Tabellenform sollen ausgewertet werden. Beispiele sind Texte, Bilder und Protokolldateien. Bei der Versicherung sind das die Gutachten als PDF-Dateien und die Fotos. Ohne Data Lake bleiben Gutachten und Fotos in ihrer Ablage, denn das Data Warehouse nimmt nur Tabellen auf, und das Analyseteam kann sie nicht zusammen mit den Schadenmeldungen auswerten.
Ein Data Lake ist nicht das Richtige
- Die Fragen sind bekannt und werden regelmäßig gestellt, wie bei der monatlichen Schadenstatistik, und die Kennzahlen müssen geprüft sein. Aus dem Data Lake müsste ein Analyseteam die Rohdaten für jede monatliche Statistik neu aufbereiten, und zwei Analyseteams könnten dabei zu unterschiedlichen Zahlen kommen. Stattdessen erstellt die Versicherung diese Berichte aus ihrem Data Warehouse. Das Data Warehouse übernimmt nur festgelegte Daten aus den Quellsystemen und vereinheitlicht sie nach festen Regeln. Jeder Bericht nutzt so dieselben geprüften Kennzahlen, und die Aufbereitung für jede einzelne Statistik entfällt. Ein Data Warehouse kann seine Daten auch aus aufbereiteten Dateien eines Data Lake beziehen. Der Data Lake ersetzt das Data Warehouse nicht, sondern ergänzt es für neue Fragen.
- Niemand kann die Verantwortung für den Datenkatalog und die Qualität der Bestände übernehmen. Die Daten werden dann zwar gespeichert, aber kaum genutzt, weil ohne gepflegten Datenkatalog niemand die passenden Bestände findet. Stattdessen fordert das Analyseteam Daten erst für eine konkrete Frage aus den Quellsystemen an. Speicherplatz und tägliche Übernahme entfallen. Daten, die ein Quellsystem schon gelöscht hat, bekommt das Analyseteam dann allerdings nicht mehr.
- Für Daten über Personen ist kein Zweck festgelegt, und ohne festgelegten Zweck dürfen sie nicht aufbewahrt werden. Eine Sammlung „für spätere Fragen“, wie der Rohbereich sie vorsieht, ist für diese Daten deshalb nicht zulässig. Dann übernimmt die Versicherung nur Bestände ohne Angaben über Personen in den Data Lake, etwa die Wetterprotokolle. Den täglichen Auszug der Schadenmeldungen macht das Schadensystem vorher anonym, sodass sich keine Person mehr erkennen lässt.
- Die Schwierigkeit liegt vor allem darin, dass das Analyseteam die Daten vieler Fachbereiche nicht mehr versteht, etwa welche Schadenmeldungen die Schadenabteilung als abgeschlossen zählt. Im Data Lake müsste das Analyseteam trotzdem jeden Bestand selbst lesen und aufbereiten. Stattdessen stellt jeder Fachbereich die Daten, die er erzeugt, selbst aufbereitet und beschrieben bereit, die Schadenabteilung zum Beispiel die bereinigten Schadenmeldungen. Dieses Vorgehen heißt Data Mesh. Das Analyseteam muss fremde Daten dann nicht mehr selbst verstehen und aufbereiten. Dafür muss jeder Fachbereich Zeit für die Bereitstellung seiner Daten einplanen.
Nachteile und typische Fehler
Ein Data Lake speichert Kopien vieler Bestände über Jahre, auch solcher, die vielleicht nie gebraucht werden. Speicherplatz, regelmäßige Übernahme aus den Quellsystemen und die Pflege des Datenkatalogs verursachen laufend Kosten und Arbeit. Rohdaten enthalten oft Angaben über Personen, etwa Namen und Adressen in Schadenmeldungen. Zugriffsrechte, Löschfristen und Datenschutz müssen deshalb von Anfang an geregelt sein. Liegen nur Rohdaten bereit, muss jedes Analyseteam die benötigten Dateien selbst verstehen und aufbereiten. Stellen die zuständigen Fachbereiche geprüfte, wiederverwendbare Datensätze bereit, vermeidet das doppelte Arbeit, verlangt aber, dass diese Fachbereiche dafür Zeit einplanen. Die Erweiterung zum Lakehouse bringt ein Tabellenformat wie Apache Iceberg hinzu, das eingerichtet und betrieben werden muss.
Typische Fehler und woran man sie erkennt:
- Datensumpf: Die Dateien werden gesammelt, aber der Datenkatalog fehlt oder ist veraltet, und niemand ist für die Bestände zuständig. Niemand findet dann die passenden Quellen oder versteht ihre Bedeutung. Erkennbar ist das an vielen Beständen ohne Katalogeintrag und an Analyseteams, die Daten lieber erneut aus den Quellsystemen anfordern.
- Vergessene Löschfristen: Rohdaten mit Namen und Adressen bleiben im Rohbereich liegen, obwohl ihre Löschfrist abgelaufen ist. Erkennbar ist das an Schadenmeldungen im Data Lake, die älter sind als die Frist, die für sie gilt.
- Widersprüchliche Ergebnisse: Zwei Analyseteams bereiten dieselben Rohdaten nach eigenen Regeln auf und kommen für dieselbe Frage zu unterschiedlichen Ergebnissen. Erkennbar ist das an abweichenden Zahlen zu derselben Frage, etwa zur Zahl der Hagelschäden eines Jahres.
- Überschriebene Originale: Ein Verarbeitungsprogramm schreibt bereinigte Daten in den Rohbereich zurück und ersetzt damit die Originale. Eine Aufbereitung mit neuen Regeln ist danach nicht mehr möglich. Erkennbar ist das daran, dass Dateien im Rohbereich ein jüngeres Änderungsdatum tragen als ihre Übernahme aus dem Quellsystem.
- Spätere Warnung mitgezählt: Das Analyseteam verknüpft jeden Hagelschaden mit allen Warnungen seiner Postleitzahl, auch mit solchen, die erst nach dem Schaden herausgegeben wurden. Die Auswertung überschätzt dann den Nutzen der Warnungen. Erkennbar ist das an Warnzeitpunkten, die nach dem Schadendatum liegen.
- Halb geänderter Stand gelesen: Ohne verwaltete Tabellen liest eine Abfrage die bereinigten Schadenfälle, während 500 davon gerade korrigiert werden. Erkennbar ist das an Ergebnissen, die sich bei gleicher Abfrage kurz hintereinander unterscheiden.
Weiterführend
Verwandte Ansätze
- Batch Processing und Stream Processing: verarbeiten Daten in gesammelten Läufen oder fortlaufend, sobald sie entstehen. Mit beiden Verfahren gelangen Daten in den Data Lake und werden dort aufbereitet.
Werkzeuge und Umsetzungen
- Apache Iceberg: offenes Tabellenformat für Dateien im Data Lake, das Änderungen als vollständige neue Stände veröffentlicht und frühere Stände aufbewahrt.
- Delta Lake: Tabellenformat mit derselben Eigenschaft, das oft zusammen mit Apache Spark genutzt wird.
- Trino: Abfragewerkzeug, das Dateien direkt im Data Lake mit SQL liest, der verbreiteten Sprache für Datenbankabfragen.
- Apache Spark: verarbeitet große Datenmengen im Data Lake verteilt auf viele Rechner.
- DataHub und OpenMetadata: Datenkataloge, die beschreiben, welche Daten es gibt, woher sie stammen und wer für sie zuständig ist.
Quellen
- AWS: Speicherbereiche und Datenstruktur beim Lesen: beschreibt die Gliederung in Roh-, bereinigte und aufbereitete Bereiche.
- AWS: Was ein Datenkatalog für Abfragen speichert: erklärt, dass der Katalog nur Beschreibungen der Tabellen enthält und die Daten in den Dateien bleiben.
- Martin Fowler: Data Lake: beschreibt den Data Lake als Speicher für Rohdaten in der Form der Quellen, grenzt ihn vom Data Warehouse ab und empfiehlt, Berichte aus eigens aufbereiteten Datenbeständen statt direkt aus dem Data Lake zu speisen.