
Data Mesh
Fachbereiche verantworten ihre Daten als Produkt
Die Idee und ihr Nutzen
In einer Versicherung will das Controlling vergleichen, wie viel Geld je Region für Schäden ausgezahlt wurde und wie viele Beiträge dort eingenommen wurden. Die Zahlungen kennt die Schadenabteilung am besten, die Beiträge der Vertragsbereich. Deshalb bereitet jeder Fachbereich seine Daten selbst für andere auf, die Schadenabteilung zum Beispiel die Zahlungen. Der Fachbereich beschreibt die Felder, nennt einen Ansprechpartner und sagt zu, wann neue Daten bereitstehen. Ein solcher aufbereiteter Datensatz heißt Datenprodukt. Andere Teams wie das Controlling finden und nutzen die Datenprodukte über eine gemeinsame technische Plattform mit Speicher, Zugriffsverwaltung und einem Verzeichnis aller Datenprodukte. Gemeinsame Regeln schreiben zum Beispiel vor, dass alle Bereiche die Vertragsnummer im selben Format führen, damit das Controlling Zahlungen und Beiträge verknüpfen kann. Diese Aufteilung der Verantwortung für Daten heißt Data Mesh, englisch für Datennetz.

Wie funktioniert es?
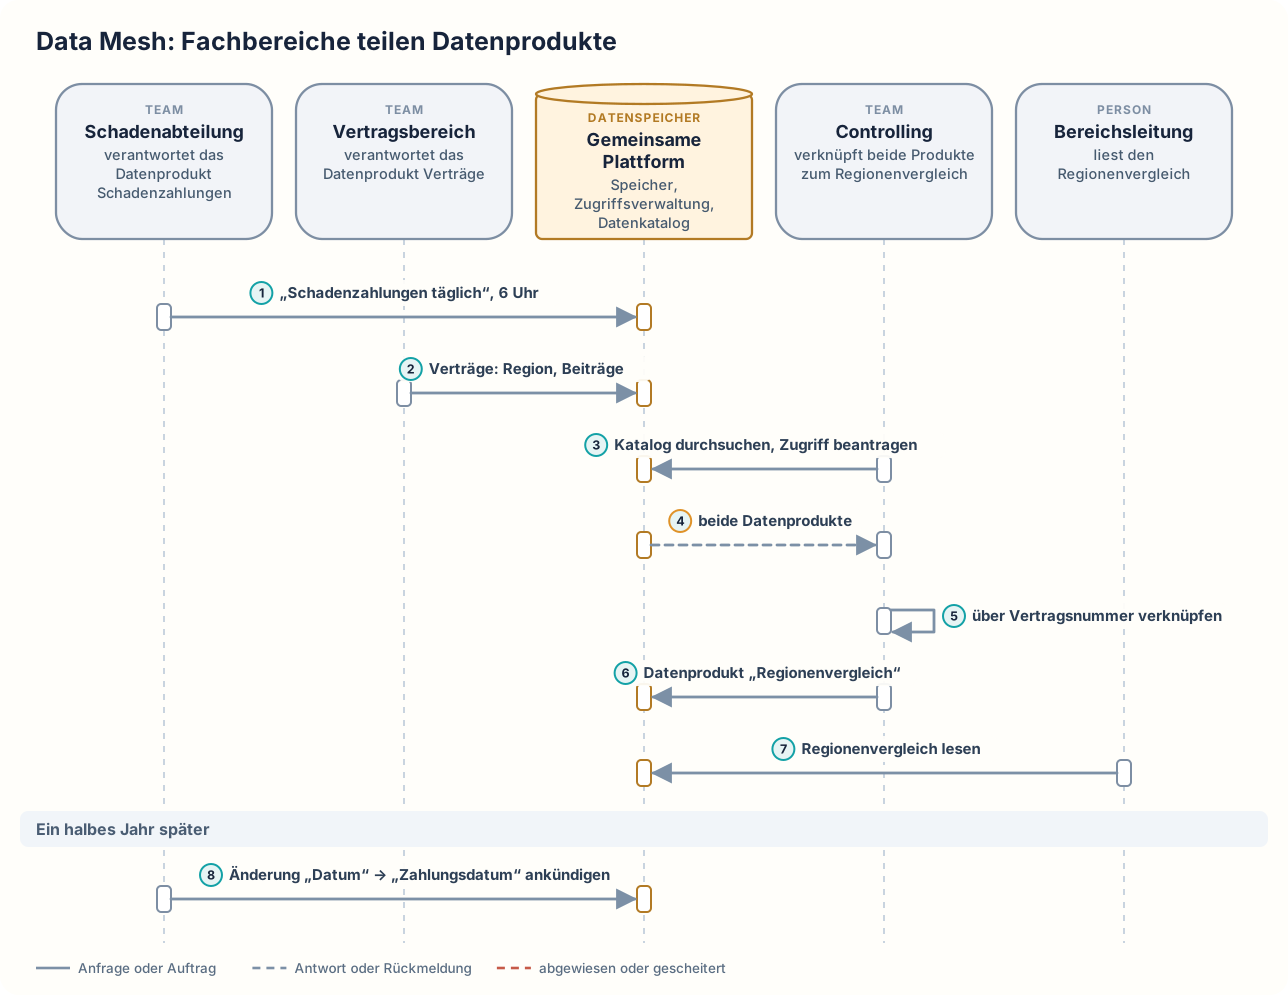
Die Schadenabteilung bereitet die Zahlungen aus ihrem Schadensystem auf und veröffentlicht auf der gemeinsamen Plattform das Datenprodukt „Schadenzahlungen“. Das Datenprodukt ist eine Tabelle mit Betrag, Datum und Vertragsnummer, die jeden Morgen um 6 Uhr aktualisiert wird, damit die Zahlungen des Vortags zu Arbeitsbeginn vorliegen. Stornierte Zahlungen hat die Schadenabteilung bereits herausgerechnet. Im Datenkatalog der Plattform, dem Verzeichnis aller Datenprodukte, nennt die Schadenabteilung einen Ansprechpartner für Fragen. Der Vertragsbereich veröffentlicht ebenso das Datenprodukt „Verträge“ mit Region und gebuchten Beiträgen je Vertragsnummer. Das Controlling findet beide Datenprodukte im Datenkatalog und beantragt Zugriff. Die gemeinsame Plattform prüft die Berechtigung des Controllings und gibt die Daten frei. Das Controlling verknüpft beide Datenprodukte über die Vertragsnummer und berechnet je Region Zahlungen und Beiträge. Das Controlling veröffentlicht das Ergebnis auf der Plattform als eigenes Datenprodukt „Regionenvergleich“. Berechtigte Personen aus der Bereichsleitung und der Schadenabteilung lesen denselben Vergleich, statt ihn jeweils selbst zu berechnen. Ein halbes Jahr später will die Schadenabteilung das Feld „Datum“ in „Zahlungsdatum“ umbenennen. Die Schadenabteilung kündigt die Änderung im Datenkatalog an und liefert zwei Monate lang beide Fassungen, damit das Controlling seine Berechnung anpassen kann. Die zwei Monate schließen mindestens einen vollständigen Monatsabschluss ein, bei dem das Controlling die angepasste Berechnung prüfen kann. Das Controlling liest alle Daten über die Plattform und bekommt keine Dateien direkt von den Fachbereichen.
Data Mesh betrifft Auswertungsdaten. Das sind Kopien von Daten aus den laufenden Fachsystemen, die für Berichte und Vergleiche aufbereitet werden, etwa die Zahlungen aus dem Schadensystem. Die laufenden Fachsysteme selbst ändern sich dadurch nicht. Data Mesh beruht auf vier Grundsätzen:
- Verantwortung beim Fachbereich: Wer Daten erzeugt, stellt sie auch für Auswertungen bereit. Die Schadenabteilung ist für Schadendaten zuständig, der Vertragsbereich für Vertragsdaten.
- Daten als Produkt: Ein Fachbereich schickt anderen nicht einfach eine unbeschriebene Datei, sondern stellt einen Datensatz bereit, den andere ohne Rückfrage verwenden können. Zu einem Datenprodukt gehören außer Feldbeschreibung, Ansprechpartner und Aktualisierungszeit auch prüfbare Qualitätszusagen. Eine solche Qualitätszusage lautet zum Beispiel „jede Zahlung hat eine Vertragsnummer“.
- Gemeinsame Plattform: Ein Plattformteam stellt Speicher, Rechner, Zugriffsverwaltung und den Datenkatalog bereit, damit nicht jeder Fachbereich diese Technik selbst aufbauen muss. Im Datenkatalog stehen zu jedem Datenprodukt seine Bedeutung und seine Verantwortlichen. Die Daten selbst liegen im Speicher der Plattform.
- Gemeinsame Regeln: Bereichsübergreifende Regeln legen fest, wie Datenprodukte beschrieben, benannt, geschützt und miteinander verknüpft werden. Die gemeinsamen Regeln schreiben zum Beispiel für die Vertragsnummer in beiden Bereichen dasselbe Format vor. Nur deshalb kann das Controlling die beiden Datenprodukte verknüpfen. Die Plattform prüft möglichst automatisch, ob die gemeinsamen Regeln eingehalten werden.
In vielen Unternehmen bereitet bisher ein zentrales Datenteam die Daten aller Fachbereiche in einer großen Auswertungsdatenbank auf. Wer Daten erzeugt, wer sie aufbereitet und wer sie nutzt, sind dann verschiedene Abteilungen. Die Schadenabteilung erzeugt zum Beispiel die Zahlungen, das zentrale Datenteam bereitet sie auf, und das Controlling nutzt sie. Die Versicherung ist in Fachbereiche gegliedert, hier Schadenabteilung, Vertragsbereich und Controlling. Jeder Fachbereich hat ein eigenes Budget und eine eigene Leitung und kennt seine Daten am besten. Die Schadenabteilung weiß zum Beispiel, wie sie stornierte Zahlungen erfasst. Bei Data Mesh kann das zentrale Datenteam weiterhin Plattform und Regeln betreuen. Für Bedeutung und Qualität der einzelnen Datenprodukte sind aber die Fachbereiche zuständig, die die Daten erzeugen. Für die Qualität der Zahlungen ist also die Schadenabteilung zuständig, für die Rechenregel des Regionenvergleichs das Controlling. Data Mesh ist damit vor allem eine Veränderung der Organisation. Die Plattform garantiert nicht, dass sich die Datenprodukte verschiedener Bereiche verknüpfen lassen. Dass beide Bereiche die Vertragsnummer im selben Format schreiben, erreichen nur die gemeinsamen Regeln, soweit sie eingehalten werden.
Eine Lieferung kann eine Qualitätszusage verletzen, etwa weil eine Zahlung keine Vertragsnummer hat. Eine automatische Prüfung auf der Plattform kann das melden, bevor das Controlling mit den Daten rechnet. Zuständig für die Korrektur ist die Schadenabteilung, nicht das Plattformteam und nicht das Controlling.
Data Mesh: Fachbereiche teilen Datenprodukte
Wann ist es sinnvoll und wann nicht?
Ein Data Mesh lohnt sich
- Ein großes Unternehmen hat viele Fachbereiche, und das zentrale Datenteam ist zum Engpass geworden. Wünscht ein Fachbereich eine neue Auswertung, muss er warten, bis das zentrale Datenteam Zeit dafür hat. Mit Data Mesh muss das Controlling für eine neue Auswertung wie den Regionenvergleich nicht auf das zentrale Datenteam warten.
- Auswertungen brauchen Daten, deren Bedeutung nur der erzeugende Fachbereich sicher kennt. So weiß ein zentrales Datenteam oft nicht, dass die Schadenabteilung stornierte Zahlungen mit einem negativen Betrag erfasst, und zählt sie falsch. Mit Data Mesh rechnet die Schadenabteilung stornierte Zahlungen selbst heraus, denn sie erfasst diese Zahlungen.
- Fehler in den Daten fallen spät auf, und niemand fühlt sich zuständig. Die Schadenabteilung sagt „wir haben die Daten geliefert“, das zentrale Datenteam sagt „so kamen sie bei uns an“. Mit Data Mesh ist für Fehler im Datenprodukt „Schadenzahlungen“ die Schadenabteilung zuständig, und das Controlling wendet sich an den Ansprechpartner aus dem Datenkatalog.
- Die Fachbereiche haben Mitarbeiter, die Daten mit Abfragen aufbereiten und automatische Prüfungen einrichten können, oder wollen solche Mitarbeiter ausbilden. Diese Mitarbeiter übernehmen dann die Aufbereitung, die bisher das zentrale Datenteam erledigt, in der Schadenabteilung etwa das Herausrechnen stornierter Zahlungen.
Ein Data Mesh ist nicht das Richtige
- Ein kleines oder mittleres Unternehmen hat wenige Datenquellen und wenige Auswertungswünsche. Ein zentrales Datenteam wird dann nicht zum Engpass, und kein Fachbereich wartet lange auf eine neue Auswertung. Deshalb bereitet das zentrale Datenteam die Daten auf, zum Beispiel in einem Data Warehouse, einer Datenbank mit geprüften Tabellen für Berichte. Die Bedeutung der Daten muss das zentrale Datenteam bei den Fachbereichen erfragen. Wie stornierte Zahlungen erfasst sind, erfährt es zum Beispiel von der Schadenabteilung. Die Fachbereiche brauchen so keine eigenen Mitarbeiter für die Pflege von Datenprodukten, und eine gemeinsame Plattform muss niemand aufbauen.
- Die Unternehmensführung unterstützt den Umbau nicht. Ohne diese Unterstützung gelingt der Umbau kaum, weil sich Zuständigkeiten und Budgets zwischen den Bereichen verschieben, etwa die Aufbereitung der Zahlungen vom zentralen Datenteam zur Schadenabteilung. Dann behält das zentrale Datenteam die Aufbereitung, und die Fachbereiche ziehen kein Personal für Datenprodukte von anderen Aufgaben ab.
- Kein Plattformteam kann Speicher, Zugriffsverwaltung und Datenkatalog bereitstellen. Ohne Plattformteam müssten die Schadenabteilung und der Vertragsbereich je einen eigenen Speicher, eine eigene Zugriffsverwaltung und einen eigenen Datenkatalog aufbauen, und das Controlling müsste die Datenprodukte an zwei Orten suchen. Stattdessen bereitet weiter das zentrale Datenteam die Daten auf, und Speicher, Zugriffsverwaltung und Datenkatalog gibt es nur einmal.
- Rohdaten sollen zunächst nur gesammelt werden, ohne dass schon feststeht, wer sie wie auswertet. Dann legt die Versicherung Kopien der Rohdaten in einem Data Lake ab, einem großen Speicher für Daten in ihren ursprünglichen Formaten. Kein Fachbereich muss dann Daten zu einem Datenprodukt aufbereiten, das noch niemand nutzt. Führt die Versicherung später ein Data Mesh ein, kann sie den Data Lake als Speicher der gemeinsamen Plattform weiter nutzen.
Nachteile und typische Fehler
Jeder Fachbereich braucht Menschen, die Datenprodukte dauerhaft pflegen. Dieses Personal war bisher für andere Aufgaben eingesetzt. Die gemeinsame Plattform braucht in Aufbau und Betrieb viel Geld und Arbeit: Speicher, Rechner, Zugriffsverwaltung, Datenkatalog und die automatische Prüfung der gemeinsamen Regeln müssen betrieben werden. Zwischen den Bereichen entstehen neue Abhängigkeiten. Das Controlling ist darauf angewiesen, dass die Schadenabteilung ihr Datenprodukt pünktlich um 6 Uhr aktualisiert und Änderungen rechtzeitig ankündigt. Alle Bereiche müssen die gemeinsamen Regeln zusammen festlegen und weiterentwickeln, und das erfordert laufend Abstimmung.
Typische Fehler und woran man sie erkennt:
- Unpassende Datenprodukte: Ohne gemeinsame Regeln schreibt die Schadenabteilung die Vertragsnummer zum Beispiel mit Bindestrichen, der Vertragsbereich ohne. Das Controlling verknüpft beide Datenprodukte über die Vertragsnummer. Zahlungen, deren Vertragsnummer anders geschrieben ist, finden dabei keinen Vertrag und fehlen im Regionenvergleich. Erkennbar ist das an Zahlungen, die beim Verknüpfen keinem Vertrag zugeordnet werden.
- Verantwortung nur auf dem Papier: Die Schadenabteilung veröffentlicht „Schadenzahlungen“, beantwortet aber keine Rückfragen und korrigiert keine Fehler. Eine neue Plattform ändert daran nichts. Erkennbar ist das an Katalogeinträgen ohne erreichbaren Ansprechpartner und an Rückfragen, die wieder beim früheren zentralen Datenteam landen.
- Unangekündigte Änderung: Die Schadenabteilung benennt das Feld „Datum“ ohne Ankündigung und ohne Übergangszeit um. Die Berechnung des Controllings sucht am nächsten Morgen das Feld „Datum“, findet es nicht und bricht ab. Erkennbar ist das an fehlgeschlagenen Berechnungen am Morgen nach der Änderung.
- Veraltetes Datenprodukt: Das Datenprodukt „Schadenzahlungen“ ist um 6 Uhr nicht aktualisiert, und das Controlling rechnet unbemerkt mit dem Stand vom Vortag. Erkennbar ist das, wenn der Zeitpunkt der letzten Aktualisierung vor 6 Uhr des laufenden Tages liegt, sofern die Plattform diesen Zeitpunkt im Datenkatalog anzeigt.
Weiterführend
Verwandte Ansätze
- Domain Driven Design und Bounded Context: beschreiben, wie man fachliche Bereiche mit eigenen Begriffen abgrenzt. Diese Bereiche eignen sich als Zuständigkeitsgrenzen für Datenprodukte.
- Conway's Law: beschreibt, dass Systeme dem Aufbau der Organisation folgen. Bei Data Mesh folgt die Aufteilung der Daten bewusst den Fachbereichen.
Werkzeuge und Umsetzungen
Data Mesh ist ein Organisationsmodell. Diese Projekte helfen beim technischen Teil:
- DataHub und OpenMetadata: Datenkataloge, in denen Datenprodukte mit Beschreibung, Herkunft und Verantwortlichen verzeichnet werden.
- dbt Core: beschreibt die Aufbereitung von Daten als versionierten Code in der Abfragesprache SQL, mit Tests und Dokumentation.
- Data Contract CLI: prüft automatisch, ob ein Datenprodukt die Zusagen seiner Beschreibung einhält.
- Trino: fragt Datenprodukte verschiedener Bereiche gemeinsam ab, auch wenn sie in unterschiedlichen Speichern liegen.
Quellen
- Zhamak Dehghani: Data Mesh Principles and Logical Architecture: Aufsatz der Begründerin von Data Mesh mit den vier Grundsätzen.
- Zhamak Dehghani: How to Move Beyond a Monolithic Data Lake to a Distributed Data Mesh: erster Aufsatz von 2019, der den Engpass eines zentralen Datenteams beschreibt und Datenprodukte in der Verantwortung der Fachbereiche auf einer gemeinsamen Plattform vorschlägt.