
Caching
Ergebnisse zwischenspeichern
Die Idee und ihr Nutzen
Der Tarifrechner einer Versicherung berechnet Preise für Kfz-Versicherungen und braucht dafür bei jedem Angebot dieselbe Tabelle mit Risikozuschlägen je Postleitzahl. Die Tabelle ändert sich nur einmal im Monat, das Laden aus der Datenbank verzögert aber jedes Angebot. Deshalb bewahrt der Tarifrechner nach dem ersten Laden eine Kopie der Tabelle in seinem Arbeitsspeicher auf und verwendet sie bei den folgenden Angeboten. Aus dem Arbeitsspeicher liest der Tarifrechner die Tabelle schneller als aus der Datenbank; das verkürzt die Antwortzeit, und die Datenbank erhält weniger Abfragen. Ein solcher Zwischenspeicher für Kopien heißt Cache, das Verfahren Caching.

Wie funktioniert es?
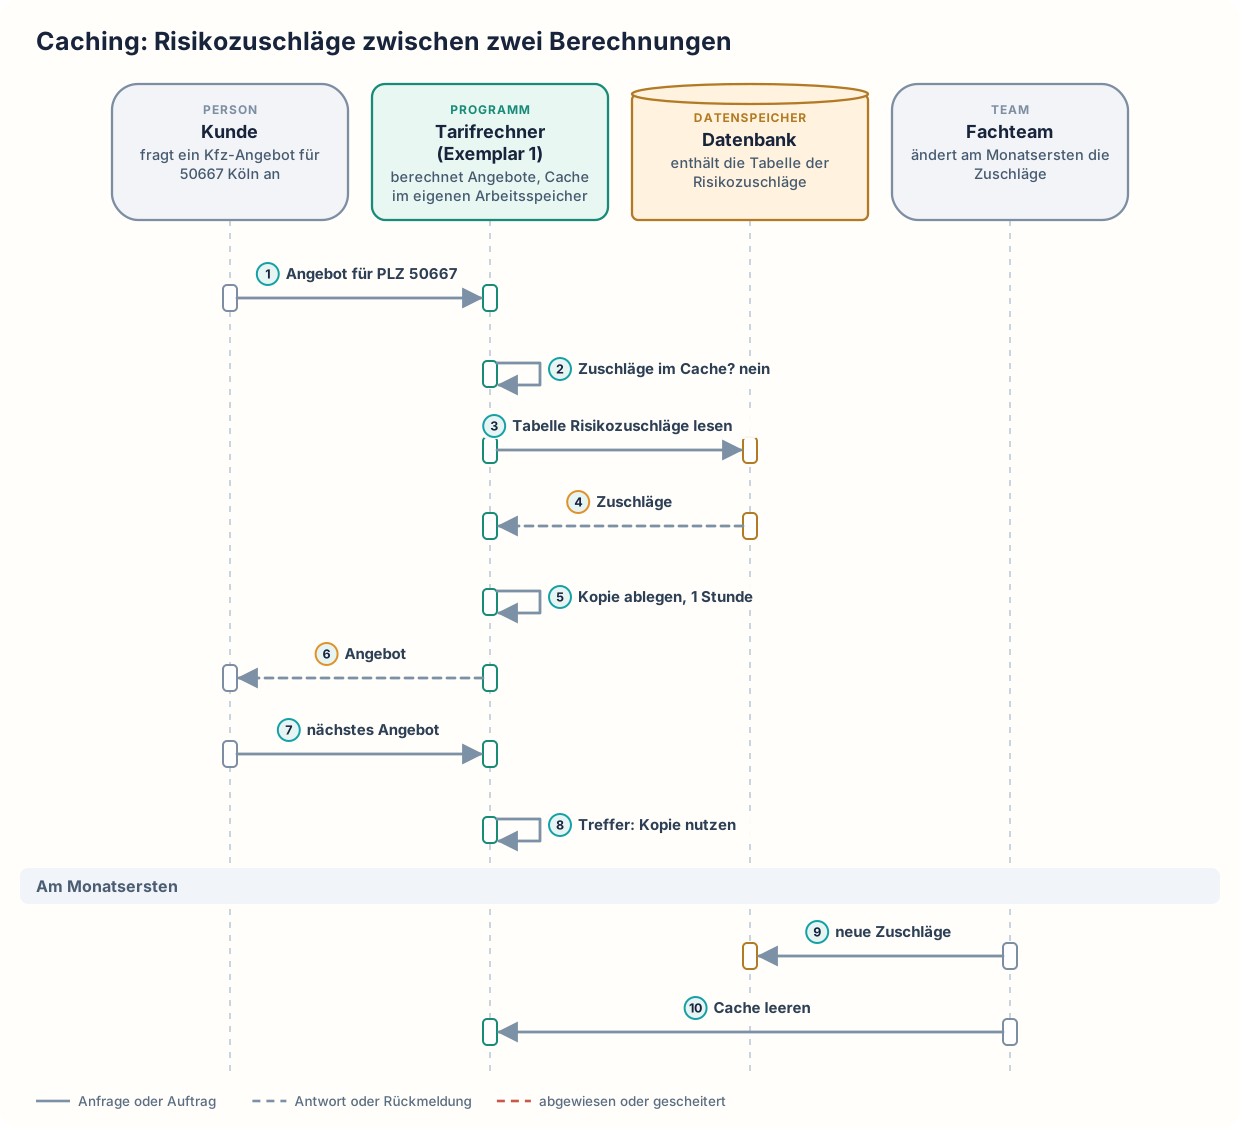
Der Tarifrechner läuft in vier Exemplaren desselben Programms, die gleichzeitig Angebote für viele Kunden berechnen. Weil alle Exemplare dieselben Berechnungsregeln haben, kann jedes Exemplar jedes Angebot berechnen. Ein Kunde fragt ein Kfz-Angebot für die Postleitzahl 50667 in Köln an. Exemplar 1 des Tarifrechners sucht die Tabelle der Risikozuschläge in seinem Arbeitsspeicher und findet sie noch nicht. Exemplar 1 liest die Tabelle aus der Datenbank, und die Datenbank liefert die Zuschläge. Exemplar 1 legt eine Kopie mit einer Ablaufzeit von einer Stunde in seinem Arbeitsspeicher ab; nach dieser Stunde löscht der Cache die Kopie selbst. Die Stunde hat das Fachteam vorgegeben, das die Tabelle der Risikozuschläge pflegt: Wird der Cache eines Exemplars nach einer Änderung der Zuschläge nicht geleert, soll dieses Exemplar höchstens eine Stunde lang mit alten Zuschlägen rechnen. Dann berechnet Exemplar 1 das Angebot. Eine weitere Angebotsanfrage kommt bei Exemplar 1 an. Diesmal liegt die Kopie im Cache. Die Datenbank wird nicht gefragt, und die Berechnung ist schneller. Am Monatsersten ändert das Fachteam die Zuschläge in der Datenbank. Die Kopien in den laufenden Exemplaren des Tarifrechners ändern sich dadurch nicht. Das Fachteam schickt deshalb allen vier Exemplaren eine Nachricht, ihren Cache zu leeren.
Ein Cache bewahrt Ergebnisse unter einem Schlüssel auf, einem Namen, unter dem das Programm sie wiederfindet, hier „Risikozuschläge“. Findet das Programm das Ergebnis unter dem Schlüssel, spricht man von einem Treffer, und das Programm verwendet die Kopie sofort. Sonst holt das Programm das Ergebnis aus der Quelle, hier der Datenbank. Alle vier Exemplare des Tarifrechners lesen aus derselben Datenbank, die auch andere Programme der Versicherung nutzen. Weil das Fachteam die Zuschläge pflegt und nicht das Entwicklungsteam des Tarifrechners, muss das Fachteam auch beantworten, wie alt ein zwischengespeicherter Zuschlag sein darf.
Für jeden Cache muss das Entwicklungsteam drei Fragen beantworten:
- Wo die Kopie liegt: im Arbeitsspeicher des Programms, in einem gemeinsamen Cache-Dienst für mehrere Exemplare des Programms, im Browser des Nutzers oder auf Servern in der Nähe der Nutzer. Beim Tarifrechner liegt die Kopie im Arbeitsspeicher jedes Exemplars, und jedes Exemplar hat seine eigene Kopie.
- Wodurch eine Kopie ungültig wird: durch eine feste Ablaufzeit oder dadurch, dass das Programm sie bei einer Änderung der Quelle ausdrücklich löscht.
- Was entfernt wird, wenn der Cache voll ist: Meist entfernt der Cache die Einträge, die am längsten nicht mehr gebraucht wurden.
Caches stecken in vielen Teilen eines Computersystems gleichzeitig: im Prozessor, in der Datenbank, im Programm, im Netz und im Browser.
Kommt die Nachricht zum Leeren bei einem Exemplar des Tarifrechners nicht an, rechnet dieses Exemplar bis zu einer Stunde lang mit den alten Zuschlägen, bis seine Kopie abläuft.
Caching: Risikozuschläge zwischen zwei Berechnungen
Wann ist es sinnvoll und wann nicht?
Caching lohnt sich
- Dieselben Daten werden oft gelesen und selten geändert. Beispiele sind Tariftabellen und Produktbeschreibungen. Ohne Cache liest der Tarifrechner die Tabelle der Risikozuschläge für jedes Angebot neu, obwohl sie sich nur einmal im Monat ändert.
- Das Beschaffen eines Ergebnisses dauert lange oder belastet die Quelle. Ein Beispiel ist eine Datenbankabfrage über viele Tabellen. Ebenso gehören der Aufruf eines entfernten Dienstes und lange Berechnungen dazu. Ohne Cache wartet jede Anfrage erneut, bis die Abfrage, der Aufruf oder die Berechnung fertig ist.
- Viele gleiche Anfragen würden die Quelle zum Engpass machen. Ohne Cache liest der Tarifrechner für jedes Angebot die Tabelle aus der Datenbank. Im November, wenn viele Kunden ihre Kfz-Versicherung wechseln, stellt der Tarifrechner so täglich Zehntausende gleicher Anfragen an die Datenbank. Jedes Angebot dauert dann länger, und auch andere Programme, die dieselbe Datenbank nutzen, werden langsamer. Mit Cache erhält die Datenbank an solchen Tagen nur wenige Abfragen.
- Ein kurzzeitig veralteter Wert ist hinnehmbar, und das zuständige Fachteam hat festgelegt, wie alt der Wert höchstens sein darf.
Caching ist nicht das Richtige
- Fast jede Anfrage betrifft andere Daten, und die Datenbank beantwortet diese Anfragen schnell genug. Eine Kopie würde dann kaum ein zweites Mal gebraucht, und bei fast jeder Anfrage käme eine vergebliche Suche im Cache hinzu. Dann liest das Programm die Daten bei jeder Anfrage aus der Quelle und verzichtet auf einen Cache. Der Arbeitsspeicher, den die Kopien belegen würden, bleibt frei.
- Veraltete Daten richten Schaden an. Ein Beispiel sind Zugriffsrechte, die gerade entzogen wurden. Dann liest das Programm solche Daten bei jeder Prüfung aus der Quelle. Der Entzug eines Zugriffsrechts wirkt so sofort und nicht erst, wenn eine Kopie abläuft.
- Eine Abfrage ist vor allem wegen ihres Aufbaus langsam. Ein Cache würde die langsame Abfrage nur verdecken, und nach jedem Neustart wäre sie wieder langsam. Stattdessen schreibt das Entwicklungsteam die Abfrage so um, dass die Datenbank sie schneller beantwortet, etwa indem die Abfrage weniger Tabellen verknüpft. Es entsteht keine zweite Kopie, die veralten kann, und kein Cache, der nach Änderungen geleert werden muss.
- Die Datenbank kommt mit den Leseanfragen nicht nach, und fast jede Leseanfrage betrifft andere Daten. Ein Cache fände dann kaum eine passende Kopie und würde die Datenbank nicht entlasten. Stattdessen richtet die Versicherung Read Replicas ein, also zusätzliche Datenbanken, die fortlaufend eine Kopie der Daten erhalten und Leseanfragen beantworten. Die Leseanfragen verteilen sich dann auf mehrere Datenbanken, und die Programme müssen keinen eigenen Cache führen und nach Änderungen leeren. Auch Read Replicas können kurz einen älteren Stand zeigen.
- Ein Abfrageergebnis, das aus vielen Tabellen berechnet wird, wird in der Datenbank selbst gebraucht. Eine Kopie im Arbeitsspeicher eines Programms nützt den Abfragen in der Datenbank nichts. Stattdessen legt das Entwicklungsteam in der Datenbank eine Materialized View an, die das vorberechnete Abfrageergebnis speichert. Die Datenbank muss das Ergebnis dann nicht bei jeder Abfrage neu aus den vielen Tabellen berechnen, und kein Programm muss eine eigene Kopie verwalten.
Nachteile und typische Fehler
Der Cache kann veraltete Daten liefern. Für jede Art von Daten muss festgelegt sein, wie lange ein veralteter Stand hinnehmbar ist und was eine Kopie ungültig macht. Eine kurze Ablaufzeit hält die Kopien aktueller, entlastet die Datenbank aber weniger. Eine lange Ablaufzeit erspart mehr Abfragen und verlängert die Zeit mit alten Werten. Liegt die Kopie im Arbeitsspeicher jedes Exemplars, muss bei jeder Änderung jede dieser Kopien gelöscht werden, und das Entwicklungsteam muss dafür die Nachricht an alle Exemplare einrichten und betreiben. Ein gemeinsamer Cache-Dienst hält nur eine Kopie für alle Exemplare, ist aber ein weiteres Programm, das ausfallen kann. Jeder Cache belegt außerdem Arbeitsspeicher, der für andere Aufgaben fehlt.
Typische Fehler und woran man sie erkennt:
- Leerer Cache nach Neustart: Nach einem Neustart der vier Exemplare ist der Cache jedes Exemplars leer. Jede Angebotsanfrage, die ein Exemplar erreicht, bevor dieses Exemplar die Tabelle geladen hat, liest die Tabelle selbst aus der Datenbank. In den ersten Sekunden nach dem Neustart kommen so viele gleiche Abfragen gleichzeitig bei der Datenbank an. Erkennbar ist das an einer Lastspitze der Datenbank direkt nach dem Neustart der Tarifrechner.
- Vergessenes Leeren: Ein Exemplar erhält die Nachricht zum Leeren nicht und rechnet bis zum Ablauf seiner Kopie mit den alten Zuschlägen. Erkennbar ist das an unterschiedlichen Preisen für dieselbe Anfrage, je nachdem, welches Exemplar das Angebot berechnet.
- Verdeckte langsame Abfrage: Ein Cache verdeckt langsame Abfragen, die man eigentlich verbessern sollte. Das Problem kehrt zurück, sobald der Cache leer ist. Erkennbar ist das an langen Antwortzeiten, die nur nach Neustarts oder nach dem Ablauf der Kopien auftreten.
- Abhängigkeit vom Cache-Dienst: Das Entwicklungsteam ersetzt die Caches in den vier Exemplaren durch einen gemeinsamen Cache-Dienst. Fällt der Cache-Dienst aus, liest der Tarifrechner die Tabelle nicht ersatzweise aus der Datenbank und berechnet gar keine Angebote mehr. Erkennbar ist das an gescheiterten Angeboten, obwohl die Datenbank erreichbar ist.
Weiterführend
Verwandte Ansätze
- Cache Aside, Write Through Cache und Write Behind Cache: drei Verfahren, wie Programm, Cache und Datenbank beim Lesen und Schreiben zusammenarbeiten.
- Content Delivery Network: ein Netz von Servern in der Nähe der Nutzer, die Kopien von Bildern und Webseiten bereithalten.
Werkzeuge und Umsetzungen
- Valkey: gemeinsamer Cache-Dienst, der alle Daten im Arbeitsspeicher hält und von vielen laufenden Exemplaren eines Programms gemeinsam genutzt werden kann.
- Memcached: über mehrere Server verteilbarer Cache für Schlüssel und Werte im Arbeitsspeicher.
- Caffeine und Ehcache: Caches im Arbeitsspeicher von Java-Programmen, wie beim Tarifrechner.
- Vinyl Cache: Cache für Webseiten und Schnittstellen, der vor dem Webserver steht und häufig abgerufene Antworten selbst ausliefert. Das frei entwickelte Projekt hieß bis 2026 Varnish Cache. Unter dem alten Namen vertreibt die Firma Varnish Software inzwischen eine eigene, davon abgeleitete Fassung.
Quellen
- Microsoft: Caching guidance: vertieft Cache im eigenen Arbeitsspeicher und gemeinsamen Cache-Dienst, Ablaufzeiten, das Entfernen lange nicht gebrauchter Einträge, veraltete Kopien und das Ausweichen auf die Datenbank bei einem Ausfall des Caches.
- Roy Fielding, Mark Nottingham, Julian Reschke: RFC 9111, HTTP Caching: Standard für Caches im Netz und im Browser, der festlegt, wie lange eine gespeicherte Antwort als frisch gilt und wann ein Cache sie ungültig machen muss.