
Content Delivery Network
Inhalte von Servern nahe beim Nutzer ausliefern
Die Idee und ihr Nutzen
Eine Versicherung startet eine Fernsehkampagne, und innerhalb von fünf Minuten rufen 200.000 Menschen die Aktionsseite im Internet auf. Bilder und Videos auf dieser Seite sind für alle Besucher gleich, liegen aber nur auf einem einzigen Server der Versicherung in Frankfurt. Viele Server an verschiedenen Orten halten deshalb Kopien dieser Dateien bereit, und jeder Besucher lädt die Dateien von einem Server in seiner Nähe statt vom Server in Frankfurt. Der Server in Frankfurt schickt dann jede Datei nur noch einmal an jeden dieser Server statt an jeden der 200.000 Besucher, und der kürzere Weg kann die Ladezeit verkürzen. Ein solches Netz von Servern heißt Content Delivery Network, kurz CDN, auf Deutsch „Netz zur Auslieferung von Inhalten“.

Wie funktioniert es?
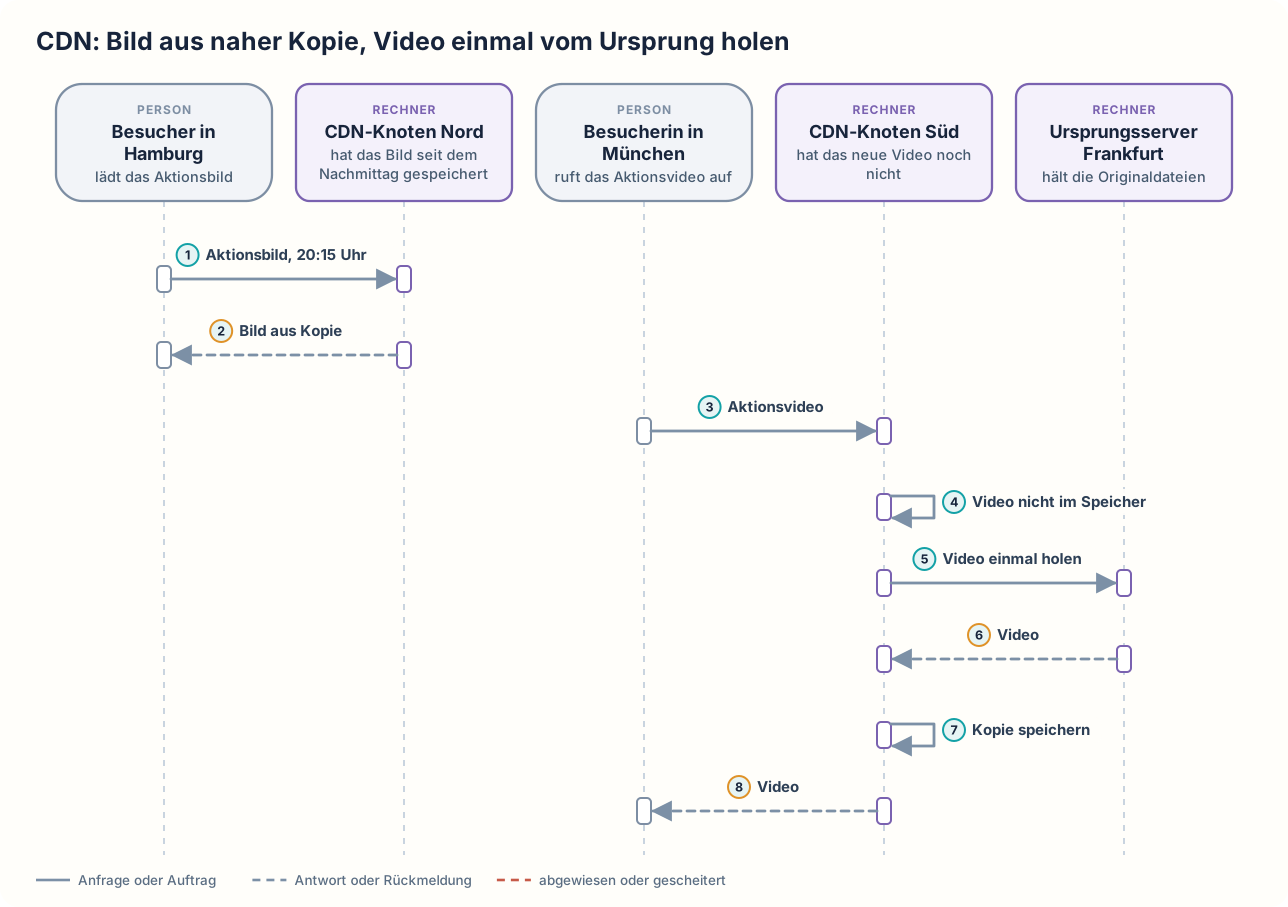
Um 20:15 Uhr läuft der Werbespot. Ein Besucher in Hamburg fragt das Aktionsbild an, und das CDN lenkt seine Anfrage zum CDN-Knoten Nord, einem der Server des CDN in Norddeutschland. CDN-Knoten Nord hat das Bild seit dem Nachmittag gespeichert und liefert es sofort aus. Der Ursprungsserver Frankfurt, auf dem die Originaldateien liegen, wird dafür nicht gefragt. Eine Besucherin in München fragt das Aktionsvideo an, und ihre Anfrage geht an den CDN-Knoten Süd. Das Video wurde erst am Abend hochgeladen, und CDN-Knoten Süd hat es noch nicht. CDN-Knoten Süd holt das Video deshalb einmal beim Ursprungsserver Frankfurt, speichert eine Kopie und liefert das Video an die Besucherin in München aus. Tausende weitere Besucher im Süden bekommen das Video danach direkt vom CDN-Knoten Süd, und der Ursprungsserver Frankfurt erhält nur eine Anfrage je Knoten und Datei.
Die Versicherung betreibt das CDN in der Regel nicht selbst, sondern bucht es als Dienst bei einem CDN-Anbieter, der Server an vielen Orten unterhält. Diese Server heißen CDN-Knoten. Sie arbeiten als Zwischenspeicher, englisch Cache. Ein Zwischenspeicher hält Kopien von Dateien bereit, damit nicht jede Anfrage bis zum Original durchgereicht werden muss. Einen Abruf aus der Kopie wie beim Aktionsbild nennt man Cache-Treffer. Auf allen CDN-Knoten läuft in der Regel dieselbe Software des Anbieters, aber jeder CDN-Knoten speichert seine eigenen Kopien. Hat CDN-Knoten Nord eine Datei schon gespeichert, muss CDN-Knoten Süd sie trotzdem selbst beim Ursprungsserver holen. Der Ursprungsserver hält die Originale: Nur dort ändert die Versicherung Dateien, und die CDN-Knoten holen jede neue Fassung von dort. Damit die Anfragen beim CDN ankommen, zeigen die Adressen der Bilder und Videos auf der Aktionsseite auf das CDN statt auf den Ursprungsserver. Das CDN lenkt jede Anfrage zu einem geeigneten Knoten, meist zu einem in der Nähe des Besuchers. Das geschieht zum Beispiel über das DNS, den Dienst im Internet, der Servernamen in Netzadressen übersetzt. Der gewählte Knoten ist nicht immer der geografisch nächste, sondern der, der gerade am schnellsten erreichbar und nicht überlastet ist.
Wie lange ein CDN-Knoten eine Datei aufbewahrt, legt der Ursprungsserver mit einer Angabe in seiner Antwort fest, etwa „24 Stunden gültig“. Bei 24 Stunden fragt jeder Knoten höchstens einmal am Tag beim Ursprungsserver nach, und eine veraltete Fassung bleibt höchstens einen Tag im Umlauf. Nach diesen 24 Stunden ist die Kopie abgelaufen, und der Knoten holt die Datei beim nächsten Abruf erneut. Erneut holen muss er sie auch, wenn er die Kopie aus Platzgründen entfernt hat. Ändert sich eine Datei vor Ablauf, gibt die Versicherung ihr meist einen neuen Namen, etwa mit einer Versionsnummer, damit alle Knoten die neue Datei holen. Alternativ lässt die Versicherung die alte Kopie im CDN gezielt löschen. Ein CDN-Knoten speichert auch eine Antwort mit persönlichen Daten, etwa eine Vertragsübersicht, wenn der Ursprungsserver sie nicht ausdrücklich als „nicht speichern“ kennzeichnet.
Ist der Ursprungsserver Frankfurt gerade nicht erreichbar, kann ein CDN-Knoten nur die Dateien ausliefern, die er bereits gespeichert hat. Das Aktionsbild kommt dann beim Besucher in Hamburg weiterhin an. CDN-Knoten Süd kann das neue Video dagegen nicht holen, und die Besucherin in München erhält eine Fehlermeldung. Bei manchen CDN-Anbietern lässt sich einstellen, dass ein Knoten in diesem Fall eine bereits abgelaufene Kopie weiter ausliefert.
CDN: Bild aus naher Kopie, Video einmal vom Ursprung holen
Wann ist es sinnvoll und wann nicht?
Ein CDN lohnt sich
- Eine Webseite liefert Dateien aus, die für alle Besucher gleich sind. Solche Dateien sind Bilder, Videos, Schriften, Programmdateien für den Browser und Downloads. Ohne CDN schickt der Ursprungsserver Frankfurt jede dieser Dateien an jeden Besucher einzeln, obwohl alle dieselbe Fassung bekommen. Mit CDN holt jeder CDN-Knoten eine Datei einmal und liefert sie an alle Besucher in seiner Nähe aus.
- Es ist mit starken Lastspitzen zu rechnen, zum Beispiel nach einem Werbespot. Ein Ausbau des Ursprungsservers nur für wenige Minuten im Jahr lohnt sich nicht. Ohne CDN läuft jede Anfrage nach einem Bild oder Video zum Ursprungsserver, auch wenn Tausende Menschen genau dieselbe Datei abrufen. Der Ursprungsserver und seine Internetanbindung sind für Hunderttausende Anfragen in wenigen Minuten nicht ausgelegt. Die Seite lädt dann langsam oder gar nicht, genau in dem Moment, für den die Werbung bezahlt wurde. Mit CDN liefern viele Knoten die Dateien gleichzeitig aus.
- Die Besucher sind weit verteilt. Anfragen aus Hamburg oder München nehmen einen längeren Weg durch das Netz als Anfragen aus Frankfurt, und bei vielen kleinen Dateien summiert sich das zu spürbarer Wartezeit. Mit CDN läuft die Anfrage des Besuchers in Hamburg nur bis zum CDN-Knoten Nord.
- Die Versicherung will die Verschlüsselung der Übertragung und die Abwehr von Angriffen, die einen Server mit Anfragen überfluten sollen, nicht am eigenen Server aufbauen. Ohne CDN müsste die Versicherung beides in Frankfurt selbst einrichten und betreiben, und eine Flut von Anfragen träfe direkt den Ursprungsserver und seine Internetanbindung. Viele CDN-Anbieter übernehmen beides, und die Versicherung kann es mitbuchen.
Ein CDN ist nicht das Richtige
- Die Seite zeigt persönliche Inhalte. Ein Beispiel ist die Vertragsübersicht eines Kunden. Ein CDN-Knoten darf eine solche Seite nicht speichern, sonst erhält sie ein anderer Besucher, und ohne gespeicherte Kopie entlastet der CDN-Knoten den Ursprungsserver nicht. Damit viele gleichzeitige Abrufe der Vertragsübersicht trotzdem beantwortet werden, betreibt die Versicherung mehrere eigene Server, auf denen jeweils dasselbe Programm die persönlichen Seiten erstellt. Ein Lastverteiler verteilt die Anfragen auf diese Server (Load Balancing). Kommen mehr Besucher, nimmt die Versicherung weitere Server dazu. Die Gebühren für einen CDN-Anbieter, dessen Knoten die persönlichen Seiten nur weiterreichen würden, entfallen.
- Lastspitzen sind zu erwarten, aber fast alle Besucher kommen aus der Nähe von Frankfurt, und die Internetanbindung in Frankfurt trägt die Spitzenlast. Ein CDN würde den Weg zu den Besuchern dann kaum verkürzen. Entlastet werden muss nur der Ursprungsserver Frankfurt, der sonst jede Anfrage selbst beantwortet. Dafür betreibt die Versicherung im eigenen Rechenzentrum einen Reverse Proxy mit Zwischenspeicher. Jede Anfrage nach einem Bild oder Video geht zuerst an den Reverse Proxy. Der Reverse Proxy holt jede Datei einmal vom Ursprungsserver Frankfurt, speichert eine Kopie und liefert die Datei danach selbst aus. Die Gebühren des CDN-Anbieters entfallen, und alle Daten bleiben im eigenen Rechenzentrum.
- Angaben über die Besucher, etwa ihre Netzadressen, dürfen aus Datenschutzgründen Deutschland nicht verlassen, und der CDN-Anbieter sichert nicht zu, dass nur Knoten in Deutschland die Anfragen beantworten. Mit CDN könnte die Anfrage eines Besuchers dann an einem Knoten im Ausland ankommen. Stattdessen liefert die Versicherung die Dateien aus ihrem eigenen Rechenzentrum aus, bei Lastspitzen mit einem Reverse Proxy wie im vorigen Punkt. Jede Anfrage kommt so nur in Frankfurt an.
- Fast alle Besucher kommen aus der Nähe von Frankfurt, und Lastspitzen sind nicht zu erwarten. Dann liefert der Ursprungsserver Frankfurt alle Dateien selbst aus. Ein CDN würde die Ladezeit kaum verkürzen, weil der Weg zum Ursprungsserver ohnehin kurz ist. Die Versicherung spart die Gebühren des CDN-Anbieters und hängt nicht von seinem Netz ab.
Nachteile und typische Fehler
Die Versicherung wird vom CDN-Anbieter abhängig. Fällt sein Netz aus, sind die Inhalte nicht erreichbar, auch wenn der Ursprungsserver läuft. Bei einem fremden CDN-Anbieter laufen alle Anfragen über Server eines anderen Unternehmens. Die Versicherung muss festlegen, welche Inhalte und welche Angaben über Besucher dort verarbeitet werden dürfen. Hinzu kommen laufende Kosten, die meist von der übertragenen Datenmenge abhängen, und die Pflege der Einstellungen. Für jede Art von Datei muss festgelegt sein, wie lange die Knoten sie aufbewahren, und für jede Änderung, ob die Datei einen neuen Namen bekommt oder die alte Kopie gelöscht wird. Je länger die Knoten eine Datei aufbewahren, desto seltener fragen sie beim Ursprungsserver nach und desto länger kann eine veraltete Fassung ausgeliefert werden. Ob die Seite für die Besucher in Hamburg und München tatsächlich schneller lädt, zeigt erst eine Messung, denn das hängt auch von ihrer eigenen Internetverbindung ab.
Typische Fehler und woran man sie erkennt:
- Veraltete Fassung: Die Versicherung ändert das Aktionsbild, behält den Namen bei und lässt die alte Kopie im CDN löschen. Das Löschen gelingt bei CDN-Knoten Süd, bei CDN-Knoten Nord aber nicht. CDN-Knoten Nord liefert die alte Fassung dann weiter aus, bis seine Kopie nach 24 Stunden abläuft. Erkennbar ist das an Besuchern, die je nach Ort unterschiedliche Fassungen des Aktionsbilds sehen.
- Persönliche Daten an Fremde: Der Ursprungsserver kennzeichnet die Vertragsübersicht nicht als „nicht speichern“, und die Vertragsübersicht hat für alle Kunden dieselbe Adresse. Ein CDN-Knoten speichert die Vertragsübersicht des ersten Kunden, der sie abruft. Danach liefert der CDN-Knoten diese Kopie an alle weiteren Besucher aus, die dieselbe Adresse aufrufen. Das ist einer der schwersten möglichen Fehler. Erkennbar ist das an Meldungen von Kunden, die fremde Namen oder Verträge sehen, und an Antworten mit persönlichen Inhalten, die im CDN als Cache-Treffer ausgeliefert wurden.
- Kaum Cache-Treffer: Die Adressen der Dateien enthalten wechselnde Zusätze, etwa eine Kennung des Besuchers, sodass jeder Abruf für den Knoten eine neue Datei ist. Jede Anfrage läuft dann doch bis zum Ursprungsserver. Rufen 200.000 Besucher das Aktionsbild ab, erhält der Ursprungsserver 200.000 Anfragen statt einer je CDN-Knoten. Erkennbar ist das an einem niedrigen Anteil an Cache-Treffern und an einer Last auf dem Ursprungsserver, die mit der Zahl der Besucher steigt.
- Ursprungsserver direkt erreichbar: Der Ursprungsserver nimmt weiterhin Anfragen direkt aus dem Internet an. Angreifer oder falsch eingestellte Programme schicken ihre Anfragen unter seiner eigenen Adresse direkt an den Ursprungsserver, an den CDN-Knoten vorbei. Der Ursprungsserver muss jede dieser Anfragen selbst beantworten. Kommen genug solche Anfragen, kann er auch CDN-Knoten Süd das neue Video nicht mehr liefern. Erkennbar ist das an Anfragen am Ursprungsserver, die nicht von den CDN-Knoten stammen.
Weiterführend
Verwandte Ansätze
- Caching: erklärt das Prinzip des Zwischenspeicherns, auf dem ein CDN beruht.
- Edge Computing: verlagert nicht nur Dateien, sondern auch Rechenarbeit auf Server in der Nähe der Nutzer.
Werkzeuge und Umsetzungen
Ein weltweites CDN ist meist ein Dienst großer Anbieter. Mit diesen Projekten lässt sich ein eigenes aufbauen:
- Apache Traffic Server: Zwischenspeicher für Webinhalte, der in großen Auslieferungsnetzen eingesetzt wird.
- Apache Traffic Control: verwaltet viele Traffic-Server-Knoten als gemeinsames CDN und lenkt Anfragen zum passenden Knoten.
- Vinyl Cache: Zwischenspeicher, der Anfragen an einen Webserver zuerst annimmt und gespeicherte Antworten selbst ausliefert, oft als Baustein eigener Auslieferungsnetze. Das frei entwickelte Projekt hieß bis 2026 Varnish Cache. Unter dem alten Namen vertreibt die Firma Varnish Software inzwischen eine eigene, davon abgeleitete Fassung.
- NGINX: Webserver, der sich an vielen Standorten als Zwischenspeicher betreiben lässt.
Quellen
- Amazon Web Services: How CloudFront delivers content: beschreibt für ein verbreitetes CDN, wie das DNS eine Anfrage zu einem nahen Knoten lenkt, wie der Knoten bei einem Cache-Treffer antwortet und wann er die Datei beim Ursprungsserver holt.
- IETF: RFC 9111, HTTP Caching: Standard, der festlegt, wie lange ein gemeinsam genutzter Zwischenspeicher eine Antwort verwenden darf und wie ein Ursprungsserver mit den Angaben „private“ und „no-store“ verhindert, dass persönliche Antworten dort gespeichert werden.