
Edge Computing
Verarbeitung nahe an der Datenquelle
Die Idee und ihr Nutzen
Eine Kfz-Versicherung bietet einen Tarif an, bei dem ein kleines Gerät im Auto das Fahrverhalten misst. Die Sensoren im Auto liefern jede Sekunde viele Messwerte, etwa Geschwindigkeit, Beschleunigung und Position. Würde das Gerät alle Messwerte über Mobilfunk an das Rechenzentrum der Versicherung schicken, entstünden große Datenmengen und hohe Mobilfunkkosten. Stattdessen wertet das Gerät, der Rechner im Fahrzeug, die Messwerte selbst aus und sendet nur das Ergebnis. Ein solches Ergebnis ist „42 km, 2 starke Bremsungen“. Statt Zehntausender Messwerte überträgt der Rechner im Fahrzeug nach einer Fahrt nur diese Zusammenfassung. Erkennt der Rechner im Fahrzeug einen Unfall, meldet er den Unfall sofort selbst einem Notfalldienst, der Hilfe schickt, ohne dass die Messwerte erst ins Rechenzentrum müssen. Diese Verarbeitung dort, wo die Daten entstehen, heißt Edge Computing. Das englische Wort edge bedeutet Rand; gemeint sind Geräte am Rand des Netzes wie der Rechner im Fahrzeug, weit weg vom Rechenzentrum der Versicherung.

Wie funktioniert es?
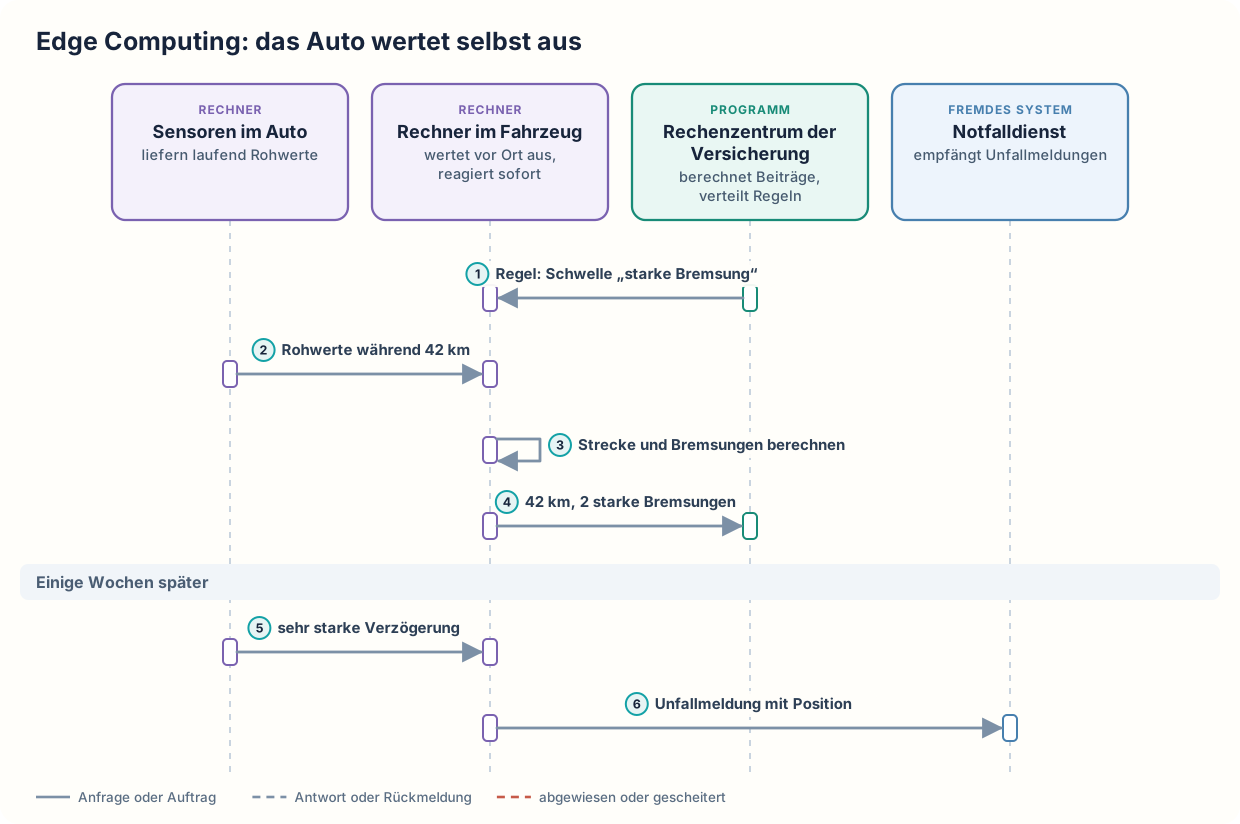
Das Rechenzentrum der Versicherung schickt dem Rechner im Fahrzeug die Regel mit der Schwelle für eine „starke Bremsung“. In jedem Fahrzeug mit diesem Tarif steckt ein solcher Rechner, und auf allen diesen Rechnern läuft dieselbe Software. Deshalb kann das Rechenzentrum der Versicherung dieselbe Software und dieselben Regeln an alle Rechner in den Fahrzeugen verteilen. Eine Kundin fährt morgens 42 Kilometer zur Arbeit. Während der Fahrt liefern die Sensoren im Auto Zehntausende Messwerte an den Rechner im Fahrzeug, und der Rechner im Fahrzeug erkennt dabei zwei starke Bremsungen. Am Ende der Fahrt sendet der Rechner im Fahrzeug nur die Zusammenfassung „42 km, 2 starke Bremsungen“ an das Rechenzentrum der Versicherung. Das Rechenzentrum verwendet die Zusammenfassung für die Beitragsberechnung. Einige Wochen später melden die Sensoren im Auto eine sehr starke Verzögerung, die auf einen Unfall hindeutet. Der Rechner im Fahrzeug erstellt sofort eine Unfallmeldung mit der Position des Fahrzeugs. Er sendet die Unfallmeldung über Mobilfunk an den Notfalldienst, der nach einem Unfall Hilfe schickt. Die Auswertung im Fahrzeug erkennt den Unfall, ohne dass die Messwerte erst ins Rechenzentrum müssen. Hilfe garantiert die Auswertung im Fahrzeug aber nicht: Ob die Unfallmeldung rechtzeitig ankommt, hängt vom Mobilfunknetz und vom Notfalldienst ab.
Die Sensoren im Auto messen Beschleunigung, Geschwindigkeit und Position mehrmals pro Sekunde. Auf einer Fahrt von einer halben Stunde entstehen so Zehntausende Messwerte. Der Rechner im Fahrzeug berechnet die gefahrene Strecke und die Zahl starker Bremsungen und trifft Entscheidungen, die schnell fallen müssen. Eine solche Entscheidung ist, ob eine Unfallmeldung nötig ist. Das Rechenzentrum der Versicherung erhält nur die Ergebnisse und berechnet daraus die Beiträge. Die Fahrzeuge sind über Mobilfunk mit dem Rechenzentrum verbunden. Diese Verbindung kostet Geld je übertragener Datenmenge, ist nicht überall verfügbar und bringt eine Verzögerung mit sich. Die Rechner in den Fahrzeugen stehen beim Kunden, außerhalb der Räume und der Aufsicht des IT-Betriebs der Versicherung.
Ob zusätzlich alle Messwerte übertragen werden müssen, legt die Versicherung für den konkreten Tarif fest. Ein Grund dafür kann sein, dass bei einem Streit über einen Unfallhergang ein Nachweis gebraucht wird. Besteht gerade keine Mobilfunkverbindung, ist die Auswertung im Fahrzeug trotzdem erfolgt, aber das Ergebnis ist noch nicht angekommen. Ohne Zwischenspeicher im Rechner im Fahrzeug geht das Ergebnis verloren; mit Zwischenspeicher sendet der Rechner im Fahrzeug das Ergebnis später. Diesen Zwischenspeicher muss die Versicherung eigens in die Software des Rechners im Fahrzeug einbauen, denn nicht jede Anwendung am Rand des Netzes hat einen Zwischenspeicher. Eine andere Form von Edge Computing sind kleine Programme auf Servern, die Webseiten von Standorten nahe den Nutzern ausliefern. Ein solches Programm kann zum Beispiel die Startseite der Versicherung in der Sprache des Landes ausliefern, aus dem ein Nutzer sie aufruft.
Edge Computing: das Auto wertet selbst aus
Wann ist es sinnvoll und wann nicht?
Edge Computing lohnt sich
- Vor Ort muss schnell reagiert werden. Beispiele sind die Unfallerkennung und die Steuerung von Maschinen in einer Fabrik. Erkennt das Rechenzentrum einen Unfall erst, wenn alle Messwerte dort angekommen sind, vergeht Zeit, in der der Notfalldienst noch keine Hilfe schicken kann. In einem Funkloch kommen die Messwerte gar nicht an.
- Es entstehen große Datenmengen, von denen nur wenig gebraucht wird. Beispiele sind Sensordaten und Videobilder. Für den Tarif braucht die Versicherung nur zwei Angaben, nämlich wie weit gefahren und wie oft stark gebremst wurde. Schickt der Rechner im Fahrzeug alle Messwerte ins Rechenzentrum, entstehen hohe Mobilfunkkosten, und das Rechenzentrum muss Daten von Hunderttausenden Fahrzeugen verarbeiten, von denen es fast alles gleich wieder verwirft.
- Daten sollen aus Datenschutzgründen den Ort nicht verlassen. Ohne Edge Computing gehen die genauen Bewegungsdaten der Kundin ins Rechenzentrum der Versicherung, also wann sie wo gefahren ist. Verlangt der Tarif nur Strecke und Bremsungen, müssen die genauen Bewegungsdaten der Kundin das Fahrzeug nicht verlassen.
Edge Computing ist nicht das Richtige
- Ein Tarif braucht nur wenige Messwerte, etwa einmal pro Minute Position und Geschwindigkeit, und sieht keine Unfallmeldung vor. Eine Auswertung im Fahrzeug würde dann kaum Übertragung sparen, und keine Entscheidung muss sofort im Fahrzeug fallen. Dann schickt der Rechner im Fahrzeug die Messwerte unverändert ins Rechenzentrum. Dort wertet ein Programm die Messwerte mit Stream Processing fortlaufend aus, sobald sie eintreffen, und berechnet die Strecke. Die Versicherung muss dann keine Auswertungssoftware an Hunderttausende Rechner in den Fahrzeugen verteilen und dort gegen Manipulation absichern.
- Eine Auswertung braucht die Fahrdaten aller Kunden, etwa der Vergleich der Fahrweise einer Kundin mit der Fahrweise ähnlicher Fahrer. Der Rechner im Fahrzeug kennt nur die Fahrten des eigenen Fahrzeugs. Für diesen Vergleich müsste die Versicherung die Daten Hunderttausender Kunden an jeden Rechner im Fahrzeug schicken. Stattdessen führt das Rechenzentrum der Versicherung den Vergleich aus, denn dort kommen die Zusammenfassungen aller Fahrzeuge ohnehin an. Strecke und Bremsungen zählen weiter die Rechner in den Fahrzeugen.
- Die Versicherung ändert die Auswertung der Messwerte häufig. Jede Änderung müsste dann an Hunderttausende Rechner in den Fahrzeugen gehen, und ein Fahrzeug, das wochenlang ohne Empfang in einer Tiefgarage steht, rechnet so lange mit der alten Auswertung. Stattdessen schicken die Rechner in den Fahrzeugen die Messwerte ins Rechenzentrum, und das Rechenzentrum der Versicherung wertet sie aus. Eine Änderung der Auswertung spielt die Versicherung dann nur im Rechenzentrum ein, und ab diesem Zeitpunkt gilt die neue Auswertung für alle Fahrzeuge.
- Die Versicherung muss alle Messwerte ohnehin vollständig und dauerhaft zentral speichern, etwa als Nachweis bei einem Streit über einen Unfallhergang, und eine Unfallmeldung gehört nicht zum Tarif. Dann wertet das Rechenzentrum der Versicherung die übertragenen Messwerte für den Beitrag aus. Eine Auswertung im Fahrzeug würde keine Übertragung sparen und nur zusätzliche Software auf jedem Rechner im Fahrzeug erfordern, die verteilt und abgesichert werden muss.
- Die Versicherung will nur die Dateien ihrer Webseite, etwa Bilder, von Servern in der Nähe der Nutzer ausliefern. Dann liefert ein Content Delivery Network die Dateien aus, ein Netz von Servern in der Nähe der Nutzer, die Kopien der Dateien bereithalten. Eigene Programme auf diesen Servern muss dann niemand schreiben, verteilen und pflegen. Edge Computing braucht es erst, wenn auf diesen Servern zusätzlich eigene Programme laufen sollen, etwa eines, das die Startseite in der Sprache des Nutzers ausliefert.
Nachteile und typische Fehler
Die Auswertung ist nicht mehr im Rechenzentrum, sondern auf Hunderttausende Rechner in den Fahrzeugen verteilt. Diese Geräte müssen aktualisiert, überwacht und abgesichert werden, und zwar an Orten ohne IT-Personal. Die Versicherung braucht dafür eine Verteilung von Software und Regeln an alle Rechner in den Fahrzeugen und eine Übersicht, welcher Softwarestand auf welchem Gerät läuft. Geräte vor Ort sind für jeden zugänglich. Sie können manipuliert oder gestohlen werden, und ihre Ergebnisse müssen deshalb gegen Fälschung geschützt sein. Weil das Rechenzentrum nur Ergebnisse sieht, ist es auf die Richtigkeit der Berechnung im Fahrzeug angewiesen. Ein Fehler in dieser Berechnung lässt sich ohne die Messwerte nachträglich kaum korrigieren.
Typische Fehler und woran man sie erkennt:
- Gefälschte Fahrwerte: Ein Kunde verändert die Software auf dem Rechner in seinem Fahrzeug, sodass der Rechner weniger starke Bremsungen zählt, als es gab. Der Rechner im Fahrzeug sendet dann plausibel aussehende, aber falsche Zusammenfassungen an das Rechenzentrum der Versicherung. Erkennbar ist das an Fahrwerten, die nicht zu Schadenmeldungen oder zu Vergleichsdaten ähnlicher Fahrzeuge passen.
- Unterschiedliche Softwarestände: Die Versicherung verteilt eine neue Schwelle für eine „starke Bremsung“. Ein Teil der Rechner in den Fahrzeugen wird nicht rechtzeitig aktualisiert, etwa weil das Fahrzeug wochenlang ohne Mobilfunkempfang in einer Tiefgarage steht. Diese Rechner zählen Bremsungen noch mit der alten Schwelle, und gleiche Fahrweisen führen zu unterschiedlichen Beiträgen. Erkennbar ist das an Abweichungen in den Zusammenfassungen, die mit dem Softwarestand der Geräte zusammenhängen.
- Verlorene Ergebnisse im Funkloch: Der Rechner im Fahrzeug hat keinen Zwischenspeicher. Eine Fahrt endet in einem Funkloch, und der Rechner im Fahrzeug kann die Zusammenfassung der Fahrt nicht senden. Der Rechner verwirft die Zusammenfassung, und das Rechenzentrum der Versicherung erhält sie nie. Erkennbar ist das an Fahrzeugen mit Lücken in den gemeldeten Fahrten, häufig in Gegenden mit schlechtem Empfang.
- Fehlerhafte Regel an alle Geräte: Das Rechenzentrum der Versicherung verteilt eine falsch eingestellte Schwelle für eine „starke Bremsung“ an alle Rechner in den Fahrzeugen. Ab diesem Tag zählen alle Rechner falsch, etwa jedes gewöhnliche Abbremsen an einer Ampel als starke Bremsung, und die Beiträge aller Kunden dieses Tarifs werden falsch berechnet. Erkennbar ist das an einem plötzlichen Anstieg oder Abfall der gemeldeten Bremsungen ab dem Tag der Verteilung.
Weiterführend
Verwandte Ansätze
- Eventual Consistency: beschreibt, wie getrennte Datenbestände später wieder übereinstimmen. Steht ein Fahrzeug in einem Funkloch, fehlt dem Rechenzentrum der Versicherung die Zusammenfassung der letzten Fahrt, bis der Rechner im Fahrzeug sie aus dem Zwischenspeicher nachsendet.
Werkzeuge und Umsetzungen
- K3s: Fassung von Kubernetes, einer verbreiteten Plattform zum Betrieb von Anwendungen auf vielen Servern. K3s wird als einzelne Programmdatei geliefert und läuft auch auf kleinen Rechnern vor Ort.
- KubeEdge: verwaltet Anwendungen auf Geräten am Rand des Netzes zentral und hält sie auch bei unterbrochener Verbindung lauffähig.
- EdgeX Foundry: Plattform, die Sensordaten vor Ort sammelt, verarbeitet und weitergibt.
Quellen
- Michaela Iorga u. a., NIST: Fog Computing Conceptual Model, Special Publication 500-325: Veröffentlichung des US-amerikanischen Standardisierungsinstituts NIST von 2018; sie beschreibt, wie Auswertung und Verwaltung von Anwendungen aus zentralen Rechenzentren näher an die Geräte verlagert werden.
- Amazon Web Services: What is AWS IoT Greengrass?: Dokumentation einer Laufzeitumgebung für Geräte, auf denen Daten nahe ihrer Entstehung gefiltert, zusammengefasst und ausgewertet werden und die auf Ereignisse vor Ort selbst reagieren.