
Cache Aside
Die Anwendung füllt den Cache bei Bedarf
Die Idee und ihr Nutzen
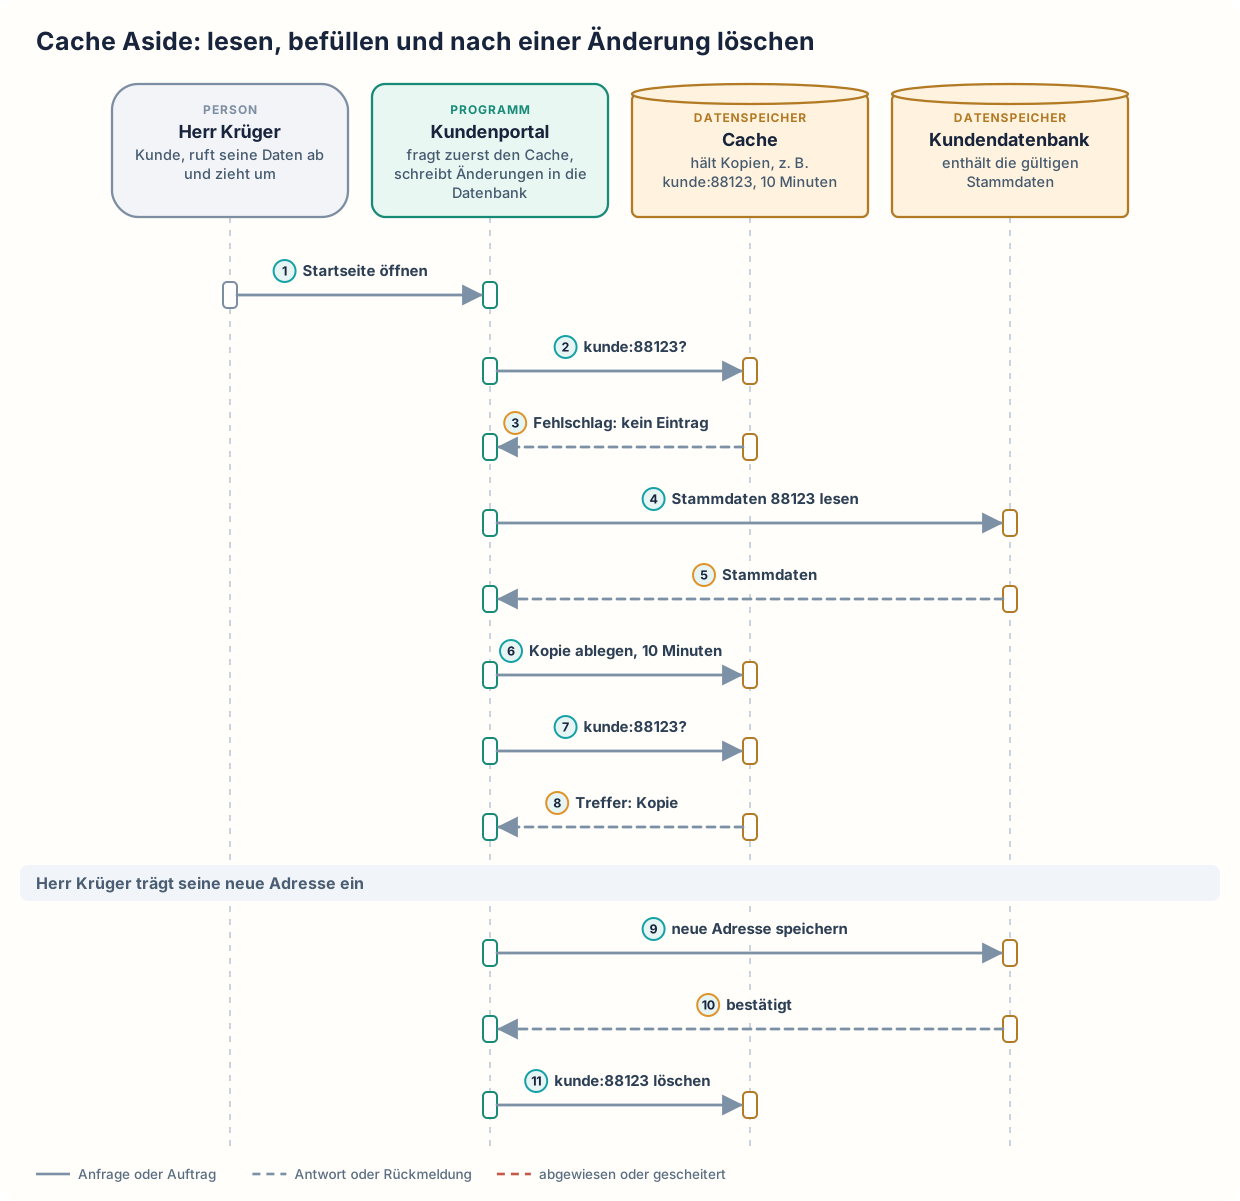
Das Kundenportal einer Versicherung zeigt Name, Adresse und Verträge eines Kunden auf fast jeder Seite. Damit es diese Angaben nicht bei jedem Seitenaufruf aus der Kundendatenbank lesen muss, legt es eine Kopie in einem Zwischenspeicher ab, dem Cache, der schneller antwortet als die Kundendatenbank. Findet das Kundenportal die Angaben im Cache nicht, liest es sie aus der Kundendatenbank und legt danach selbst eine Kopie in den Cache. Ändert der Kunde seine Adresse, speichert das Kundenportal die neue Adresse in der Kundendatenbank und löscht die alte Kopie im Cache, weil es sonst weiter die frühere Adresse zeigen würde. Dieses Verfahren, bei dem das Kundenportal den Cache selbst verwaltet, heißt Cache Aside, auf Deutsch etwa „Cache daneben“. Der Name meint: Keine Anfrage geht durch den Cache an die Kundendatenbank. Das Kundenportal fragt zuerst den Cache und bei einem Fehlschlag selbst die Kundendatenbank, und der Cache liest nie Daten aus der Kundendatenbank.

Wie funktioniert es?
Herr Krüger, ein Kunde der Versicherung, öffnet morgens das Kundenportal. Die Angaben eines Kunden wie Name, Adresse und Verträge heißen Stammdaten. Jeder Eintrag im Cache hat einen Schlüssel, unter dem er abgelegt ist. Für Herrn Krüger mit der Kundennummer 88123 lautet der Schlüssel kunde:88123. Das Kundenportal sucht zuerst im Cache unter diesem Schlüssel. Weil heute noch niemand die Daten von Herrn Krüger abgerufen hat, meldet der Cache einen Fehlschlag: Unter dem Schlüssel liegt kein Eintrag. Das Kundenportal liest die Stammdaten deshalb aus der Kundendatenbank, und die Kundendatenbank liefert die gültigen Daten. Das Kundenportal legt eine Kopie mit einer Ablaufzeit von zehn Minuten im Cache ab und zeigt die Seite; nach Ablauf der zehn Minuten löscht der Cache die Kopie selbst. Die zehn Minuten reichen für einen üblichen Besuch im Kundenportal, sodass das Kundenportal die Stammdaten meist nur einmal je Besuch aus der Kundendatenbank liest; länger soll eine veraltete Kopie nicht im Cache bleiben. Als Herr Krüger zur Vertragsübersicht wechselt, fragt das Kundenportal wieder den Cache. Diesmal ist die Kopie da, und die Kundendatenbank wird nicht gefragt. Wenig später trägt Herr Krüger seine neue Adresse ein, weil er umgezogen ist. Das Kundenportal schreibt die Adresse zuerst in die Kundendatenbank und wartet, bis die Kundendatenbank die Änderung bestätigt. Erst dann löscht das Kundenportal die Kopie unter kunde:88123 im Cache. Beim nächsten Seitenaufruf fehlt der Eintrag. Das Kundenportal liest die neue Adresse aus der Kundendatenbank und legt eine frische Kopie ab. Hätte das Kundenportal die Kopie nicht gelöscht, hätte Herr Krüger bis zu zehn Minuten lang seine alte Adresse gesehen.
Ein Cache antwortet viel schneller als eine Datenbank, weil er die Daten im Arbeitsspeicher hält. Auf mehreren Servern läuft je ein Exemplar desselben Kundenportals. Alle Exemplare verwenden denselben Cache, den die Versicherung als eigenes Programm betreibt. Deshalb findet jedes Exemplar eine Kopie, die ein anderes Exemplar abgelegt hat, und eine gelöschte Kopie fehlt für alle Exemplare. Auch die Anwendungen der Sachbearbeiter nutzen die Kundendatenbank. Cache und Kundendatenbank sind getrennte Programme, die nicht miteinander verbunden sind: Der Cache holt sich keine Daten aus der Kundendatenbank, und die Kundendatenbank meldet dem Cache keine Änderungen. Deshalb füllt das Kundenportal den Cache selbst und löscht veraltete Kopien selbst. Gültig sind nur die Daten in der Kundendatenbank, der Cache enthält Kopien. Nach einer Änderung löscht das Kundenportal den Eintrag, statt ihn mit dem neuen Wert zu überschreiben. Das ist meist sicherer: Beim Überschreiben müsste das Kundenportal Name, Adresse und Verträge selbst richtig zusammensetzen, und ein Fehler dabei bliebe bis zum Ende der Ablaufzeit im Cache.
Auch wenn das Kundenportal zuerst schreibt und erst dann löscht, sind veraltete Kopien nicht ganz ausgeschlossen. Eine Anfrage liest zum Beispiel die alte Adresse aus der Kundendatenbank. Kurz danach speichert eine andere Anfrage die neue Adresse und löscht den Eintrag im Cache. Erst dann legt die erste Anfrage ihre Kopie mit der alten Adresse in den Cache. Diese veraltete Kopie bleibt bis zum Ende ihrer Ablaufzeit im Cache. Cache Aside garantiert deshalb nicht, dass jede Leseanfrage sofort den neuesten Stand erhält. Fällt der Cache aus oder startet er leer, liest das Kundenportal die Stammdaten weiter aus der Kundendatenbank. Die Seiten werden dann langsamer, bleiben aber erreichbar.
Cache Aside: lesen, befüllen und nach einer Änderung löschen
Wann ist es sinnvoll und wann nicht?
Cache Aside lohnt sich
- Daten werden viel häufiger gelesen als geändert. Beispiele sind Kundenstammdaten und Tariftabellen. Stammdaten liest das Kundenportal bei fast jedem Seitenaufruf, Kunden ändern sie aber nur selten, etwa nach einem Umzug. Ohne Cache liest das Kundenportal dieselben, kaum veränderten Stammdaten bei jedem Seitenaufruf neu aus der Kundendatenbank.
- Die Datenbank würde sonst zum Engpass. Das Kundenportal braucht die Stammdaten auf der Startseite, in der Vertragsübersicht und beim Melden eines Schadens. Liest das Kundenportal sie jedes Mal aus der Kundendatenbank, stellt es Tausende gleichartiger Anfragen pro Minute. Dann werden alle Seiten des Kundenportals langsamer, und ebenso die Anwendungen der Sachbearbeiter, die dieselbe Kundendatenbank nutzen.
- Der Cache arbeitet nicht von selbst mit der Datenbank zusammen, und die Anwendung soll genau steuern, was im Cache liegt. Im Cache liegen dann nur Stammdaten, die tatsächlich abgerufen wurden, nicht die Stammdaten aller Kunden der Versicherung. Ein Cache, der die Stammdaten aller Kunden vorab lädt, bräuchte Arbeitsspeicher auch für Kunden, die das Kundenportal nie aufrufen.
- Eine kurze Zeit mit einem veralteten Stand ist fachlich hinnehmbar. Ein Beispiel ist die Anzeige einer Adresse. Eine alte Adresse für einige Minuten ist ärgerlich, richtet aber meist keinen Schaden an.
Cache Aside ist nicht das Richtige
- Jede Leseanfrage muss sofort den neuesten Stand erhalten. Ein Beispiel ist ein Kontostand während einer Buchung, bei dem ein veralteter Stand Schaden anrichtet. Cache Aside garantiert den neuesten Stand nicht, weil eine veraltete Kopie bis zum Ende ihrer Ablaufzeit im Cache bleiben kann. Dann liest die Anwendung solche Daten bei jeder Anfrage direkt aus der Datenbank. Ein veralteter Stand aus dem Cache kann so nicht vorkommen.
- Der Cache soll nach jeder Änderung den neuen Wert enthalten, ohne dass jede Anwendung selbst Einträge löscht. Dann schreiben die Anwendungen jede Änderung in einen Write Through Cache, der die Änderung in die Datenbank weiterschreibt und selbst den neuen Wert behält. Keine Anwendung muss dann nach einer Änderung einen Eintrag im Cache löschen.
- Fast jede Anfrage liest andere Daten, und die Kundendatenbank kommt mit den Leseanfragen nicht nach. Das Kundenportal fände dann kaum etwas im Cache, und die zusätzliche Nachfrage beim Cache würde jede Anfrage nur verlängern. Stattdessen richtet die Versicherung Read Replicas ein, also zusätzliche Kopien der ganzen Kundendatenbank, die Leseanfragen beantworten. Die Leseanfragen verteilen sich dann auf mehrere Kopien, und die Nachfrage beim Cache, die fast nie etwas findet, entfällt.
- Mehrere Programme schreiben direkt in dieselbe Datenbank, und nicht alle lassen sich so ändern, dass sie nach einer Änderung den Eintrag im Cache löschen. Dann liest ein zusätzliches Programm jede gespeicherte Änderung aus dem Änderungsprotokoll der Datenbank und löscht den betroffenen Eintrag im Cache. Das heißt Change Data Capture. Die Programme, die sich nicht ändern lassen, müssen dann nichts über den Cache wissen.
Nachteile und typische Fehler
Beim ersten Zugriff auf einen Eintrag dauert das Lesen etwas länger als ohne Cache, weil das Kundenportal erst den Cache und dann die Kundendatenbank fragt. Der Programmcode für das Lesen und Löschen steckt in jeder Anwendung, die den Cache nutzt, und muss überall gleich umgesetzt sein. Auch Anwendungen, die nur in die Kundendatenbank schreiben und nie aus dem Cache lesen, müssen nach jeder Änderung den Eintrag im Cache löschen und hängen so vom Cache ab. Der Cache ist ein zusätzliches Programm, das betrieben, überwacht und mit genug Arbeitsspeicher ausgestattet werden muss. Die Länge der Ablaufzeit muss abgewogen werden: Eine kurze Ablaufzeit führt zu mehr Anfragen an die Kundendatenbank, eine lange Ablaufzeit lässt veraltete Kopien länger bestehen.
Typische Fehler und woran man sie erkennt:
- Gleichzeitiger Ablauf: Viele häufig gelesene Einträge laufen gleichzeitig ab, weil sie zur selben Zeit angelegt wurden. Der Cache startet zum Beispiel um 8 Uhr leer, und in den folgenden Sekunden legt das Kundenportal die Stammdaten Tausender Kunden im Cache ab. Um 8:10 Uhr laufen diese Einträge gemeinsam ab, und die Leseanfragen aller dieser Kunden gehen auf einmal an die Kundendatenbank. Erkennbar ist das an regelmäßigen Lastspitzen der Kundendatenbank im Abstand der Ablaufzeit.
- Schreiben am Cache vorbei: Eine Anwendung der Sachbearbeiter schreibt eine Adressänderung direkt in die Kundendatenbank, ohne den Eintrag im Cache zu löschen. Die alte Kopie bleibt dann bis zum Ablauf im Cache. Erkennbar ist das an Kunden, die nach einer Änderung durch einen Sachbearbeiter noch einige Minuten den alten Stand sehen.
- Vergessenes Löschen: Das Kundenportal speichert eine Änderung in der Kundendatenbank, löscht aber den Eintrag im Cache nicht. Dann zeigt das Kundenportal bis zum Ablauf der Kopie veraltete Daten. Erkennbar ist das an Beschwerden von Kunden, die nach dem Speichern noch ihre alte Adresse sehen.
- Falsche Reihenfolge: Das Kundenportal löscht den Eintrag im Cache, bevor die Kundendatenbank die Änderung bestätigt hat. Zwischen dem Löschen und der Bestätigung findet eine gleichzeitige Leseanfrage keinen Eintrag im Cache. Die Leseanfrage liest den alten Stand aus der Kundendatenbank und legt ihn erneut in den Cache. Erkennbar ist das an veralteten Kopien, die nur gelegentlich und bei vielen gleichzeitigen Zugriffen auftreten.
Weiterführend
Verwandte Ansätze
- Caching: erklärt das allgemeine Prinzip von Zwischenspeichern und ihre Risiken.
- Write Behind Cache: schreibt Änderungen ebenfalls über den Cache in die Datenbank, statt dass die Anwendung Cache und Datenbank getrennt anspricht.
Werkzeuge und Umsetzungen
- Valkey: Datenspeicher, der alle Daten im Arbeitsspeicher hält und häufig als gemeinsamer Cache für mehrere laufende Exemplare einer Anwendung dient. Valkey unterstützt Ablaufzeiten je Eintrag.
- Memcached: Cache für Schlüssel und Werte im Arbeitsspeicher, ebenfalls mit Ablaufzeiten.
- Caffeine: Cache im Arbeitsspeicher einer einzelnen Java-Anwendung. Jedes laufende Exemplar der Anwendung hat dann seinen eigenen Cache, was das Löschen bei Änderungen erschwert.
- Spring Cache: setzt dieses Vorgehen in Spring-Anwendungen über Markierungen im Code um, sogenannte Annotationen. Das Entwicklungsteam muss den Code für das Lesen und Löschen dann nicht selbst schreiben.
Quellen
- Microsoft: Cache-Aside pattern: beschreibt Lesen und Befüllen bei einem Fehlschlag, das Löschen nach einer Änderung in der Datenbank sowie Ablaufzeit, Verdrängung von Einträgen bei vollem Speicher und fehlende Zusage zur Aktualität.
- Amazon Web Services: Caching strategies for Memcached: beschreibt dasselbe Vorgehen unter dem Namen Lazy Loading mit seinen Vor- und Nachteilen und die Ergänzung durch eine Ablaufzeit je Eintrag.