
Autoscaling
Zahl der Instanzen automatisch an die Last anpassen
Die Idee und ihr Nutzen
Nach einem Sturm melden innerhalb einer Stunde 30.000 Kunden über die App einer Versicherung ihre Schäden, viel mehr als an einem normalen Tag. Diese Meldungen nimmt der Meldedienst an, ein Programm der Versicherung. Normalerweise laufen drei Exemplare des Meldedienstes auf verschiedenen Servern, und mit dieser Menge wären sie überlastet. Eine automatische Regel prüft deshalb laufend die gemessene Auslastung des Meldedienstes. Steigt die Auslastung über einen eingestellten Zielwert, startet die Regel weitere Exemplare des Meldedienstes, sogenannte Instanzen. Sinkt die Zahl der Meldungen, beendet die Regel diese Instanzen wieder. Die Versicherung bezahlt zusätzliche Rechenleistung so nur während der Spitze, statt dauerhaft Server für die größte Spitze bereitzuhalten. Dieses automatische Anpassen der Zahl der Instanzen heißt Autoscaling, auf Deutsch automatisches Skalieren, und die Regel heißt deshalb Skalierungsregel.

Wie funktioniert es?
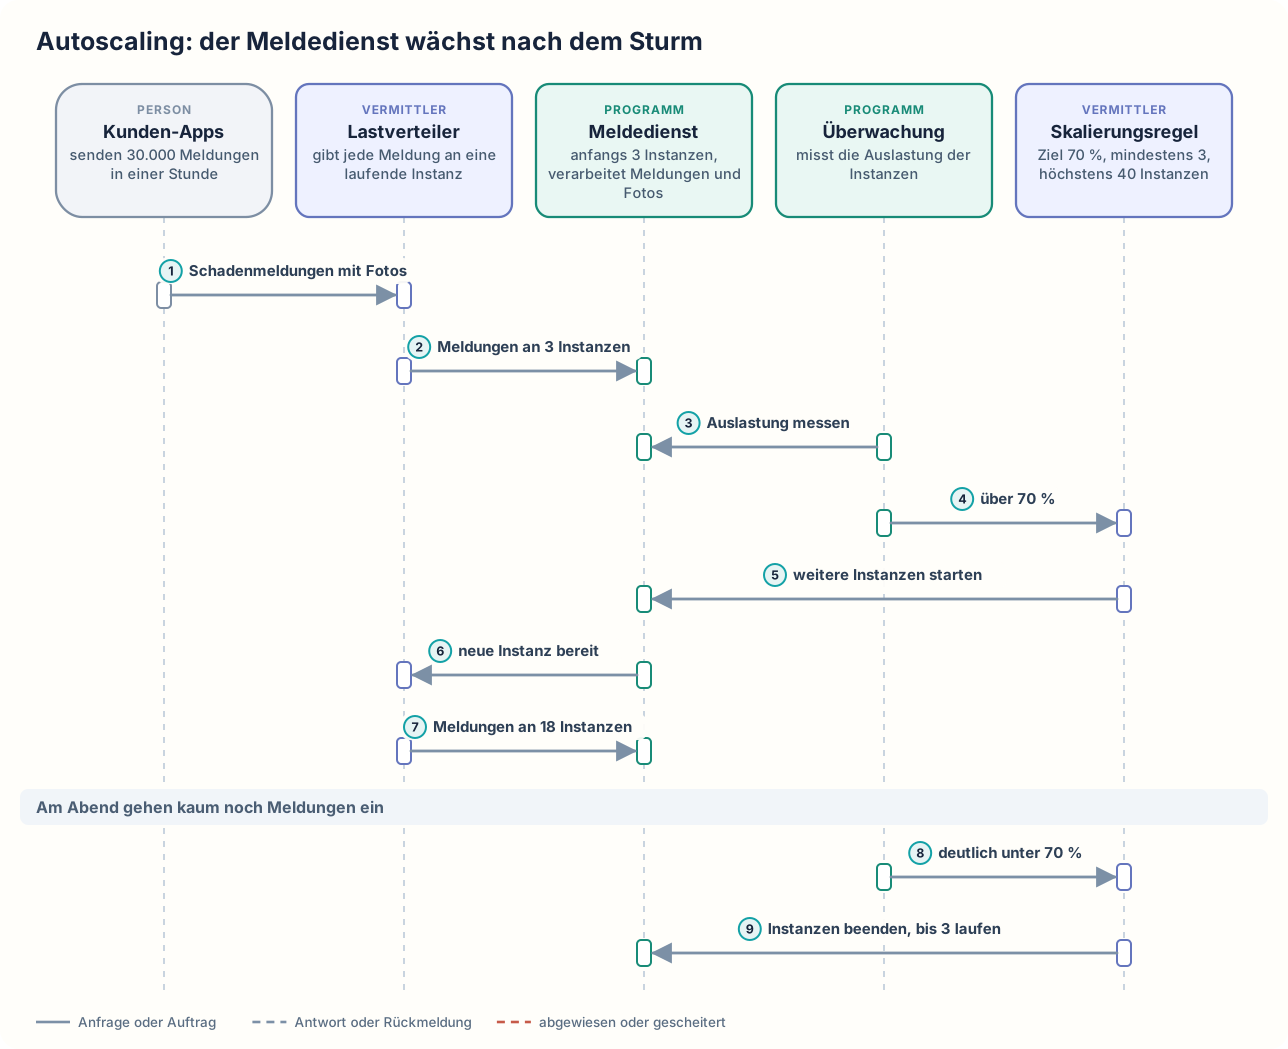
An einem Sonntagnachmittag senden die Kunden-Apps nach einem Sturm innerhalb einer Stunde 30.000 Schadenmeldungen mit Fotos. Jede Meldung geht zuerst an einen Lastverteiler, ein Programm, das die Meldung an eine der laufenden Instanzen des Meldedienstes weitergibt. Der Lastverteiler gibt die Meldungen zunächst an die drei laufenden Instanzen. Die Skalierungsregel ist auf einen Zielwert von 70 Prozent Auslastung eingestellt, mit mindestens drei und höchstens 40 Instanzen. Der Zielwert liegt unter 100 Prozent, damit Spielraum bleibt, bis neue Instanzen bereit sind. Die Untergrenze von drei Instanzen reicht für die Meldungen in ruhigen Stunden, und fällt eine Instanz aus, arbeiten die beiden anderen weiter. Die Obergrenze von 40 liegt etwa beim Doppelten dessen, was bei früheren Unwettern nötig war, und verhindert trotzdem, dass ein Fehler oder ein Angriff mit künstlich erzeugten Anfragen unbegrenzt Instanzen und damit Kosten erzeugt. Die „Überwachung“ misst laufend die Prozessorauslastung aller Instanzen. Schon nach wenigen Minuten meldet die „Überwachung“ der Skalierungsregel mehr als 70 Prozent. Die Skalierungsregel startet zusätzliche Instanzen und wartet dann eine Mindestzeit, bis die neuen Instanzen die Auslastung senken. Ohne diese Pause würde die Skalierungsregel immer weiter Instanzen starten oder ständig abwechselnd Instanzen starten und beenden. Sobald eine neue Instanz bereit ist, meldet sie sich beim Lastverteiler an. Danach gibt der Lastverteiler auch dieser Instanz Meldungen. Solange die „Überwachung“ mehr als 70 Prozent meldet, startet die Skalierungsregel noch mehr Instanzen. Nach etwa einer halben Stunde verteilt der Lastverteiler die Meldungen auf 18 Instanzen. Die Zahl 18 ist kein fester Wert, sondern das Ergebnis dieses einen Tages. Wie viele Instanzen nötig sind, hängt davon ab, wie viele Meldungen eingehen und wie viel Rechenarbeit eine einzelne Meldung verursacht. Rechenarbeit entsteht zum Beispiel beim Verkleinern der Fotos. Am Abend gehen kaum noch Meldungen ein, und die „Überwachung“ misst deutlich weniger als 70 Prozent. Die Skalierungsregel beendet nach und nach Instanzen, aber nie unter die Untergrenze von drei.
Der Meldedienst kann gleichzeitig mehrfach auf verschiedenen Servern laufen, weil jede Instanz jede Meldung bearbeiten kann. Jede Instanz kann aber nur eine bestimmte Zahl von Meldungen gleichzeitig verarbeiten, weil ihr nur ein Teil eines Servers mit begrenzter Rechenleistung zur Verfügung steht. Der Meldedienst läuft in einer Umgebung, in der sich weitere Instanzen per Befehl starten und wieder beenden lassen, etwa in einer Cloud oder auf Kubernetes, einer Plattform, die Programme auf vielen Servern betreibt. In einer solchen Umgebung wird meist nach genutzter Rechenleistung bezahlt. Für Autoscaling kommen zu Meldedienst und Lastverteiler zwei Bausteine hinzu: Die „Überwachung“ misst eine Kennzahl der Instanzen, und die Skalierungsregel vergleicht den Messwert mit dem Zielwert und entscheidet, ob Instanzen gestartet oder beendet werden. Als Kennzahl eignen sich die durchschnittliche Prozessorauslastung aller Instanzen, die Zahl der Anfragen pro Sekunde oder die Zahl der Meldungen, die noch auf Bearbeitung warten. Neben der Regel, die auf Messwerte reagiert, gibt es geplante Anpassungen und Verfahren, die aus dem Verlauf früherer Tage die Last vorhersagen. Eine geplante Anpassung ist zum Beispiel „werktags ab 7 Uhr mindestens acht Instanzen“, falls werktags ab 7 Uhr regelmäßig mehr Meldungen eingehen, als drei Instanzen bewältigen. Autoscaling verändert nur die Zahl der Instanzen des Meldedienstes.
Bevor die Skalierungsregel eine Instanz beendet, darf der Lastverteiler dieser Instanz keine neuen Meldungen mehr geben. Meldungen, die die Instanz gerade verarbeitet, muss sie noch zu Ende bringen. Wird eine neue Instanz nicht bereit, meldet sie sich nicht beim Lastverteiler an und erhält deshalb keine Meldungen.
Autoscaling: der Meldedienst wächst nach dem Sturm
Wann ist es sinnvoll und wann nicht?
Autoscaling lohnt sich
- Die Last schwankt deutlich: Nachts kommen wenige Meldungen, tagsüber mehr, nach einem Unwetter ein Vielfaches. Hält die Versicherung dauerhaft so viele Instanzen bereit, wie die größte Spitze braucht, bezahlt sie die meiste Zeit Rechenleistung, die niemand nutzt. Hält sie zu wenige bereit, werden die Antworten in der Spitze langsam oder Meldungen scheitern, und verärgerte Kunden rufen stattdessen an.
- Lastspitzen kommen unangekündigt, etwa nach einem Unwetter in der Nacht oder am Wochenende. Von Hand nachzusteuern ist zu langsam, weil jemand die Spitze erst bemerken, entscheiden und handeln müsste. Die Skalierungsregel startet neue Instanzen dagegen schon wenige Minuten nach Beginn der Spitze, auch nachts.
- Das Programm kann als mehrere gleichartige Instanzen nebeneinander laufen, ist wenige Sekunden nach dem Start bereit und hält zwischen zwei Anfragen keine Daten, die nur in einer Instanz liegen, etwa die ersten Fotos einer Schadenmeldung, die der Kunde noch nicht abgeschickt hat. Dann kann jede neue Instanz sofort jede Anfrage übernehmen. Auch Programme, die solche Daten lokal halten, lassen sich mit Autoscaling betreiben, brauchen dafür aber zusätzliche Regeln, etwa wohin die Daten einer beendeten Instanz gehen.
Autoscaling ist nicht das Richtige
- Eine Instanz braucht mehrere Minuten zum Start, und die Lastspitzen dauern nur wenige Minuten. Neue Instanzen wären erst bereit, wenn die Spitze schon vorbei ist. Dann hält die Versicherung dauerhaft so viele Instanzen bereit, wie eine solche Spitze braucht. Die Versicherung bezahlt diese Instanzen auch in ruhigen Stunden, aber in der Spitze scheitern keine Meldungen.
- Die Ursache der langen Antwortzeiten ist die Datenbank. Dann beseitigt die Versicherung den Engpass an der Datenbank selbst, etwa mit einem Datenbankserver mit mehr Prozessoren. Zusätzliche Instanzen des Meldedienstes, die der Datenbank nur noch mehr Anfragen schicken würden, bezahlt die Versicherung dann nicht.
- Die Last ist über den ganzen Tag annähernd gleich oder vorhersehbar. Vorhersehbar ist sie etwa, wenn die Spitze immer werktags zwischen 7 und 18 Uhr liegt. Eine Skalierungsregel würde dann erst bei steigender Auslastung Instanzen starten, obwohl die Versicherung den Zeitpunkt schon im Voraus kennt. Stattdessen stellt die Versicherung nur geplante Anpassungen ein oder betreibt eine feste Zahl von Instanzen, die für die übliche Spitze reicht. Bei einer über den Tag annähernd gleichen Last bezahlt die Versicherung mit der festen Zahl kaum Rechenleistung, die niemand nutzt. Eine Skalierungsregel, die eingestellt und mit echten Lastverläufen erprobt werden muss, entfällt.
- Meldungen müssen nicht sofort verarbeitet werden. Dann kann eine Warteschlange die Spitze aufnehmen: Die Kunden-Apps legen ihre Meldungen in der Warteschlange ab, und eine feste Zahl von Instanzen arbeitet die Meldungen nach dem Muster Competing Consumers nach und nach ab. Die Kunden-Apps erhalten dann sofort eine Eingangsbestätigung, die Bearbeitung der Meldungen dauert in der Spitze aber länger. Eine Skalierungsregel und zusätzliche Instanzen braucht die Versicherung dann nicht.
- Die zusätzliche Last kommt nicht von echten Schadenmeldungen, sondern zum Beispiel von einer fehlerhaften Kunden-App, die dieselbe Meldung ständig neu schickt. Die Skalierungsregel würde dann Instanzen für Anfragen starten, die die Versicherung gar nicht bearbeiten will. Stattdessen setzt die Versicherung Rate Limiting ein. Jede Anfrage geht dann zuerst an ein Programm, das zählt, wie viele Anfragen jede Kunden-App je Minute schickt. Anfragen über einer festgelegten Zahl weist dieses Programm ab, die übrigen gibt es an den Meldedienst weiter. Die Versicherung bezahlt dann keine zusätzlichen Instanzen für diese Anfragen.
Nachteile und typische Fehler
Die Skalierungsregel muss eingestellt und mit echten Lastverläufen erprobt werden. Zielwert, Mindestzeit, Untergrenze, Obergrenze und Kennzahl hängen davon ab, wie viel Rechenarbeit eine einzelne Meldung verursacht und wie schnell eine Instanz startet. Jede neue Instanz muss sich selbstständig beim Lastverteiler anmelden und beim Beenden laufende Meldungen zu Ende bringen; das erfordert Arbeit am Meldedienst selbst. Mehr Instanzen belasten nachgelagerte Systeme stärker, etwa die Datenbank oder einen externen Dienst. Wachsen diese Systeme nicht mit, muss man ihre Grenzen kennen und bei der Obergrenze berücksichtigen. Ist die Rechenleistung aller verfügbaren Server ausgeschöpft, hilft auch eine höhere Obergrenze nicht. Häufig braucht es deshalb ein zweites automatisches Verfahren, das weitere Server hinzufügt, und bis diese Server gestartet sind, vergeht zusätzlich Zeit.
Typische Fehler und woran man sie erkennt:
- Zu träge Regel: Die Mindestzeit ist zu lang oder der Zielwert zu hoch, etwa 95 statt 70 Prozent. Die Skalierungsregel startet neue Instanzen dann erst, wenn die vorhandenen Instanzen schon fast ihre ganze Rechenleistung brauchen. Bis die neuen Instanzen bereit sind, verarbeiten die vorhandenen Instanzen die eingehenden Meldungen nur langsam. Erkennbar ist das an langen Antwortzeiten und gescheiterten Meldungen in den ersten Minuten jeder Spitze.
- Ständiges Hin und Her: Eine Skalierungsregel mit zu kurzer Mindestzeit startet und beendet ständig Instanzen. Das verbraucht selbst Rechenleistung und stört laufende Arbeit. Erkennbar ist das an einer Zahl von Instanzen, die im Abstand weniger Minuten steigt und fällt, obwohl die Zahl der Meldungen gleich bleibt.
- Wandernder Engpass: Bei 18 statt drei Instanzen schickt der Meldedienst der Datenbank bis zu sechsmal so viele Anfragen gleichzeitig. Wächst die Datenbank nicht mit, beantwortet sie die Anfragen immer langsamer. Für einen externen Dienst, den der Meldedienst aufruft, gilt dasselbe. Erkennbar ist das an steigenden Antwortzeiten der Datenbank, während die Auslastung der Instanzen niedrig bleibt.
- Fehlende Obergrenze: Ein Programmfehler in den Kunden-Apps oder ein Angreifer schickt dem Meldedienst massenhaft künstliche Anfragen. Die „Überwachung“ meldet der Skalierungsregel eine hohe Auslastung, und die Skalierungsregel startet ohne Grenze immer mehr Instanzen. Erkennbar ist das an ungewöhnlich vielen Instanzen und hohen Kosten, ohne dass entsprechend viele echte Schadenmeldungen eingehen.
- Abgebrochene Meldungen beim Beenden: Die Skalierungsregel beendet eine Instanz, während die Instanz noch Meldungen verarbeitet. Diese Meldungen gehen verloren oder müssen erneut gesendet werden. Erkennbar ist das an Fehlermeldungen in den Kunden-Apps, die zeitlich mit dem Beenden von Instanzen zusammenfallen.
Weiterführend
Verwandte Ansätze
- Vertical vs Horizontal Scaling: unterscheidet zwischen einem größeren Server und mehr Servern; Autoscaling nutzt meist die zweite Möglichkeit, also mehr Instanzen.
- Stateless Services: Programme, die zwischen Anfragen nichts lokal speichern und sich deshalb ohne zusätzliche Regeln automatisch starten und beenden lassen.
- Load Balancing: beschreibt den Lastverteiler, der die Anfragen auf die Instanzen aufteilt.
Werkzeuge und Umsetzungen
- Kubernetes Horizontal Pod Autoscaler: Baustein von Kubernetes. Der Horizontal Pod Autoscaler passt die Zahl der Instanzen anhand der Prozessorauslastung oder eigener Kennzahlen an.
- KEDA: Erweiterung für Kubernetes, die Instanzen nach Kennzahlen wie der Länge einer Warteschlange startet und beendet, auch bis auf null Instanzen, wenn gerade keine Arbeit anliegt.
- Kubernetes Cluster Autoscaler: fügt dem Verbund von Servern, auf dem Kubernetes läuft, weitere Server hinzu, wenn neue Instanzen keinen Platz mehr finden, und entfernt ungenutzte Server wieder.
- Karpenter: stellt für Kubernetes neue Server bereit, deren Größe zu den wartenden Instanzen passt. Karpenter arbeitet mit bestimmten Cloud-Anbietern zusammen.
Quellen
- Kubernetes: Horizontal Pod Autoscaling: offizielle Beschreibung, wie der Horizontal Pod Autoscaler misst, rechnet und mit Wartezeiten ein ständiges Hin und Her vermeidet.
- Microsoft: Autoscaling: Leitfaden im Azure Architecture Center zu Unter- und Obergrenzen, zum Zusammenspiel geplanter und messwertbasierter Anpassungen und zum Abstand zwischen den Schwellen für Starten und Beenden, der ständiges Hin und Her verhindert.