
Observability
Den inneren Zustand aus den Ausgaben erkennen
Die Idee und ihr Nutzen
Kunden einer Versicherung melden, dass das Formular für Schadenmeldungen im Kundenportal nachmittags manchmal hängt. Eine Anzeige „Server läuft“ erklärt nicht, woran das liegt. Deshalb schreibt jedes beteiligte Programm während der Arbeit so viele aussagekräftige Angaben über sich selbst auf, dass das Betriebsteam der Versicherung später auch Fragen beantworten kann, an die vorher niemand gedacht hat, etwa warum das Formular nur nachmittags hängt. Dazu gehören Messwerte wie Antwortzeiten, Protokolleinträge mit konkreten Fehlermeldungen und Aufrufspuren, also Aufzeichnungen darüber, welche Programme eine einzelne Anfrage nacheinander durchlaufen hat. Mit diesen Angaben findet das Betriebsteam heraus, dass die Verzögerung beim Abruf von Adressen bei einem externen Adressdienst entsteht. Diese Eigenschaft eines Systems heißt Observability, auf Deutsch etwa Beobachtbarkeit.

Wie funktioniert es?
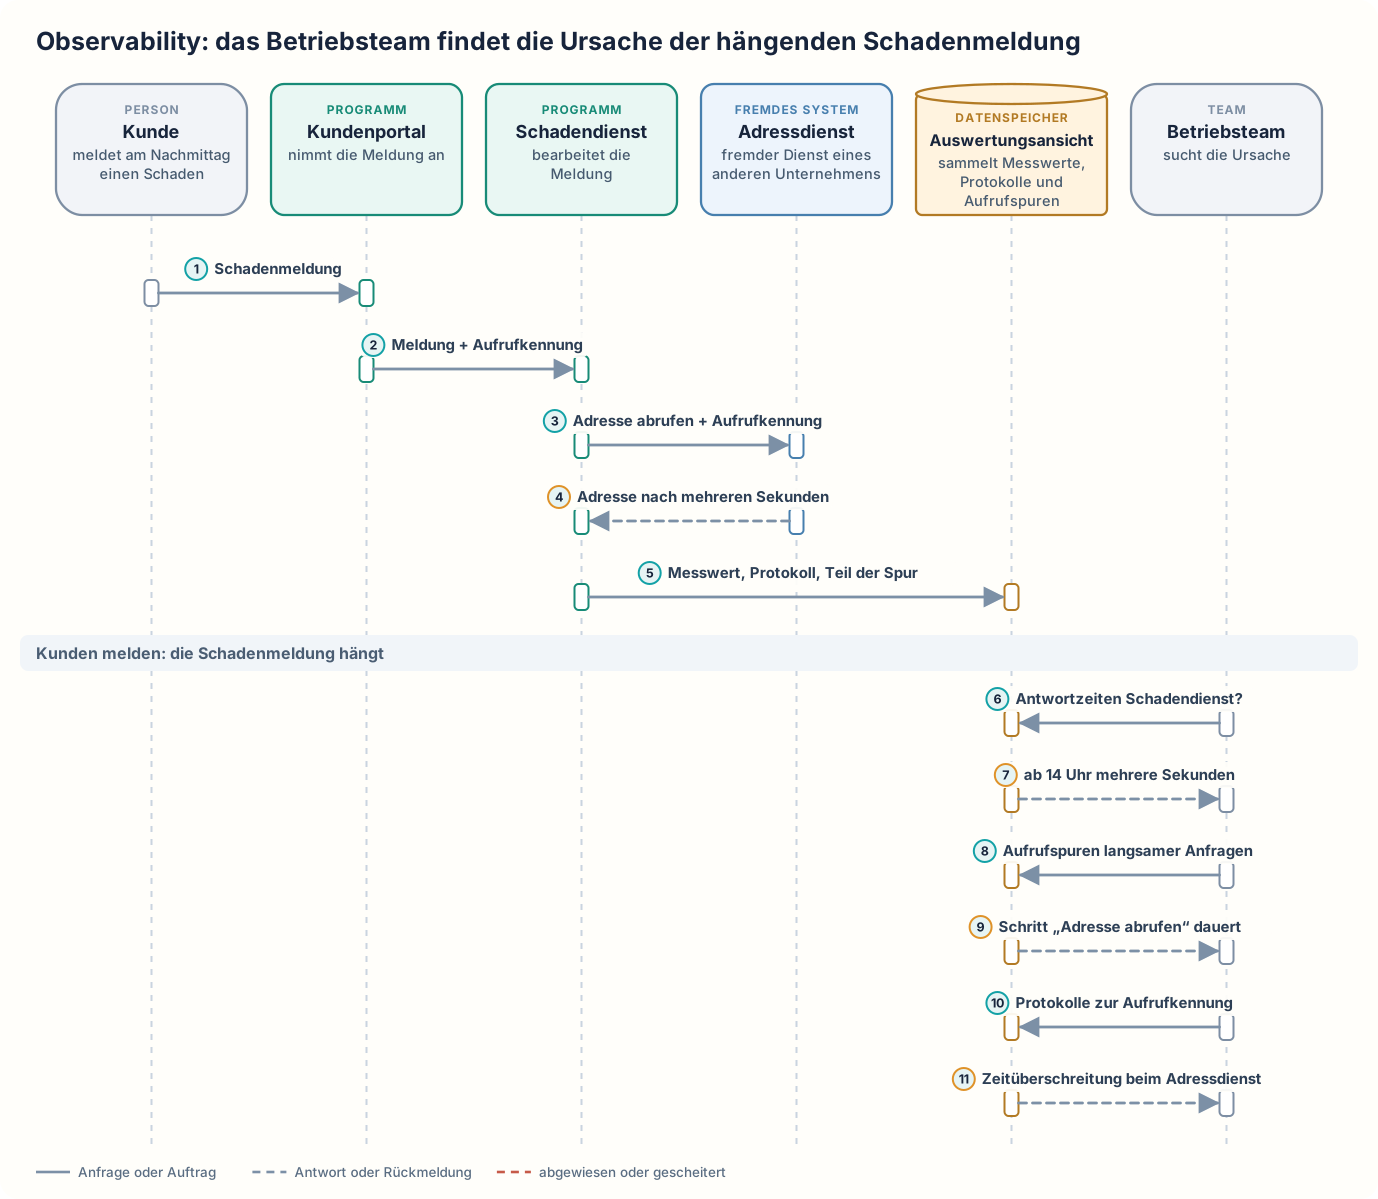
An einem Dienstagnachmittag meldet ein Kunde im Kundenportal einen Schaden. Das Kundenportal gibt der Anfrage eine eindeutige Aufrufkennung, eine Zeichenfolge wie 7f3a91, die nur diese eine Anfrage trägt. Danach ruft das Kundenportal den Schadendienst auf, der die Meldung bearbeitet, und reicht die Aufrufkennung mit. Der Schadendienst fragt mit derselben Aufrufkennung beim externen Adressdienst nach der Adresse des Kunden. Den Adressdienst betreibt ein anderes Unternehmen. Ab 14 Uhr antwortet der Adressdienst erst nach mehreren Sekunden oder gar nicht. Kundenportal und Schadendienst schreiben währenddessen Messwerte, ihren Teil der Aufrufspur und Protokolleinträge mit benannten Feldern wie Meldungsnummer und Fehlerart in die Auswertungsansicht, ein Werkzeug, das die Angaben speichert und durchsuchbar anzeigt. Nachdem Kunden gemeldet haben, dass das Formular hängt, öffnet das Betriebsteam die Auswertungsansicht. Die Messwerte des Schadendienstes zeigen, dass die Antwortzeiten vorher unter einer Sekunde lagen und ab 14 Uhr mehrere Sekunden betragen. Das Betriebsteam sucht deshalb gezielt nach Aufrufspuren langsamer Anfragen ab 14 Uhr, statt alle Anfragen des Tages zu durchsuchen. Mehrere dieser Aufrufspuren zeigen dasselbe Bild: Kundenportal und Schadendienst arbeiten so schnell wie vor 14 Uhr, aber der Abruf der Adresse beim Adressdienst dauert mehrere Sekunden. Mit der Aufrufkennung einer dieser Anfragen sucht das Betriebsteam in den Protokollen und findet Einträge des Schadendienstes mit Zeitüberschreitungen beim Adressdienst. Warum der Adressdienst langsam ist, klärt das Betriebsteam mit dem Betreiber des Adressdienstes.
Die Programme schreiben drei Arten von Angaben auf:
- Messwerte (Metrics): Zahlen, die das Programm in regelmäßigen Abständen festhält. Beispiele sind die Zahl der Anfragen pro Sekunde, die Zahl der fehlgeschlagenen Anfragen und die Dauer der Antworten. Über die Zeit aufgetragen ergeben die Messwerte Kurven, an denen das Betriebsteam erkennt, ab wann sich etwas verändert hat.
- Protokolle (Logs): einzelne Einträge über bestimmte Ereignisse mit Zeitpunkt und Einzelheiten. Ein Beispiel ist der Eintrag „Zeitüberschreitung beim Abruf der Adresse für Schadenmeldung 4711 nach 5 Sekunden“. Länger wartet der Schadendienst nicht, weil der Adressdienst sonst in Bruchteilen einer Sekunde antwortet und eine so späte Antwort meist gar nicht mehr kommt. Protokolle sind am nützlichsten, wenn jede Angabe in einem benannten Feld steht, zum Beispiel Zeitpunkt, Meldungsnummer und Fehlerart. Dann kann das Betriebsteam gezielt nach allen Einträgen mit derselben Meldungsnummer suchen.
- Aufrufspuren (Traces): eine Aufzeichnung für eine einzelne Anfrage, die zeigt, welche Programme die Anfrage nacheinander durchlaufen hat und wie lange jeder Schritt gedauert hat. Möglich ist das nur, weil jedes Programm die Aufrufkennung beim Weiterreichen der Anfrage mitgibt.
In der Auswertungsansicht kann das Betriebsteam die drei Arten nebeneinander betrachten. Die Zuordnung zwischen den drei Arten entsteht aber nicht von selbst. Protokolleinträge lassen sich einer Aufrufspur nur zuordnen, wenn die Programme die Aufrufkennung in jeden Protokolleintrag mitschreiben. Messwerte enthalten meist keine Aufrufkennung. Das Betriebsteam ordnet Messwerte und Aufrufspuren deshalb über die Uhrzeit einander zu.
Kundenportal und Schadendienst betreibt die Versicherung selbst. Aufzeichnen kann die Versicherung nur Angaben aus diesen eigenen Programmen; was im Adressdienst geschieht, sieht sie nicht. Observability behebt keine Störung, sondern zeigt, in welchem Programm oder bei welchem Aufruf eine Verzögerung entsteht.
Zusätzlich kann das Betriebsteam ein messbares Ziel festlegen, zum Beispiel: 99 von 100 Schadenmeldungen sollen innerhalb von zwei Sekunden angenommen sein. Zwei Sekunden lassen Spielraum über die übliche Antwortzeit von unter einer Sekunde hinaus. 100 von 100 wären kein sinnvolles Ziel, weil einzelne Anfragen auch bei gutem Betrieb an Störungen im Netz scheitern. Dafür muss das Betriebsteam genau bestimmen, welcher Bearbeitungsschritt als „angenommen“ zählt und über welchen Zeitraum es den Anteil berechnet. Erst dann lässt sich an den Messwerten ablesen, ob das Ziel erreicht wird.
Observability: das Betriebsteam findet die Ursache der hängenden Schadenmeldung
Wann ist es sinnvoll und wann nicht?
Observability lohnt sich
- Ein System besteht aus mehreren Programmen, die auf verschiedenen Servern laufen und sich über das Netz gegenseitig aufrufen. Eine Verzögerung kann in jedem dieser Programme entstehen. Ohne Observability sieht das Betriebsteam nur, dass das Kundenportal langsam antwortet. Erst eine Aufrufspur zeigt, in welchem Programm die Zeit vergeht.
- Mehrere Teams betreiben Programme, die voneinander abhängen, etwa ein Team das Kundenportal und ein anderes Team den Schadendienst. Ohne gemeinsame Aufrufspuren sieht das Team des Kundenportals nur, dass die Antworten des Schadendienstes lange dauern, und das Team des Schadendienstes findet in seinem Programm keinen Fehler. Mit gemeinsamen Aufrufspuren sehen beide Teams, dass die Wartezeit beim Abruf der Adresse im Adressdienst entsteht.
- Störungen betreffen nur einen Teil der Anfragen. Einzelne Kunden warten lange, manche Meldungen brechen ab, und das Problem tritt nur zu bestimmten Tageszeiten auf. Ohne Angaben zu einzelnen Anfragen sieht das Betriebsteam nicht, welche Anfragen betroffen sind und was sie gemeinsam haben. Mit den Aufrufspuren der langsamen Anfragen ab 14 Uhr erkennt das Betriebsteam, dass alle beim Abruf der Adresse warten.
- Vorher festgelegte Prüfungen zeigen nichts Auffälliges. Klassische Überwachung prüft nur Werte, die das Betriebsteam vorher festgelegt hat. Ein Beispiel ist die Prüfung, ob ein Server eingeschaltet oder die Festplatte voll ist. Alle diese Prüfungen können ein gutes Ergebnis zeigen, während Kunden trotzdem warten. Mit den aufgezeichneten Angaben findet das Betriebsteam den langsamen Abruf beim Adressdienst, ohne vorher eine Prüfung für genau diese Störung eingerichtet zu haben.
- Das Betriebsteam muss dem Betreiber eines fremden Programms konkrete Fälle nennen können. Ohne aufgezeichnete Angaben kann das Betriebsteam dem Betreiber des Adressdienstes nur sagen, dass das Formular nachmittags hängt, und der Betreiber kann die Ursache damit nicht eingrenzen. Mit Observability nennt das Betriebsteam die Protokolleinträge mit Zeitpunkt und Zeitüberschreitung beim Adressdienst.
Observability ist nicht das Richtige
- Das System besteht aus einem einzigen Programm. Jede Anfrage durchläuft dann nur dieses Programm, und alle Protokolleinträge zu einer Anfrage stammen aus diesem Programm. Eine Aufrufspur, die Angaben mehrerer Programme zu einer Anfrage verbindet, hätte nichts zu verbinden. Das Programm schreibt deshalb nur Protokolleinträge und wenige Messwerte auf, in denen das Betriebsteam nach der Ursache einer Störung sucht. Das Team, das das Programm entwickelt, muss keine Weitergabe einer Aufrufkennung einbauen, und niemand muss Aufrufspuren speichern.
- Die Störungen eines Programms sind bekannt, etwa dass das Programm abstürzt oder dass die Festplatte seines Servers voll ist. Für solche Störungen braucht das Betriebsteam keine Angaben zu jeder einzelnen Anfrage, mit denen es nach unerwarteten Ursachen suchen könnte. Das Betriebsteam richtet stattdessen feste Prüfungen ein, etwa Health Checks, also regelmäßige Prüfanfragen eines Überwachungsprogramms, auf die das Programm antwortet, ob es arbeitet. Gespeichert werden nur die Ergebnisse dieser Prüfungen. Das spart den Speicher für Angaben zu jeder Anfrage, und das Programm muss weder Aufrufspuren schreiben noch eine Aufrufkennung weitergeben. Eine unerwartete Störung wie den langsamen Adressdienst finden feste Prüfungen nicht. Deshalb lassen sich beide verbinden: Die festen Prüfungen schlagen bei bekannten Störungen Alarm, die aufgezeichneten Angaben helfen bei der Suche nach unerwarteten Ursachen.
Nachteile und typische Fehler
Bei jeder Anfrage entstehen Messwerte, Protokolleinträge und ein Teil einer Aufrufspur; bei vielen Anfragen ergibt das große Mengen. Speichern und Auswerten kostet Geld, deshalb muss das Betriebsteam entscheiden, was es wie lange aufbewahrt und ob es nur einen Teil der Aufrufspuren aufzeichnet. Jedes Programm muss so erweitert werden, dass es die drei Arten von Angaben schreibt und die Aufrufkennung weitergibt. Betreuen verschiedene Teams die Programme, etwa ein Team das Kundenportal und ein anderes Team den Schadendienst, müssen sich beide Teams auf dieselben Kennungen und Feldnamen einigen. Die Auswertungsansicht mit ihren Speichern ist außerdem ein eigenes System, das betrieben werden muss.
Typische Fehler und woran man sie erkennt:
- Unverbundene Angaben: Der Schadendienst übernimmt die Aufrufkennung des Kundenportals nicht, sondern vergibt eine eigene Kennung, oder er schreibt die Aufrufkennung unter einem anderen Feldnamen in seine Protokolleinträge. Die Auswertungsansicht kann die Angaben des Schadendienstes dann nicht der Anfrage des Kundenportals zuordnen. Erkennbar ist das an Aufrufspuren, die nach dem Kundenportal abbrechen, oder an Protokollsuchen mit einer Aufrufkennung, die nur Einträge eines einzigen Programms finden.
- Vertrauliche Angaben im Protokoll: Der Schadendienst schreibt bei einer Zeitüberschreitung die ganze Schadenmeldung in den Protokolleintrag, mit Name, Adresse und Kontonummer des Kunden. Diese Angaben landen so in der Auswertungsansicht, obwohl sie dort nicht gespeichert werden dürfen. Erkennbar ist das an Kundenadressen, die bei einer Stichprobe in Protokolleinträgen auftauchen.
- Zu viele Warnmeldungen: Das Betriebsteam lässt die Auswertungsansicht eine Warnmeldung verschicken, sobald eine einzelne Anfrage länger als eine Sekunde dauert. Eine kurze Störung im Netz verlangsamt zwei Minuten lang jede Anfrage. Bei 50 Schadenmeldungen pro Minute verschickt die Auswertungsansicht dann 100 Warnmeldungen. Das Betriebsteam gewöhnt sich an solche Mengen und übersieht die Warnmeldungen, als ab 14 Uhr der Adressdienst langsam antwortet. Erkennbar ist das an Warnmeldungen, die niemand bestätigt oder bearbeitet.
- Fehlende langsame Aufrufspuren: Das Betriebsteam hat eingestellt, dass nur eine von hundert zufällig gewählten Anfragen eine Aufrufspur bekommt. Sind von 1.000 Anfragen nur 20 langsam, wird im Durchschnitt nicht einmal eine dieser 20 langsamen Anfragen aufgezeichnet. Erkennbar ist das an einem Zeitraum, in dem die Messwerte steigende Antwortzeiten zeigen, ohne dass sich eine einzige langsame Aufrufspur findet.
Weiterführend
Verwandte Ansätze
- Distributed Tracing: beschreibt im Einzelnen, wie Aufrufspuren über mehrere Programme hinweg entstehen.
- Correlation Identifier: die gemeinsame Kennung, mit der sich Angaben verschiedener Programme zu einer Anfrage verbinden lassen.
- Audit Logging: Nachweise über fachliche Vorgänge, etwa wer eine Zahlung freigegeben hat, getrennt von den technischen Protokollen.
Werkzeuge und Umsetzungen
- OpenTelemetry: Standard und Bibliotheken, mit denen Programme Messwerte, Protokolle und Aufrufspuren einheitlich erzeugen und weitergeben.
- Prometheus: sammelt und speichert Messwerte und kann Warnmeldungen auslösen.
- Grafana: zeigt Messwerte, Protokolle und Aufrufspuren gemeinsam in Auswertungsansichten an.
- Grafana Loki und OpenSearch: speichern und durchsuchen Protokolle.
- Jaeger: sammelt Aufrufspuren und zeigt sie an.
Quellen
- OpenTelemetry: Observability primer: erklärt Observability als Fähigkeit, ein System von außen zu befragen, ohne sein Inneres zu kennen, und beschreibt Messwerte, Protokolle, Aufrufspuren sowie messbare Ziele für die Zuverlässigkeit.
- Chris Jones, John Wilkes, Niall Murphy, Cody Smith: Service Level Objectives: Kapitel aus dem Buch „Site Reliability Engineering“ von Google, das messbare Ziele wie „99 Prozent der Anfragen in weniger als 100 Millisekunden“ mit Messzeitraum und Kennzahl genau festlegt.