
Distributed Tracing
Einen Aufruf durch alle Dienste verfolgen
Die Idee und ihr Nutzen
Ein Kunde öffnet im Kundenportal seiner Versicherung die Seite zu seinem Schaden, und die Seite braucht plötzlich acht Sekunden statt einer. Die Anfrage durchläuft auf dem Weg mehrere Programme verschiedener Teams, doch jedes Team sieht nur die Messwerte seines eigenen Programms, etwa die mittlere Antwortzeit, und findet dort nichts Auffälliges. Damit sich die Wartezeit trotzdem finden lässt, gibt das erste Programm, das die Anfrage annimmt, ihr eine Kennung, etwa „abc“, und jedes weitere Programm reicht diese Kennung mit der Anfrage weiter. Jedes Programm meldet mit dieser Kennung, wann es mit seinem Teil begonnen und wie lange es gebraucht hat. Ein Sammelprogramm setzt aus diesen Meldungen eine Zeitleiste zusammen, die zeigt, in welchem Programm die Wartezeit entsteht. Dieses Vorgehen heißt Distributed Tracing, auf Deutsch verteilte Ablaufverfolgung: Verfolgt wird der Ablauf einer Anfrage, die auf mehrere Programme verteilt bearbeitet wird.

Wie funktioniert es?
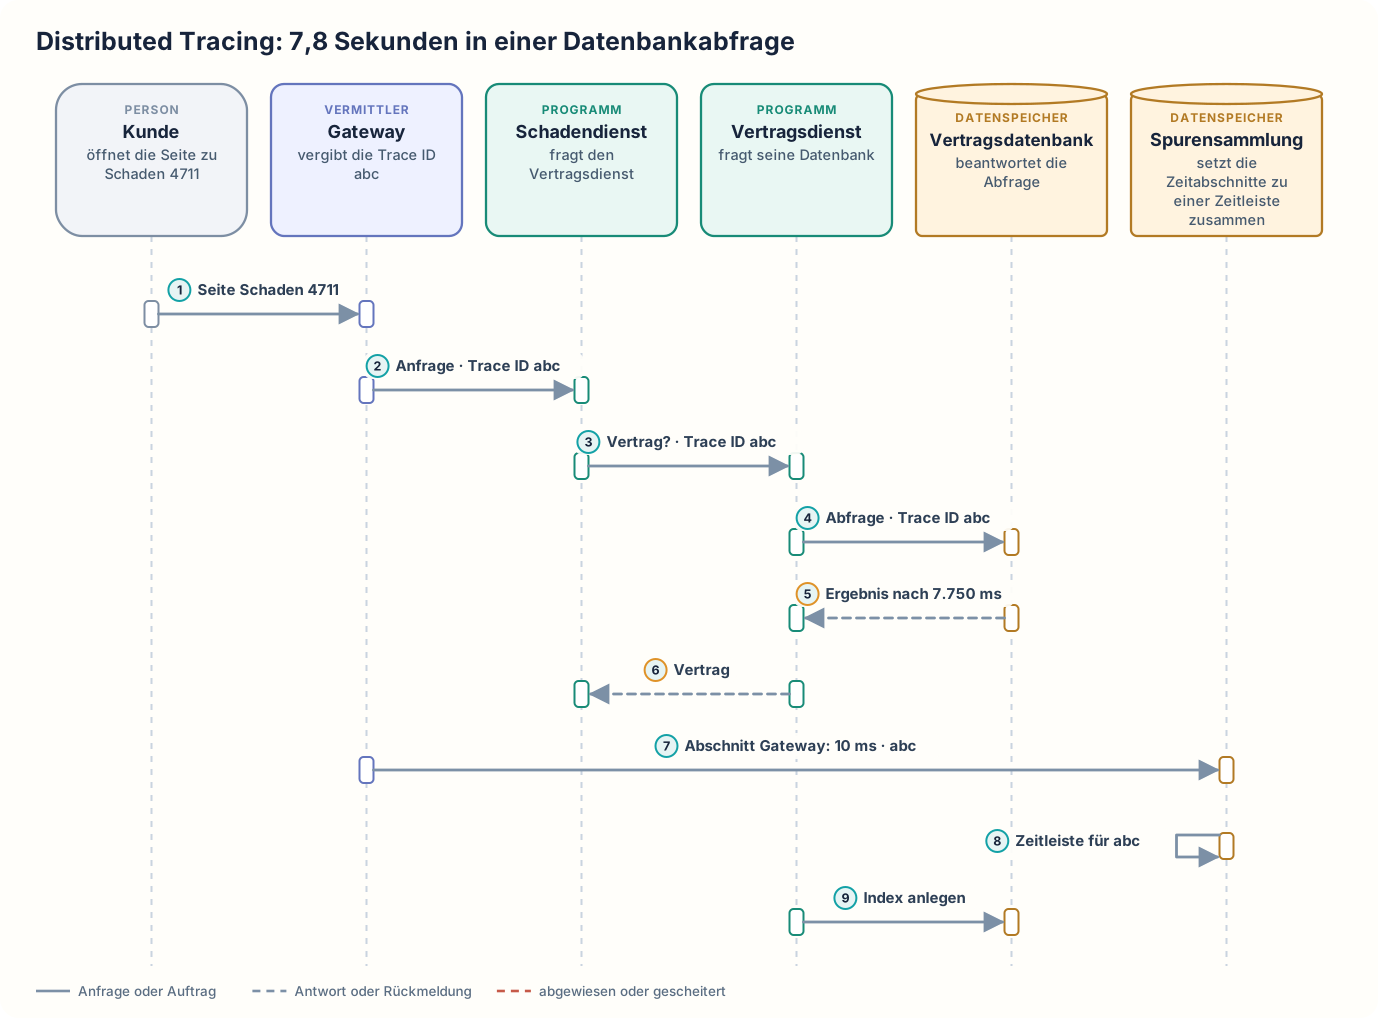
Ein Kunde öffnet im Kundenportal die Seite zu Schaden 4711, und die Seite lädt sehr langsam. Die Anfrage geht zuerst an das Gateway, das alle Anfragen von außen annimmt und weiterleitet. Das Gateway vergibt eine Kennung für die Anfrage, die Trace ID, hier vereinfacht „abc“. Das Gateway gibt die Trace ID mit der Anfrage an den Schadendienst weiter, der die Schadendaten liefert. Der Schadendienst reicht die Trace ID abc an den Vertragsdienst weiter, der die Vertragsdaten liefert. Der Vertragsdienst stellt mit derselben Trace ID eine Abfrage an seine Datenbank, die Vertragsdatenbank. Die Vertragsdatenbank antwortet erst nach 7.750 Millisekunden, und der Vertragsdienst antwortet dem Schadendienst nach insgesamt 7.800 Millisekunden. Danach meldet jedes Programm mit der Trace ID abc an die Spurensammlung, ein gesondertes Sammelprogramm, wann seine Arbeit an der Anfrage begonnen und wie lange sie gedauert hat. Diese Meldung heißt Zeitabschnitt. Die Spurensammlung setzt daraus die Zeitleiste für abc zusammen: Das Gateway braucht 10 Millisekunden, der Schadendienst selbst 30 Millisekunden, der Vertragsdienst aber 7.800 Millisekunden. Davon dauert allein die Datenbankabfrage 7.750 Millisekunden. Damit ist klar, dass die Zeit in dieser einen Abfrage verloren geht. Warum die Abfrage so langsam ist, zeigt die Zeitleiste nicht. Das Team des Vertragsdienstes lässt sich von der Vertragsdatenbank anzeigen, wie sie die Abfrage ausführt, und stellt fest, dass ein Index fehlt. Ein Index ist ein zusätzliches Verzeichnis in der Datenbank, mit dem die Datenbank passende Zeilen schnell findet, statt die ganze Tabelle zu durchsuchen. Nach dem Anlegen des Index misst das Team des Vertragsdienstes erneut: Die Seite lädt wieder in unter einer Sekunde.
Das Kundenportal besteht aus mehreren Programmen, die verschiedene Teams betreiben und die einander über das Netz aufrufen. Jedes Team überwacht sein Programm mit Protokollen, also fortlaufend geschriebenen Einträgen darüber, was das Programm gerade tut, und mit Messwerten wie der mittleren Antwortzeit. Jedes Programm gibt die Trace ID bei jedem weiteren Aufruf und in jeder Nachricht mit. Für seinen Teil der Arbeit meldet jedes Programm einen Span, auf Deutsch Zeitabschnitt, an die Spurensammlung. Ein Span enthält:
- die Trace ID der Anfrage und eine eigene Kennung des Zeitabschnitts,
- die Kennung des Zeitabschnitts im aufrufenden Programm, damit sich die Abschnitte später in die richtige Aufrufreihenfolge bringen lassen,
- Beginn, Dauer und das Ergebnis „erfolgreich“ oder „Fehler“,
- Merkmale wie den Namen des Programms, die aufgerufene Adresse oder die ausgeführte Datenbankabfrage.
Die Spurensammlung setzt alle Zeitabschnitte mit derselben Trace ID zu einer Zeitleiste zusammen, der Spur der Anfrage. Auf der Spur sieht man, welches Programm wann welches andere aufgerufen hat und wie lange jeder Schritt gedauert hat.
Reicht ein Programm die Trace ID nicht weiter, beginnt beim nächsten aufgerufenen Programm eine neue, unverbundene Spur, und die Zeitleiste zeigt nur einen Teil der Anfrage. Alle Spuren vollständig zu speichern, braucht bei vielen Anfragen viel Speicherplatz. Deshalb behält man oft nur eine Stichprobe. Eine solche Stichprobe kann jede hundertste Spur sein. Weil gleichzeitig Tausende Anfragen laufen, bleiben auch dann genug Spuren, um ein dauerhaft langsames Programm zu erkennen. Soll die Stichprobe bevorzugt fehlerhafte oder langsame Anfragen enthalten, darf die Spurensammlung erst auswählen, wenn die Anfrage beendet ist. Entscheidet schon das Gateway beim Vergeben der Trace ID, eine Spur nicht zu behalten, lässt sich diese Spur nicht mehr zurückholen, wenn die Anfrage später scheitert.
Distributed Tracing: 7,8 Sekunden in einer Datenbankabfrage
Wann ist es sinnvoll und wann nicht?
Distributed Tracing lohnt sich
- Eine Anwendung besteht aus mehreren Programmen, und Anfragen durchlaufen viele dieser Programme. Jedes Programm schreibt eigene Protokolle, aber keines zeigt den ganzen Weg einer einzelnen Anfrage. Die Protokolle der Programme lassen sich nicht zuverlässig einander zuordnen, weil gleichzeitig Tausende andere Anfragen laufen.
- Mehrere Teams betreiben die beteiligten Programme, und jedes Team sieht nur die Messwerte seines eigenen Programms. Eine einzelne langsame Anfrage geht in Durchschnittswerten wie der mittleren Antwortzeit leicht unter. Ohne Zeitleiste meldet jedes Team „Bei uns sieht alles normal aus“, und mehrere Teams suchen stundenlang nach der Ursache. Mit der Zeitleiste sucht nur das Team des Vertragsdienstes. Die Teams von Gateway und Schadendienst können mit Messwerten belegen, dass ihr Teil nur 10 beziehungsweise 30 Millisekunden braucht.
- Ein Team sucht Engpässe, Fehlerursachen und unerwartete Abhängigkeiten zwischen Programmen. Die Spuren zeigen, welches Programm welches andere aufruft, auch wenn dieser Aufruf in keiner Beschreibung der Programme steht. Ohne Spuren erfährt ein Team von einer solchen Abhängigkeit oft erst, wenn das aufgerufene Programm ausfällt. Die Spur abc zeigt zum Beispiel, dass der Schadendienst für die Seite zu Schaden 4711 den Vertragsdienst aufruft und der Vertragsdienst die Vertragsdatenbank.
Distributed Tracing ist nicht das Richtige
- Die Anwendung ist ein einzelnes Programm. Die ganze Anfrage läuft dann in diesem einen Programm, und es gibt keine Kennung, die von Programm zu Programm weitergereicht werden müsste. Deshalb sucht das Entwicklungsteam die Wartezeit mit den Protokollen des Programms und einem Profiler. Ein Profiler ist ein Werkzeug, das misst, in welchen Programmteilen die Zeit verbraucht wird. Eine Spurensammlung, die betrieben und überwacht werden muss, entfällt.
- Fast die ganze Bearbeitung einer Anfrage geschieht in einem zugekauften Programm, das sich nicht anpassen lässt und die Trace ID nicht weiterreicht. Die Zeitleiste zeigt dann nur, wie lange der Aufruf dieses Programms dauert, aber nicht, wo darin die Zeit verloren geht. Diese Dauer misst das aufrufende Programm auch selbst als gewöhnlichen Messwert. Dann liest das Team des aufrufenden Programms die Dauer aus diesen Messwerten ab. Wo im zugekauften Programm die Zeit verloren geht, kann ohnehin nur dessen Hersteller untersuchen. Alle Programme für die Trace ID anzupassen und eine Spurensammlung zu betreiben, entfällt.
- Es genügt, die zusammengehörigen Protokolleinträge mehrerer Programme zu finden, und die Dauer jedes Schritts wird nicht gebraucht. Dann schreibt jedes Programm eine mitgereichte Kennung in seine Protokolleinträge, den Correlation Identifier, und die Teams suchen in den Protokollen aller Programme nach dieser Kennung. Die Spurensammlung und das Melden von Zeitabschnitten entfallen.
Nachteile und typische Fehler
Jedes Programm muss so angepasst werden, dass es die Trace ID weiterreicht und Zeitabschnitte meldet. Bei Programmen verschiedener Teams verlangt das eine Vereinbarung über ein gemeinsames Format für die Kennung. Die Spurensammlung ist ein weiteres Programm, das betrieben, gesichert und überwacht werden muss. Die gesammelten Daten sind umfangreich, und ohne Stichproben ist ihre Speicherung teuer. Fällt die Auswahl der Stichprobe erst nach dem Ende einer Anfrage, müssen alle Zeitabschnitte so lange zwischengespeichert werden. Vertrauliche Angaben in den Merkmalen müssen vor dem Speichern herausgefiltert werden.
Typische Fehler und woran man sie erkennt:
- Zerrissene Zeitleiste: Der Schadendienst ruft den Vertragsdienst ohne die Trace ID abc auf. Der Vertragsdienst vergibt dann eine neue Trace ID und meldet seine Zeitabschnitte unter dieser neuen Trace ID. Die Spur abc zeigt nur Gateway und Schadendienst, und die 7.800 Millisekunden des Vertragsdienstes stehen in einer zweiten, unverbundenen Spur. Erkennbar ist das an Spuren, die bei einem Programm enden, obwohl die Anfrage danach weiterlief.
- Fehlende Spur: Das Gateway wählt schon beim Vergeben der Trace ID jede hundertste Anfrage für die Stichprobe aus und gibt diese Entscheidung mit der Trace ID weiter. Für alle anderen Anfragen melden die Programme keine Zeitabschnitte. Eine einzelne langsame Anfrage, die man untersuchen will, fehlt so mit einer Wahrscheinlichkeit von 99 Prozent. Erkennbar ist das an gemeldeten langsamen Seiten, zu denen die Spurensammlung keine Spur hat.
- Vertrauliche Merkmale: Der Schadendienst meldet als Merkmal die aufgerufene Adresse des Vertragsdienstes, und in dieser Adresse steht die Kundennummer. Die Spurensammlung speichert das Merkmal ungefiltert. Erkennbar ist das an Kundennummern, die in der Anzeige der Spurensammlung lesbar sind.
- Unbegrenzte Datenmenge: Ohne Stichproben speichert die Spurensammlung jede Spur. Bei 1.000 Anfragen in der Sekunde und vier Zeitabschnitten je Anfrage sind das rund 350 Millionen Zeitabschnitte am Tag; mit einer Stichprobe jeder hundertsten Spur wären es rund 3,5 Millionen. Die Speicherkosten wachsen mit jeder Anfrage. Erkennbar ist das an einem Speicherbedarf, der im gleichen Maß steigt wie die Zahl der Anfragen.
Weiterführend
Verwandte Ansätze
- Observability: beschreibt, wie ein Team aus den Daten, die die Programme melden, erkennt, was in einem laufenden System geschieht. Ablaufspuren sind dafür neben Protokollen und Messwerten die dritte wichtige Datenart.
- Microservices: Bauweise mit vielen kleinen Diensten, in der eine Anfrage viele Dienste durchläuft und Ablaufverfolgung deshalb besonders wichtig ist.
- Service Mesh: Hilfsprogramme, an die jeder Dienst seine Aufrufe anderer Dienste zuerst schickt. Die Hilfsprogramme leiten jeden Aufruf an den aufgerufenen Dienst weiter und können dabei Zeitabschnitte melden, ohne dass der Code der Dienste geändert wird.
Werkzeuge und Umsetzungen
- OpenTelemetry: Standard mit Bibliotheken für viele Programmiersprachen, die Zeitabschnitte erzeugen und die Trace ID weiterreichen.
- Jaeger: sammelt und speichert Ablaufspuren und zeigt sie als Zeitleiste an.
- Zipkin: älteres System zum Sammeln und Anzeigen von Ablaufspuren.
- Grafana Tempo: Speicher für sehr große Mengen von Ablaufspuren, der ohne eigene Datenbank auskommt und die Ablaufspuren in einem Cloud-Speicher ablegt.
Quellen
- Benjamin H. Sigelman u. a.: Dapper, a Large-Scale Distributed Systems Tracing Infrastructure: Bericht von Google aus dem Jahr 2010 über das eigene System zur Ablaufverfolgung im Betrieb, das mit Stichproben arbeitet und dafür nur wenige gemeinsam genutzte Programmbibliotheken anpasst.
- W3C: Trace Context: Standard dafür, wie die Kennung einer Spur und die Kennung des aufrufenden Abschnitts bei Aufrufen über HTTP, das Übertragungsverfahren des Webs, von Programm zu Programm weitergegeben werden.
- OpenTelemetry: Sampling: erklärt Stichproben, die am Anfang einer Anfrage gezogen werden, und Stichproben, die erst nach Betrachtung der ganzen Spur entscheiden und deshalb fehlerhafte Anfragen gezielt behalten können.