
Disaster Recovery (RPO und RTO)
Wiederanlauf nach dem Verlust eines Standorts
Die Idee und ihr Nutzen
Ein Brand legt das Rechenzentrum einer Versicherung am Standort A lahm, mit allen Servern, die dort stehen, auch den Ersatzservern. Das Schadensystem, mit dem Kunden ihre Schäden melden, soll trotzdem nach wenigen Stunden an einem zweiten Standort B wieder laufen. Dafür legt die Versicherung je System zwei Zielwerte fest: wie lange die Unterbrechung höchstens dauern darf und wie viele der zuletzt eingegebenen Daten höchstens verloren gehen dürfen. Für das Schadensystem sind das vier Stunden und die Eingaben der letzten 15 Minuten. Nach diesen Zielwerten richtet die Versicherung den zweiten Standort ein, plant den Wiederanlauf und übt ihn. Diese Vorbereitung auf den Wiederanlauf an einem anderen Ort heißt Disaster Recovery, auf Deutsch Wiederherstellung nach einer Katastrophe.

Wie funktioniert es?
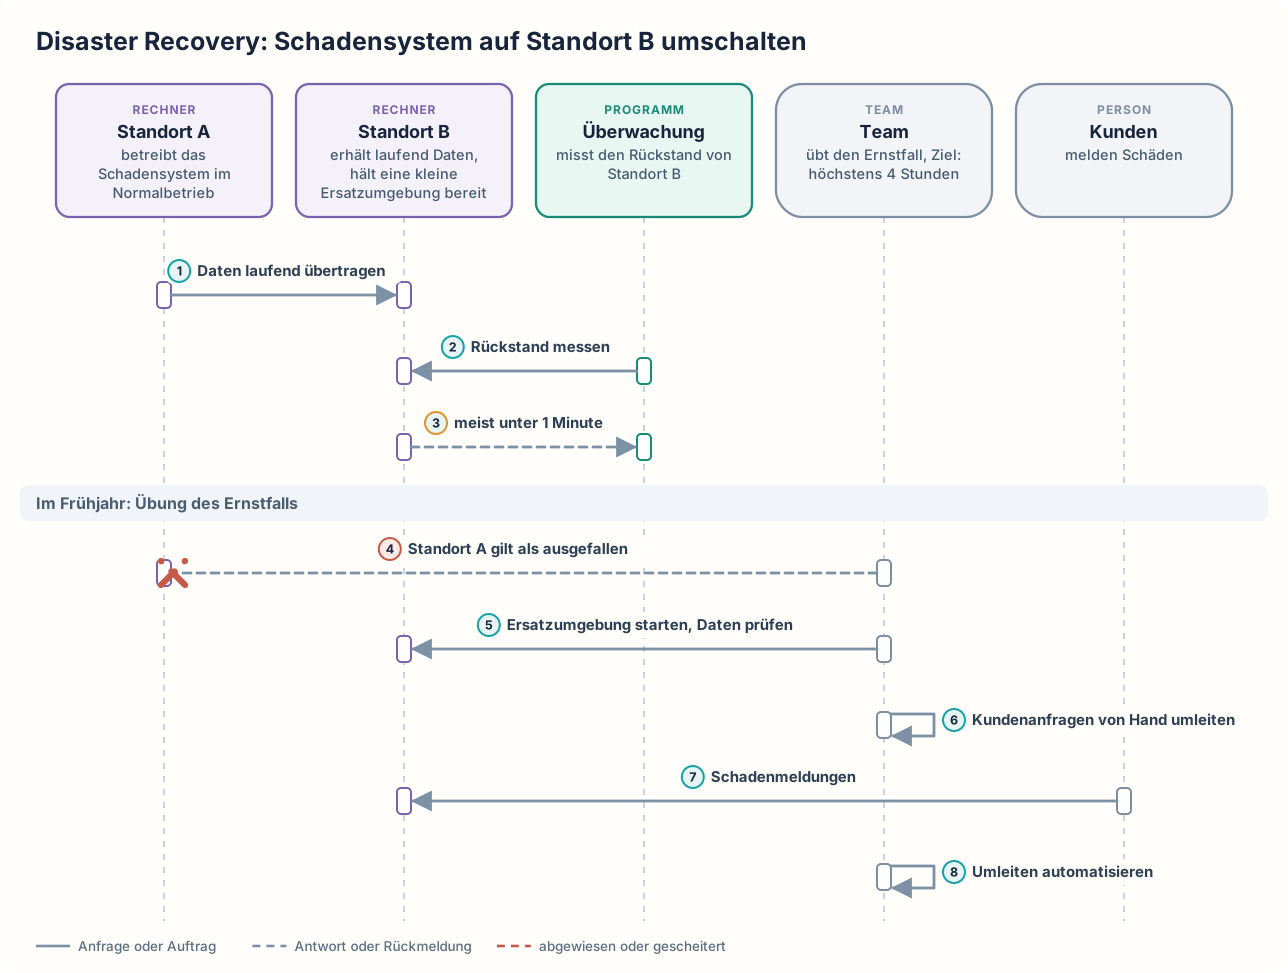
Die Versicherung legt für das Schadensystem fest, dass nach einem Ausfall höchstens die Eingaben der letzten 15 Minuten fehlen dürfen. Dieser Zielwert heißt Recovery Point Objective, kurz RPO, auf Deutsch Ziel für den Wiederherstellungspunkt. Meldungen aus diesen 15 Minuten müssten Kunden im Ernstfall noch einmal eingeben; mehr will die Versicherung ihnen nicht zumuten. Spätestens vier Stunden nach dem Ausfall sollen Kunden wieder Schäden melden können. Dieser Zielwert heißt Recovery Time Objective, kurz RTO, auf Deutsch Ziel für die Wiederherstellungszeit. Vier Stunden sind kurz genug, dass Kunden nach einem Unwetter noch am selben Tag Schäden melden können, und lang genug, um das Schadensystem am zweiten Standort zu starten. Für das RPO von 15 Minuten überträgt Standort A die Daten des Schadensystems laufend an Standort B. Am Standort B liegen zusätzlich Sicherungen früherer Stände, und eine verkleinerte Ersatzumgebung steht bereit. Die Ersatzumgebung hat weniger Server als Standort A, weil sie die meiste Zeit ungenutzt bereitsteht. Die „Überwachung“ misst laufend, wie weit die Daten am Standort B hinter Standort A zurückliegen. Dieser Rückstand liegt meist unter einer Minute. Im Frühjahr übt das Team, das die Systeme der Versicherung betreibt, den Ernstfall und tut so, als wäre Standort A ausgefallen. Das Team startet am Standort B die Server, die Datenprüfung, die nachsieht, ob die übertragenen Daten vollständig sind, und den Anmeldedienst, über den sich Kunden und Sachbearbeiter anmelden. Danach muss ein Mitarbeiter die Kundenanfragen von Hand auf die Adressen von Standort B umleiten. Erst nach dem Umleiten können Kunden wieder Schäden melden. Der Wechsel dauert fünf Stunden und verfehlt das RTO von vier Stunden. Das Team automatisiert das Umleiten. Ob das RTO damit erreicht wird, zeigt erst die nächste Übung.
Die Zielwerte legt die Versicherung für jedes System einzeln fest, weil nicht jedes System gleich dringend ist. Wie lange ein Ausfall dauern darf, kann auch von Verträgen und aufsichtsrechtlichen Vorgaben abhängen. Für das Berichtswesen, aus dem die Monatsberichte kommen, gilt ein RPO von 24 Stunden und ein RTO von drei Tagen. Ein Bericht kann ein paar Tage warten, und fehlende Daten eines Tages lassen sich aus den liefernden Systemen erneut übernehmen. Aus den Zielwerten folgt, welche Technik nötig ist. Bei einem RPO von 24 Stunden genügt eine tägliche Sicherung, die außerhalb von Standort A aufbewahrt wird. Bei einem RPO von 15 Minuten müssen die Daten laufend an den zweiten Standort übertragen werden, und die „Überwachung“ muss den Rückstand messen, weil er bei hoher Last wachsen kann. Bei einem RTO von drei Tagen kann das Team die Server am Standort B erst im Ernstfall einrichten. Bei einem RTO von vier Stunden muss eine Ersatzumgebung am Standort B schon bereitstehen. Zur Wiederherstellungszeit zählt alles, was bis zur Nutzbarkeit nötig ist: Server starten, den Anmeldedienst und andere benötigte Dienste starten, Daten prüfen und Kunden auf den neuen Standort umleiten.
Zum Plan für den Ernstfall gehört die Reihenfolge des Wiederanlaufs, weil Systeme voneinander abhängen. Zuerst startet das Team den Anmeldedienst und andere Dienste, von denen das Schadensystem abhängt, dann das Schadensystem. Der Plan legt außerdem Zuständigkeiten und Telefonketten fest, also wer wen in welcher Reihenfolge anruft. Fällt Standort A aus, entscheidet die im Plan benannte Person, etwa die Leitung des Rechenzentrums, ob auf Standort B umgeschaltet wird. Die Zugangsdaten für Standort B müssen auch ohne Standort A abrufbar sein. Die Sicherungen müssen vor Erpressungssoftware geschützt sein. Das sind Schadprogramme, die alle Daten verschlüsseln und erst gegen Lösegeld wieder freigeben. Ein Schutz sind Kopien, die sich für eine festgelegte Zeit weder ändern noch löschen lassen.
RPO und RTO sind Vorgaben, keine Zusagen. Ob ein System sie einhält, zeigt erst eine Übung, in der das Team den Ablauf durchspielt und die gemessene Dauer und den Datenverlust mit RTO und RPO vergleicht.
Disaster Recovery: Schadensystem auf Standort B umschalten
Wann ist es sinnvoll und wann nicht?
Disaster Recovery lohnt sich
- Ein System ist geschäftskritisch. Ein Beispiel ist das Schadensystem, über das Kunden nach einem Unwetter sofort Schäden melden wollen. Ohne Disaster Recovery können Kunden nach einem Brand am Standort A keine Schäden melden, bis die Versicherung irgendwo neue Server eingerichtet und die Daten aus einer Sicherung eingespielt hat.
- Der Ablauf bis zum Wiederanlauf soll im Voraus feststehen. Ohne vorbereiteten Plan muss das Team im Ernstfall erst klären, wo die letzten Datensicherungen liegen und wer die Zugangsdaten zum zweiten Standort hat. Ebenso offen sind die Reihenfolge, in der die Systeme starten müssen, damit sie einander finden, und wer entscheiden darf. Jede dieser Klärungen kann Stunden dauern. Währenddessen können Kunden keine Schäden melden, und Sachbearbeiter können nicht arbeiten.
- Ein längerer Ausfall hat vertragliche oder aufsichtsrechtliche Folgen, etwa eine Vertragsstrafe, die die Versicherung einem Geschäftskunden für lange Ausfälle zugesagt hat. Ohne vorbereiteten Wiederanlauf weiß die Versicherung nicht, ob sie nach einem Brand rechtzeitig wieder arbeitet, und muss die Vertragsstrafe womöglich zahlen. Welche Vorgaben genau gelten, muss jedes Unternehmen für sich ermitteln.
- Alle Server eines Systems stehen an einem Standort. Ein Brand, ein Hochwasser, ein großflächiger Stromausfall oder ein Angriff mit Erpressungssoftware kann dann das ganze System auf einmal treffen. Ersatzserver im selben Gebäude helfen in diesem Fall nicht, weil sie genauso betroffen sind.
Disaster Recovery ist nicht das Richtige
- Ein System darf mehrere Tage ausfallen. Ein Beispiel ist das Berichtswesen mit einem RTO von drei Tagen. Eine bereitstehende Ersatzumgebung am Standort B müsste dann das ganze Jahr bezahlt und bei jeder Änderung mitgepflegt werden, obwohl drei Tage reichen, um die Server erst im Ernstfall aufzubauen. Stattdessen sichert das Team die Daten täglich außerhalb von Standort A und baut die Umgebung erst im Ernstfall neu auf. Auch das ist Disaster Recovery, nur mit weniger Vorbereitung. Ist die Umgebung als Infrastructure as Code beschrieben, also in Dateien, aus denen ein Werkzeug Server und Einstellungen selbst aufbaut, muss das Team die Server dabei nicht von Hand einrichten. Wie weit eine Ersatzumgebung vorbereitet ist, beschreibt Hot Warm Cold Standby.
- Nur ein einzelner Server innerhalb eines Standorts fällt aus. Ein Umschalten auf Standort B würde dann das ganze Schadensystem verlegen, obwohl nur ein Server fehlt. Dann übernimmt ein Ersatzserver im selben Rechenzentrum die Arbeit des ausgefallenen Servers (Redundancy and Failover). Das Schadensystem bleibt am Standort A, und niemand muss Kundenanfragen auf Standort B umleiten.
- Daten wurden versehentlich gelöscht oder verfälscht. Dagegen hilft das Umschalten auf Standort B nicht, weil die laufende Übertragung den Fehler mitkopiert. Dann stellt das Team die betroffenen Daten aus einer Sicherung eines früheren Stands wieder her, und das Schadensystem läuft am Standort A weiter.
- Ein System soll den Verlust eines Standorts ohne spürbare Unterbrechung überstehen. Ein Wiederanlauf nach Stunden genügt dann nicht. Stattdessen betreibt die Versicherung das System an beiden Standorten gleichzeitig. Ein Lastverteiler schickt jede Kundenanfrage an einen der beiden Standorte, und dieser Standort beantwortet sie. Fällt ein Standort aus, schickt der Lastverteiler alle Anfragen an den anderen, ohne dass jemand umschaltet. Dafür braucht Standort B so viele Server wie Standort A, und es braucht Regeln dafür, was gilt, wenn an beiden Standorten gleichzeitig derselbe Schaden geändert wird.
Nachteile und typische Fehler
Je kürzer die Zielwerte, desto mehr Technik und Vorbereitung braucht ein System und desto mehr muss die Versicherung dafür bezahlen, weil eine zweite Umgebung ständig bereitstehen und bei jeder Änderung mitgepflegt werden muss. Für das Schadensystem bezahlt die Versicherung eine Ersatzumgebung am Standort B, eine laufende Datenübertragung mit Überwachung und Speicher für Sicherungen früherer Stände. Übungen binden das Team für Stunden und müssen so geplant werden, dass der Normalbetrieb nicht gestört wird. Auch der Plan braucht Pflege: Zugangsdaten, Telefonketten und Zuständigkeiten müssen aktuell sein und auch dann vorliegen, wenn Standort A ausgefallen ist.
Typische Fehler und woran man sie erkennt:
- Nie geübter Plan: Der Plan existiert nur auf dem Papier. Im Ernstfall fehlen Schritte, oder sie dauern viel länger als gedacht. Erkennbar ist das schon vorher daran, dass es kein Übungsprotokoll mit gemessener Dauer gibt.
- Mitkopierter Fehler: Die laufende Übertragung an den zweiten Standort überträgt auch Fehler sofort. Beispiele sind versehentlich gelöschte Daten und von Erpressungssoftware verschlüsselte Dateien. Ohne Sicherungen älterer Stände ist dann auch Standort B unbrauchbar. Erkennbar ist das an verschlüsselten oder fehlenden Daten an beiden Standorten zur selben Zeit.
- Vergessene Abhängigkeit: Ein zentraler Anmeldedienst läuft nur am Standort A. Im Ernstfall startet das Schadensystem am Standort B, aber niemand kann sich anmelden. Erkennbar ist das in einer Übung an Anmeldefehlern, obwohl das Schadensystem selbst läuft.
- Veralteter Plan: Neue Systeme kommen hinzu oder Abhängigkeiten ändern sich, und niemand nimmt sie in den Plan auf und passt die Reihenfolge des Wiederanlaufs an. Erkennbar ist das an Systemen, die in der Betriebsüberwachung auftauchen, im Plan aber fehlen.
- Unbemerkter Rückstand: Die „Überwachung“ misst den Rückstand, aber niemand hat einen Alarm für das Überschreiten des RPO eingerichtet. Bei hoher Last wächst der Rückstand von Standort B auf über 15 Minuten, und niemand bemerkt es. Fällt Standort A in dieser Zeit aus, fehlen am Standort B die Eingaben von mehr als 15 Minuten. Erkennbar ist das nur in den Messwerten der „Überwachung“.
Weiterführend
Verwandte Ansätze
- Replication: beschreibt das laufende Kopieren von Daten an einen zweiten Standort.
- Chaos Engineering: beschreibt geplante Versuche mit absichtlich herbeigeführten Ausfällen, zu denen auch Übungen für den Ernstfall gehören.
Werkzeuge und Umsetzungen
- Velero: sichert Anwendungen und ihre Daten in Kubernetes, einer verbreiteten Plattform zum Betrieb von Anwendungen auf vielen Servern, und stellt sie wieder her, auch an einem anderen Standort.
- pgBackRest und Barman: sichern die Datenbank PostgreSQL laufend und erlauben die Wiederherstellung des Stands zu einem gewählten Zeitpunkt.
- BorgBackup und restic: verschlüsselte Datensicherung, die frühere Stände aufbewahrt und auch an entfernte Orte schreiben kann.
- DRBD: spiegelt die Festplatten eines Servers laufend auf einen zweiten Server.
Quellen
- AWS Prescriptive Guidance: Implement a backup strategy: definiert RPO und RTO als Zielwerte, an denen sich eine Sicherungsstrategie ausrichtet.
- AWS: Disaster Recovery of Workloads on AWS. Recovery in the Cloud: Leitfaden, der RPO und RTO definiert, Strategien von der Sicherung bis zur bereitstehenden verkleinerten Ersatzumgebung beschreibt, regelmäßige Übungen verlangt und warnt, dass eine laufende Übertragung auch verfälschte Daten mitkopiert und Sicherungen früherer Stände nicht ersetzt.