
Chaos Engineering
Ausfälle absichtlich herbeiführen und beobachten
Die Idee und ihr Nutzen
Das Kundenportal einer Versicherung läuft gleichzeitig auf drei Servern, damit es erreichbar bleibt, wenn einer der Server ausfällt. Ob das wirklich klappt, hat das zuständige IT-Team nie ausprobiert. Das Team schaltet deshalb in einem geplanten und begrenzten Versuch absichtlich einen der drei Server ab und misst, ob Kunden ihre Schadenmeldungen weiterhin so schnell absenden können wie sonst. So findet das Team Fehler, bevor ein ungeplanter Ausfall Kunden trifft. Ein solcher Fehler kann zum Beispiel im Lastverteiler liegen, der die Anfragen auf die drei Server verteilt und noch 40 Sekunden lang Anfragen an den abgeschalteten Server schickt. Solche Versuche heißen Chaos Engineering.

Wie funktioniert es?
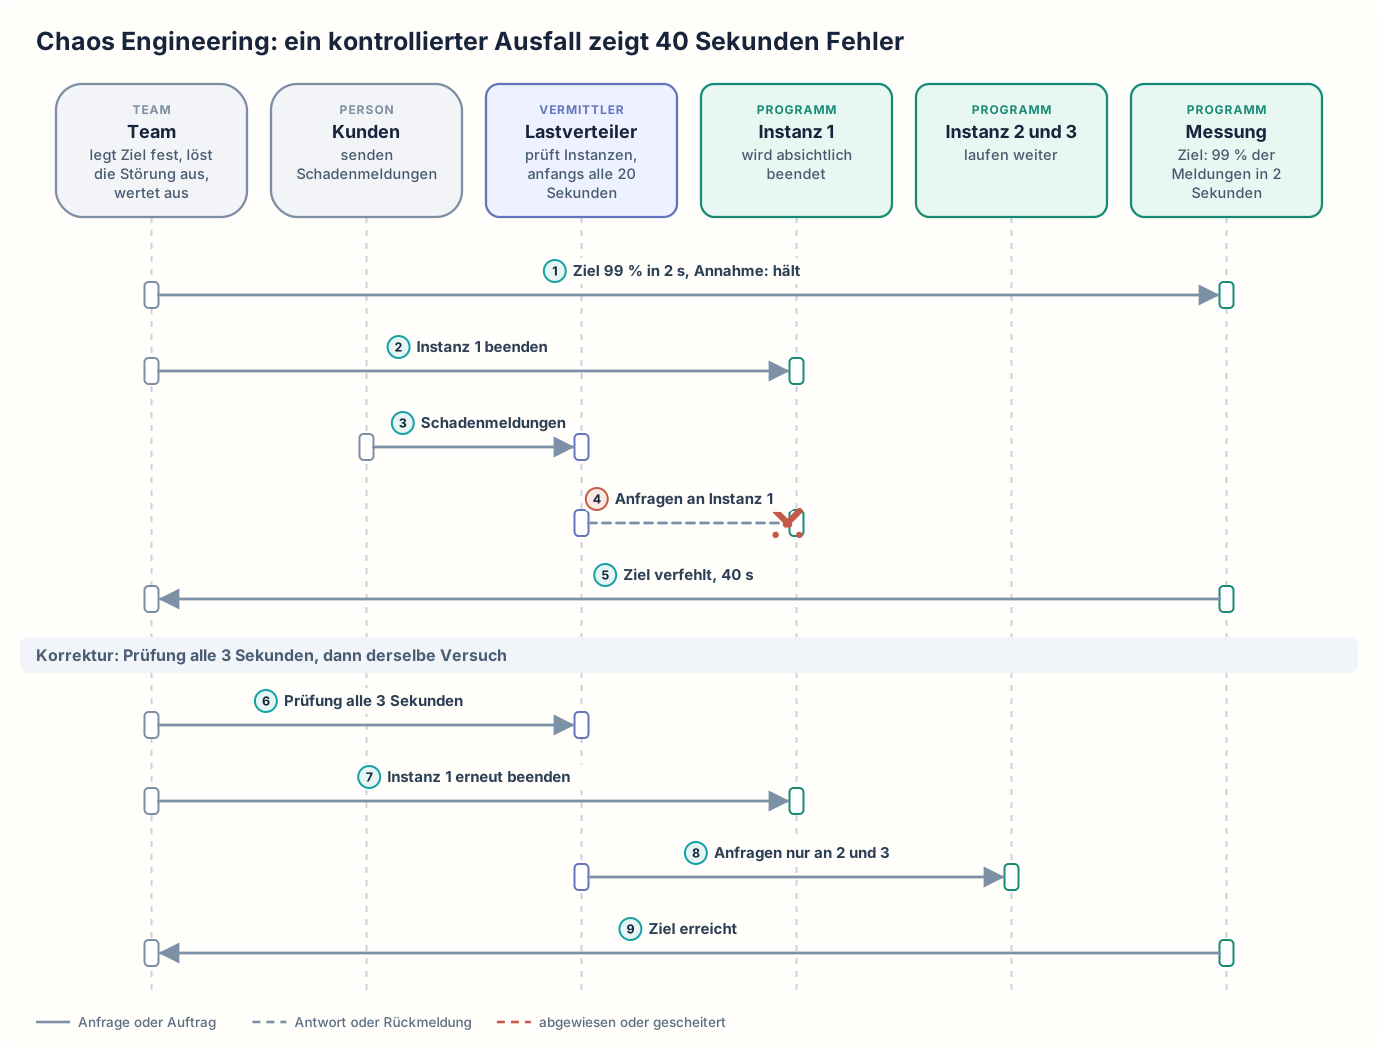
Das Kundenportal läuft in drei Instanzen, also drei gleichartigen, gleichzeitig laufenden Exemplaren desselben Programms auf den drei Servern: Instanz 1, Instanz 2 und Instanz 3. Weil alle drei Instanzen dasselbe Programm ausführen, kann jede Instanz jede Schadenmeldung annehmen. Der Lastverteiler prüft regelmäßig, ob jede Instanz antwortet, und soll ausgefallene Instanzen meiden. Das Team legt als Ziel fest, dass mindestens 99 Prozent der Schadenmeldungen innerhalb von zwei Sekunden angenommen werden, und erwartet, dass dieses Ziel auch beim Ausfall einer Instanz erreicht wird. Das Team übernimmt damit den Wert, den es mit Betrieb und Fachbereich für das Kundenportal vereinbart hat und den das Kundenportal an gewöhnlichen Tagen erreicht. Während des Versuchs prüft die „Messung“, also die laufende Überwachung der Antwortzeiten, ob das Ziel erreicht wird. An einem Dienstagvormittag beendet das Team absichtlich Instanz 1. Die Kunden senden weiter Schadenmeldungen an den Lastverteiler. Der Lastverteiler prüft die Instanzen aber nur alle 20 Sekunden und nimmt eine Instanz erst nach zwei gescheiterten Prüfungen aus der Verteilung. Deshalb schickt er noch 40 Sekunden lang Anfragen an die beendete Instanz 1, und diese Anfragen scheitern. Die „Messung“ zeigt, dass das Ziel in diesen 40 Sekunden verfehlt wird. Das Team stellt den Lastverteiler auf eine Prüfung alle drei Sekunden um. Mit zwei gescheiterten Prüfungen meidet der Lastverteiler eine ausgefallene Instanz dann nach höchstens sechs Sekunden statt nach 40. Das Team wiederholt genau denselben Versuch. Diesmal nimmt der Lastverteiler Instanz 1 nach wenigen Sekunden aus der Verteilung und schickt neue Anfragen nur noch an Instanz 2 und 3. Die „Messung“ zeigt, dass das Ziel erreicht wird, für genau diesen Ausfall bei der gemessenen Last.
Vor jedem Versuch legt das Team eine Messgröße fest, die aus Sicht der Kunden beschreibt, dass das Kundenportal funktioniert. Hier ist das der Anteil der Schadenmeldungen, die innerhalb von zwei Sekunden angenommen werden. Liegt die Messgröße im vereinbarten Bereich, hier bei mindestens 99 Prozent, ist das Kundenportal im Normalzustand. In einer Annahme hält das Team schriftlich fest, was es bei einer bestimmten Störung erwartet. Hier ist das die Erwartung, dass das Ziel auch beim Ausfall einer Instanz erreicht wird. Eine Abbruchregel legt fest, ab welcher Verschlechterung der Messgröße das Team den Versuch sofort beendet und den Ausgangszustand wiederherstellt. Hier könnte die Abbruchregel lauten, Instanz 1 sofort wieder zu starten, wenn der Anteil länger als eine Minute unter 90 Prozent liegt. Dann löst das Team genau eine Störung aus, beobachtet die „Messung“ und wertet die Messwerte aus. Statt eine Instanz zu beenden, kann das Team auch eine Netzverbindung verlangsamen oder einen abhängigen Dienst unerreichbar machen, also ein anderes Programm, auf dessen Antworten das Kundenportal angewiesen ist. Bleibt die Messgröße im vereinbarten Bereich, ist die Annahme für diesen Fall bestätigt. Chaos Engineering behebt keine Schwachstelle, es zeigt sie nur; die Korrektur nimmt das Team selbst vor und prüft sie mit demselben Versuch.
Im Echtbetrieb, also im laufenden Kundenportal, betreffen Versuche echte Kunden. Deshalb entscheiden über jeden Versuch nicht nur die Entwickler im Team, sondern auch die Verantwortlichen aus Betrieb und Fachbereich. Die Verantwortlichen müssen Umfang, Zeitpunkt, Abbruchregel und mögliche Folgen jedes Versuchs kennen und den Versuch freigeben. Die ersten Versuche macht das Team in einer Testumgebung oder mit einem kleinen Teil der echten Anfragen, zu einer Zeit, in der alle Beteiligten erreichbar sind. Erst wenn die Versuche verlässlich verlaufen, weitet das Team sie auf alle Anfragen im Echtbetrieb aus.
Chaos Engineering: ein kontrollierter Ausfall zeigt 40 Sekunden Fehler
Wann ist es sinnvoll und wann nicht?
Chaos Engineering lohnt sich
- Schutzmaßnahmen gegen Ausfälle sind eingebaut, wurden aber noch nie bei einem echten Ausfall erprobt. Beim Kundenportal laufen drei Instanzen, auf die ein Lastverteiler die Schadenmeldungen verteilt. Außerdem gibt es Wiederholungen gescheiterter Anfragen und Zeitgrenzen für Antworten. Ohne Versuch weiß niemand, ob diese Schutzmaßnahmen bei einem Ausfall wirklich greifen.
- Ein falsch eingestellter Schutz soll nicht erst im Ernstfall auffallen. Bis dahin sieht das Kundenportal von außen fehlerfrei aus, und der Ernstfall kommt oft nachts und in einer Form, die niemand getestet hat. Mit dem Versuch findet das Team die 40 Sekunden mit gescheiterten Anfragen an einem geplanten Dienstagvormittag.
- Ein System besteht aus vielen Teilen, die voneinander abhängen, und Ausfälle sind teuer. Beim Kundenportal sind das die drei Instanzen, der Lastverteiler und weitere Dienste, die das Kundenportal aufruft. Dass einzelne Teile ausfallen, ist in einem solchen System zu erwarten, kommt aber so selten vor, dass das Team es im Alltag kaum erlebt. Ohne Versuch sieht das Team erst beim ersten echten Ausfall, wie die Teile dabei zusammenspielen.
- Die Überwachung zeigt die Folgen eines Versuchs sofort. Beim Kundenportal zeigt die „Messung“ die 40 Sekunden mit gescheiterten Anfragen, während sie geschehen. Nur dann kann das Team den Versuch nach der Abbruchregel rechtzeitig beenden.
- Die Schutzmaßnahmen sollen an einer Messgröße aus Sicht der Kunden beurteilt werden und nicht an Vermutungen. Betrieb und Fachbereich wissen nach dem Versuch, welchen Ausfall das Kundenportal bei welcher Last nachweislich übersteht.
Chaos Engineering ist nicht das Richtige
- Grundlegende Schutzmaßnahmen fehlen noch, zum Beispiel läuft das Kundenportal nur in einer einzigen Instanz. Ein Versuch würde nur zeigen, was schon feststeht: Fällt die einzige Instanz aus, kann kein Kunde eine Schadenmeldung absenden. Stattdessen richtet das Team zuerst weitere Instanzen ein und einen Lastverteiler, der die Schadenmeldungen auf die Instanzen verteilt. Die Vorbereitung des Versuchs und die gescheiterten Schadenmeldungen während des Versuchs entfallen.
- Der Versuch lässt sich nicht abbrechen, zum Beispiel weil sich eine beendete Instanz nicht schnell wieder starten lässt. Verfehlt das Kundenportal während des Versuchs das Ziel, könnte das Team die Abbruchregel nicht befolgen, und die Störung träfe die Kunden bis zum Neustart von Instanz 1. Dann sorgt das Team zuerst dafür, dass eine beendete Instanz schnell wieder startet, und plant den Versuch erst danach.
- Das Kundenportal wird noch entwickelt, oder die Verantwortlichen aus Betrieb und Fachbereich haben Versuche im Echtbetrieb nicht freigegeben. In beiden Fällen kann das Team keinen Versuch mit echten Anfragen machen. Stattdessen führt das Team einzelne Fehler mit automatischen Tests in einer Testumgebung gezielt herbei. Ein Beispiel ist eine verzögerte Netzverbindung zu einem abhängigen Dienst. Solche Tests betreffen keine echten Kunden. Das Ergebnis solcher Tests gilt aber nur für die Testumgebung. In der Testumgebung kann der Lastverteiler zum Beispiel einen anderen Prüfabstand haben als im Echtbetrieb.
Nachteile und typische Fehler
Jeder Versuch braucht Vorbereitung. Messgröße und Abbruchregel müssen festgelegt sein, der Ausgangszustand muss sich schnell wiederherstellen lassen, und alle Beteiligten müssen während des Versuchs erreichbar sein. Ohne verlässliche Überwachung lässt sich ein Versuch weder sicher durchführen noch auswerten. Auch ein gut vorbereiteter Versuch kann Kunden kurzzeitig beeinträchtigen. Im Versuch am Dienstagvormittag scheitern 40 Sekunden lang Schadenmeldungen von Kunden. Die Aussagekraft eines Versuchs bleibt begrenzt: Für andere Störungen und andere Lasten braucht das Team weitere Versuche, und es muss die Versuche wiederholen, wenn sich das Kundenportal ändert.
Typische Fehler und woran man sie erkennt:
- Zu große Reichweite: Das Team beendet Instanz 1 zu einer Zeit, in der viele Kunden Schadenmeldungen senden. Der Lastverteiler schickt alle Anfragen an Instanz 2 und 3. Jede der beiden Instanzen erhält jetzt die Hälfte statt eines Drittels der Anfragen, also anderthalbmal so viele wie vorher. Reicht die Rechenleistung der beiden Server dafür nicht, antworten auch Instanz 2 und 3 zu langsam, und der Versuch löst eine echte Störung aus. Erkennbar ist das an langsamen Antworten von Instanz 2 und 3, die der Versuch nicht betreffen sollte.
- Keine Messgröße: Das Team hat vor dem Versuch keine Messgröße festgelegt und kann danach nicht sagen, ob das Kundenportal die Störung überstanden hat. Erkennbar ist das an Auswertungen, die Eindrücke statt Messwerte enthalten.
- Abbruch zu spät: Die Abbruchregel fehlt oder wird nicht beachtet, und der Versuch läuft weiter, obwohl die Messgröße längst außerhalb des vereinbarten Bereichs liegt. Erkennbar ist das an einer Messkurve, die während des Versuchs lange unter dem Ziel bleibt.
- Überschätztes Ergebnis: Das Team schließt aus dem bestandenen Versuch, dass das Kundenportal jede Störung übersteht. Erkennbar ist das an einem späteren echten Ausfall anderer Art, etwa eines abhängigen Dienstes, den kein Versuch geprüft hatte.
Weiterführend
Verwandte Ansätze
- Circuit Breaker, Timeout und Redundancy and Failover: Schutzmaßnahmen, deren Wirkung mit solchen Versuchen überprüft wird.
- Observability: beschreibt die Messwerte, Protokolle und Aufzeichnungen einzelner Anfragen über alle beteiligten Dienste, ohne die sich die Folgen eines Versuchs nicht erkennen lassen.
- Disaster Recovery: Pläne für den Ausfall eines ganzen Standorts. Übungen nach diesen Plänen sind eine große Form solcher Versuche.
Werkzeuge und Umsetzungen
- Chaos Mesh: löst in Kubernetes, einer verbreiteten Plattform zum Betrieb von Anwendungen auf vielen Servern, Störungen wie Ausfälle, Netzverzögerungen oder falsch gehende Uhren aus.
- LitmusChaos: Plattform mit einer Sammlung fertiger Versuche für Kubernetes.
- Chaos Monkey: beendet im laufenden Betrieb zufällig ausgewählte Server. Chaos Monkey setzt die Auslieferungsplattform Spinnaker voraus.
- Toxiproxy: Programm, über das ein Dienst seine Anfragen an einen anderen Dienst schickt. Toxiproxy reicht die Anfragen weiter und kann sie dabei gezielt verzögern, drosseln oder unterbrechen. Toxiproxy eignet sich vor allem für automatische Tests.
Quellen
- principlesofchaos.org: Principles of Chaos Engineering: Grundsätze des Verfahrens mit Normalzustand, Annahme, Störungen, die echten Ereignissen nachempfunden sind, und möglichst kleiner Reichweite der Versuche.
- AWS: REL12-BP04 Test resiliency using chaos engineering: Empfehlung des AWS Well-Architected Framework mit Normalzustand, Annahme, Abbruchbedingungen, dem Beginn außerhalb des Echtbetriebs und der Ankündigung an Betrieb und Support.