
Timeout
Wartezeit auf eine Antwort begrenzen
Die Idee und ihr Nutzen
Ein Kunde öffnet im Portal seiner Versicherung seine Schadenakte. Neben den Angaben zum Schaden zeigt die Seite auch Empfehlungen für Werkstätten in der Nähe des Kunden an. Die Empfehlungen liefert der Partnerdienst, ein Programm eines anderen Unternehmens. Antwortet der Partnerdienst nicht, soll der Kunde nicht unbegrenzt auf die ganze Seite warten müssen. Das Entwicklungsteam des Portals legt deshalb für das Warten eine Zeitgrenze von zwei Sekunden fest, damit die ganze Seite nach höchstens drei Sekunden aufgebaut ist; länger wollen die meisten Kunden nicht auf eine Seite warten. Kommt innerhalb dieser zwei Sekunden keine Antwort, bricht das Portal das Warten ab und zeigt die Schadenakte ohne Empfehlungen an. Diese Begrenzung der Wartezeit heißt Timeout, auf Deutsch Zeitüberschreitung.
Wie funktioniert es?
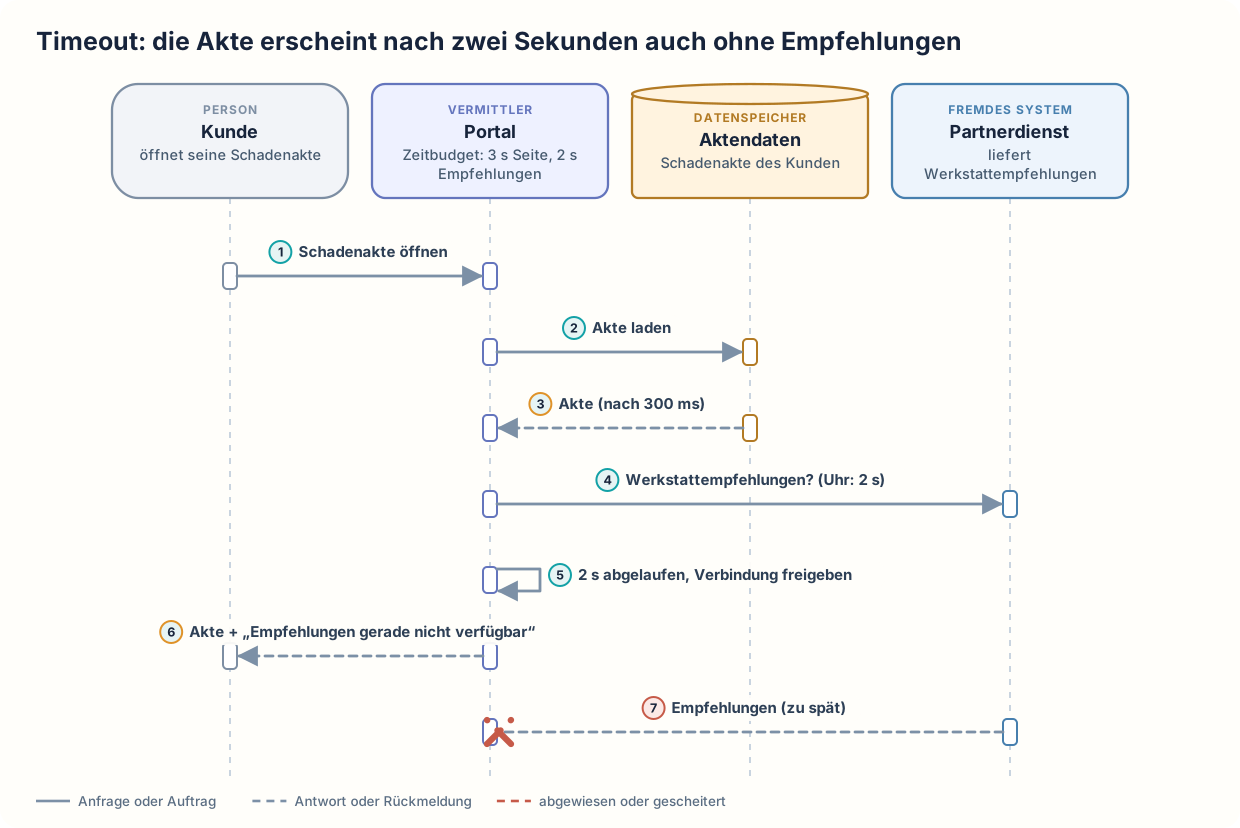
Der Kunde öffnet seine Schadenakte. Das Portal lädt die Akte aus den Aktendaten, der eigenen Datenbank des Portals, und hat die Akte nach 300 Millisekunden bereit. Danach fragt das Portal den Partnerdienst nach Werkstattempfehlungen und startet dabei eine Uhr mit zwei Sekunden. Diesmal ist der Partnerdienst überlastet und antwortet nicht rechtzeitig. Nach zwei Sekunden ist die Zeitgrenze abgelaufen. Das Portal hört auf zu warten. Die Anfrage hat bis dahin eine Netzverbindung zum Partnerdienst belegt, und das Portal gibt diese Netzverbindung jetzt frei. Danach zeigt das Portal dem Kunden die Schadenakte mit dem Hinweis „Werkstattempfehlungen sind gerade nicht verfügbar“. Der Kunde sieht nach gut zwei Sekunden seine Akte und kann weiterarbeiten. Der Partnerdienst hat vielleicht weitergearbeitet und schickt seine Antwort später. Das Portal verwirft diese späte Antwort.
Das Entwicklungsteam leitet die Zeitgrenze aus einem Zeitbudget ab, also aus der Zeit, die der Aufbau der ganzen Seite höchstens dauern darf. Für die ganze Seite sind das drei Sekunden, davon zwei Sekunden für die Empfehlungen. Der Partnerdienst antwortet an gewöhnlichen Tagen in weniger als einer Sekunde; zwei Sekunden reichen ihm also an solchen Tagen. Macht eine Seite mehrere Aufrufe, teilt das Entwicklungsteam das Zeitbudget auf alle diese Aufrufe auf. Die Uhr läuft im Portal, und nur das Portal bricht ab. Ein Timeout beendet das Warten des Aufrufers, aber nicht unbedingt die Arbeit des aufgerufenen Dienstes. Der Partnerdienst kann die Anfrage erhalten, bearbeitet und sogar erfolgreich abgeschlossen haben, und nur die Antwort ist nicht rechtzeitig angekommen. Der Timeout macht den Partnerdienst auch weder schneller noch zuverlässiger. Der Timeout sorgt nur dafür, dass das Portal nicht länger als zwei Sekunden auf den Partnerdienst wartet und dass wartende Anfragen keine Verbindungen unbegrenzt belegen. Den Hinweis auf die fehlenden Werkstattempfehlungen hat das Entwicklungsteam vorher als Ersatzanzeige festgelegt. Der Hinweis sagt dem Kunden, was fehlt; ohne den Hinweis sähe der Kunde eine unvollständige Seite ohne Erklärung.
Die Ersatzanzeige ist vertretbar, weil die Werkstattempfehlungen ein verzichtbarer Zusatz sind. Auch dass der Partnerdienst vielleicht weitergearbeitet hat, ist bei den Werkstattempfehlungen unbedenklich, weil die Abfrage beim Partnerdienst nichts verändert.
Timeout: die Akte erscheint nach zwei Sekunden auch ohne Empfehlungen
Wann ist es sinnvoll und wann nicht?
Ein Timeout lohnt sich
- Ein Programm ruft einen anderen Dienst über das Netzwerk auf. Ohne Zeitgrenze wartet das Portal so lange, wie der Partnerdienst braucht, und auf einen Partnerdienst, der gar nicht antwortet, ohne Ende. Jeder solche Aufruf und jeder andere Vorgang, bei dem das Programm unbestimmt lange warten kann, etwa auf eine Datenbank, sollte deshalb eine Zeitgrenze haben.
- Ein Zusatz wie die Werkstattempfehlungen darf den Aufbau einer Seite nicht aufhalten, deren wichtigster Teil schon fertig ist. Ohne Zeitgrenze wartet das Portal immer weiter, und der Kunde sieht nur eine leere Seite mit Ladesymbol, obwohl seine Akte längst bereitliegt.
- Viele Kunden lösen gleichzeitig denselben Aufruf aus. Jede wartende Anfrage belegt im Portal Arbeitsspeicher und eine Verbindung zum Partnerdienst. Öffnen viele Kunden gleichzeitig ihre Akte, gehen dem Portal ohne Zeitgrenze die freien Verbindungen aus, und das Portal wird auch für alle anderen Kunden langsam. Mit Zeitgrenze gibt das Portal jede Verbindung nach spätestens zwei Sekunden frei.
Ein Timeout ist nicht das Richtige
- Das Ergebnis einer Anfrage wird zwingend gebraucht. Ein Beispiel ist die Deckungsprüfung, die klärt, ob der Vertrag den Schaden abdeckt. Dann genügt ein Timeout allein nicht, denn das Portal darf die Deckungsprüfung nach Ablauf der Zeitgrenze nicht einfach weglassen wie die Werkstattempfehlungen. Das Entwicklungsteam legt zusätzlich fest, dass das Portal die Deckung nach Ablauf der Zeitgrenze als ungeklärt kennzeichnet und später erneut fragt. So entscheidet das Portal nichts über den Schaden, solange die Deckung nicht geprüft ist.
- Eine Anfrage verändert etwas und hat keine eindeutige Auftragskennung. Ein Beispiel ist eine Anfrage, die eine Zahlung auslöst. Wiederholt das Portal die Anfrage nach Ablauf der Zeitgrenze, kann dieselbe Zahlung doppelt ausgelöst werden. Ohne Kennung müsste das Portal vor jeder Wiederholung klären, ob die erste Anfrage schon ausgeführt wurde. Deshalb schickt das Portal jede solche Anfrage mit einer eindeutigen Auftragskennung, und der Dienst, der die Zahlung ausführt, führt einen Auftrag mit derselben Kennung nur einmal aus. Das heißt Idempotency. Das Portal kann die Anfrage danach wiederholen, ohne vorher zu klären, ob die erste Anfrage schon ausgeführt wurde.
- Ein Auftrag läuft lange, und seine Dauer schwankt stark. Ein Beispiel ist die Erstellung eines Jahresberichts. Eine kurze Zeitgrenze bräche dann viele Aufträge ab, die noch fertig geworden wären, und eine lange ließe das Portal minutenlang warten. Stattdessen legt das Portal den Auftrag in eine Warteschlange, und ein Programm im Hintergrund arbeitet den Auftrag ab. Das heißt asynchrone Kommunikation. Das Portal wartet nicht, sondern holt das Ergebnis später ab. Das Entwicklungsteam muss keine Zeitgrenze suchen, die zu einer stark schwankenden Dauer passt.
- Der Partnerdienst ist nicht nur einmal langsam, sondern über Minuten gestört. Dann baut das Entwicklungsteam zusätzlich zum Timeout einen Circuit Breaker in das Portal ein, einen Programmteil, der zählt, wie viele Anfragen an den Partnerdienst scheitern. Scheitern zu viele, fragt das Portal den Partnerdienst vorübergehend gar nicht mehr und zeigt sofort den Hinweis auf die fehlenden Werkstattempfehlungen. Die Kunden warten dann nicht bei jedem Öffnen der Akte zwei Sekunden.
- Die Werkstattempfehlungen müssen nicht auf die Minute aktuell sein und ändern sich selten. Dann muss das Portal den Partnerdienst nicht fragen, während der Kunde auf seine Akte wartet. Das Portal ruft die Werkstattempfehlungen im Hintergrund ab und hält sie in einem Zwischenspeicher bereit, siehe Caching. Beim Öffnen der Akte liest das Portal die Empfehlungen aus dem Zwischenspeicher, und der Kunde wartet gar nicht auf den Partnerdienst. Der Abruf im Hintergrund braucht weiterhin eine Zeitgrenze, aber kein Kunde wartet auf ihn.
Nachteile und typische Fehler
Das Entwicklungsteam muss die Zeitgrenze für jeden Aufruf bewusst wählen und pflegen. Die Zeitgrenze sollte aus der Wartezeit abgeleitet werden, die Nutzer akzeptieren, und aus den Wartezeiten der anderen beteiligten Aufrufe. Ändert sich die normale Antwortzeit des Partnerdienstes, muss das Entwicklungsteam die Zeitgrenze überprüfen. Für jeden Aufruf mit Zeitgrenze muss außerdem feststehen, was nach Ablauf geschieht: eine Ersatzanzeige wie bei den Werkstattempfehlungen, eine Kennzeichnung als ungeklärt wie bei der Deckungsprüfung oder eine Klärung vor einer Wiederholung.
Typische Fehler und woran man sie erkennt:
- Timeout als „nicht ausgeführt“ gedeutet: Ein Timeout beweist nicht, dass der aufgerufene Dienst nichts getan hat. Das Portal schickt zum Beispiel eine Anfrage, die eine Zahlung auslöst, an den Dienst, der Zahlungen ausführt. Dieser Dienst führt die Zahlung aus, aber seine Antwort kommt erst nach Ablauf der Zeitgrenze. Das Portal hält die Anfrage für gescheitert und schickt sie ohne eindeutige Auftragskennung noch einmal. Der Dienst führt die Zahlung ein zweites Mal aus. Erkennbar ist das an doppelten Aufträgen, deren erster Versuch mit einem Timeout endete.
- Keine oder zu lange Grenze: Das Entwicklungsteam übernimmt die Voreinstellung der Programmbibliothek, mit der das Portal den Partnerdienst aufruft. Eine Programmbibliothek ist fertiger Code, den ein Programm einbindet. Die Grenze liegt dann oft bei mehreren Minuten oder fehlt ganz. Kunden warten vor leeren Seiten, und dem Portal gehen die Verbindungen aus. Erkennbar ist das an Antwortzeiten des Portals, die genau mit den Störungen des Partnerdienstes steigen.
- Zu kurze Grenze: Die Grenze liegt unter der normalen Antwortzeit des Partnerdienstes. Das Portal bricht Anfragen ab, die kurz darauf erfolgreich gewesen wären, und Kunden sehen den Hinweis auch an gewöhnlichen Tagen. Erkennbar ist das an vielen Zeitüberschreitungen, obwohl der Partnerdienst keine Störung meldet.
- Unabgestimmte Grenzen in einer Kette: Der Partnerdienst fragt für seine Empfehlungen selbst einen weiteren Dienst ab, zum Beispiel einen Kartendienst, und wartet darauf bis zu zehn Sekunden. Diese Grenze ist nicht mit den zwei Sekunden des Portals abgestimmt. Das Portal hat nach zwei Sekunden aufgegeben, während der Partnerdienst noch auf den Kartendienst wartet und danach Empfehlungen berechnet, die niemand mehr abholt. Erkennbar ist das an vielen späten Antworten des Partnerdienstes, die das Portal verwirft.
- Fehlende Antwort übergangen: Das Ergebnis der Deckungsprüfung wird zwingend gebraucht. Trotzdem behandelt das Portal den Ablauf der Zeitgrenze bei der Deckungsprüfung wie eine leere Antwort und bearbeitet den Schaden weiter, als sei die Deckung geklärt. Erkennbar ist das an Entscheidungen, die ohne das Ergebnis eines zwingend nötigen Aufrufs getroffen wurden.
Weiterführend
Verwandte Ansätze
- Retry with Backoff: wiederholt eine gescheiterte Anfrage nach wachsenden Pausen. Jede Wiederholung braucht ihre eigene Zeitgrenze, und alle zusammen müssen ins Zeitbudget passen.
- Fallback: legt fest, welche Ersatzantwort das Programm nach Ablauf der Zeitgrenze zeigt, zum Beispiel den Hinweis auf fehlende Werkstattempfehlungen.
- Bulkhead: begrenzt, wie viele Verbindungen die Anfragen an den Partnerdienst höchstens belegen dürfen, auch solange die Anfragen noch innerhalb ihrer Zeitgrenze warten.
Quellen
- Marc Brooker, Amazon Web Services: Timeouts, retries, and backoff with jitter: erklärt, wie sich eine Zeitgrenze aus den gemessenen Antwortzeiten des aufgerufenen Dienstes ableiten lässt, welche Folgen zu lange und zu kurze Grenzen haben und warum nur idempotente Aufrufe, also solche, deren Wiederholung nichts zusätzlich verändert, gefahrlos wiederholt werden können.
- gRPC: Deadlines: offizielle Dokumentation, nach der ohne eigene Einstellung keine Zeitgrenze gilt, der Server nach Ablauf selbst aufhören muss zu arbeiten und die verbleibende Zeit an weitere Aufrufe in einer Kette weitergegeben werden kann.