
Repository
Datenzugriff hinter einer fachlichen Sammlung verbergen
Die Idee und ihr Nutzen
Eine Sachbearbeiterin einer Versicherung öffnet morgens ihre Arbeitsliste. Die Schadenanwendung, mit der sie arbeitet, soll ihr alle Schäden anzeigen, die noch offen sind. Der Programmteil mit den fachlichen Regeln, die Fachlogik, braucht dafür die offenen Schäden, soll aber nicht wissen müssen, in welcher Datenbanktabelle und in welchen Spalten diese Schäden gespeichert sind. Ein zusätzlicher Programmteil bietet der Fachlogik deshalb verständlich benannte Methoden an, zum Beispiel „finde alle offenen Schäden“. Eine Methode ist ein benannter Programmteil, den andere Programmteile aufrufen können. Der zusätzliche Programmteil übersetzt jeden Aufruf einer solchen Methode in eine Datenbankabfrage und gibt die gefundenen Schäden zurück. So enthält die Fachlogik keine Tabellen- und Spaltennamen, und das Team der Schadenanwendung kann die Fachlogik ohne echte Datenbank mit vorbereiteten Schäden automatisch testen. Dieser Programmteil heißt Repository, auf Deutsch etwa Ablage.

Wie funktioniert es?
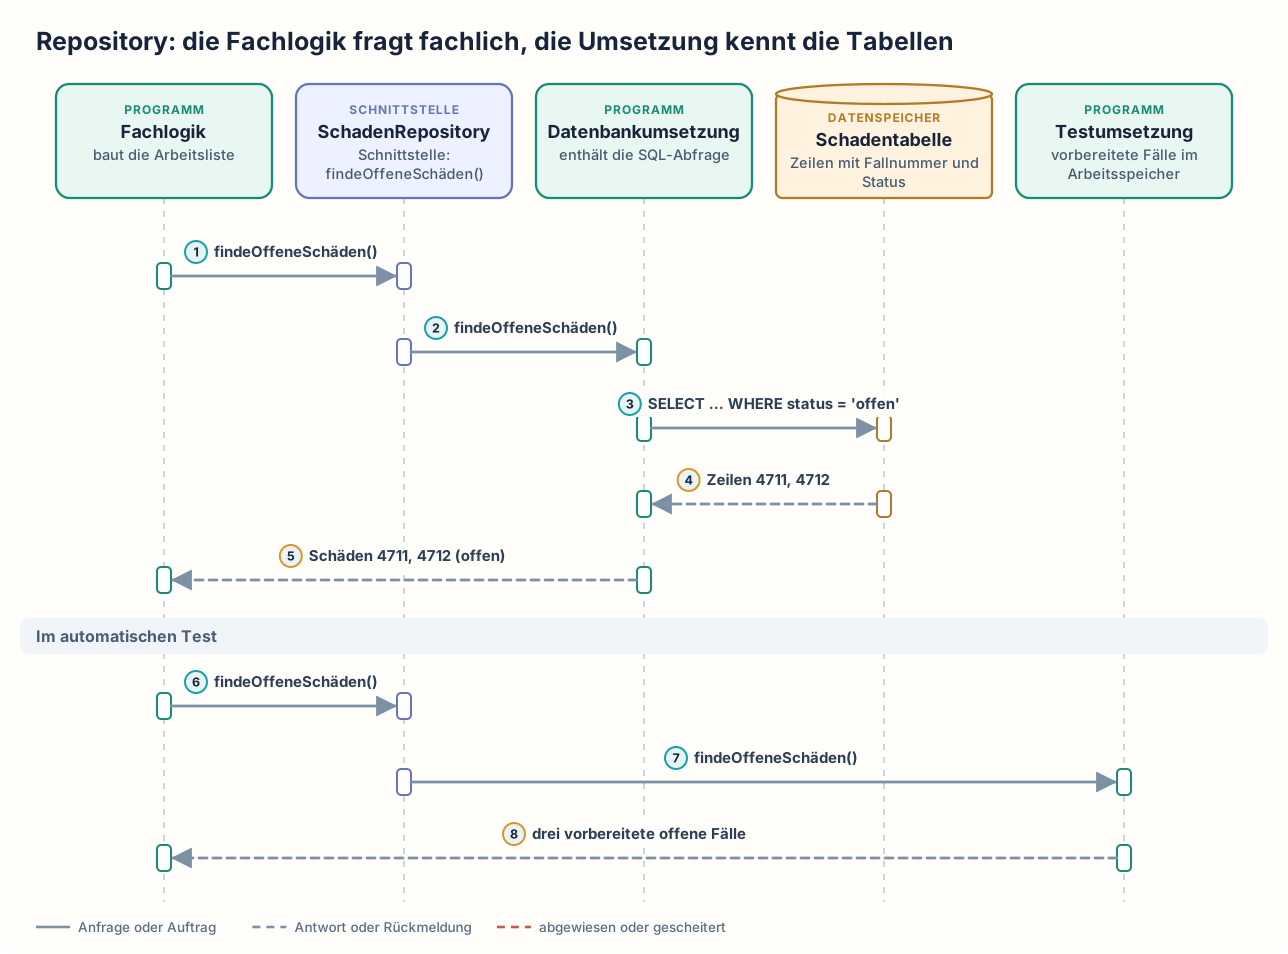
Öffnet die Sachbearbeiterin ihre Arbeitsliste, ruft die Fachlogik die Methode findeOffeneSchäden() des SchadenRepositorys auf, also des Repositorys für Schäden. Im Betrieb geht der Aufruf an die Datenbankumsetzung, den Programmteil mit den Datenbankabfragen. Die Datenbankumsetzung fragt die Schadentabelle in der Datenbank mit der Abfrage SELECT … WHERE status = 'offen' ab. Diese Abfrage ist in SQL geschrieben, der Sprache für Datenbankabfragen. Die Schadentabelle liefert die Zeilen der Fälle 4711 und 4712. Aus den Zeilen baut die Datenbankumsetzung Schadenobjekte, also Datenpakete mit Fallnummer und Status, mit denen die Fachlogik arbeiten kann. Die Fachlogik erhält die Schäden 4711 und 4712 mit dem Status „offen“, und die Arbeitsliste zeigt beide an.
Im automatischen Test ruft die Fachlogik genau dieselbe Methode findeOffeneSchäden() auf. Für den Test hat das Team der Schadenanwendung die Datenbankumsetzung gegen die Testumsetzung ausgetauscht, einen Programmteil, der vorbereitete Fälle im Arbeitsspeicher bereithält. Der Aufruf geht deshalb an die Testumsetzung, und die Testumsetzung liefert drei offene Fälle. Die Fachlogik verarbeitet diese Fälle genauso wie im Betrieb die Schäden aus der Schadentabelle, obwohl keine Datenbank beteiligt ist.
Das Repository besteht aus drei Teilen, die alle das Team der Schadenanwendung schreibt: der Schnittstelle SchadenRepository, der Datenbankumsetzung und der Testumsetzung. Eine Schnittstelle ist eine festgelegte Liste von Methoden mit Namen, Eingaben und Ergebnis, etwa findeOffeneSchäden(). Die Schnittstelle legt fest, was geliefert wird, aber nicht, woher: findeOffeneSchäden() liefert offene Schäden, und ob diese Schäden aus der Schadentabelle oder aus dem Arbeitsspeicher kommen, steht nicht in der Schnittstelle. Das Team legt die Methoden nach den fachlichen Fragen der Fachlogik fest. Die Methoden heißen deshalb zum Beispiel „finde alle offenen Schäden“ oder „offene Schäden eines Kunden“ und nicht „lies Zeilen aus Tabelle X mit Spalte Y gleich Z“. Für die Fachlogik sieht das SchadenRepository aus wie eine Sammlung von Schäden: Die Fachlogik holt Schäden heraus und legt geänderte Schäden zurück. Die Datenbankumsetzung für den Betrieb und die Testumsetzung für den automatischen Test bieten die Schnittstelle an. Sie heißen Umsetzungen, weil sie jede Methode der Schnittstelle tatsächlich ausführen. Nur die Datenbankumsetzung enthält Tabellennamen, Spaltennamen und SQL. Weil die Fachlogik nur die Schnittstelle aufruft, kann das Team die Umsetzung austauschen, ohne die Fachlogik zu ändern.
Findet die Datenbankumsetzung keinen offenen Schaden, gibt sie eine leere Liste zurück. Ist die Datenbank dagegen nicht erreichbar, meldet die Datenbankumsetzung einen Fehler und keine leere Liste. Sonst zeigt die Arbeitsliste der Sachbearbeiterin „keine offenen Schäden“, obwohl die Schäden nur nicht gelesen werden konnten.
Repository: die Fachlogik fragt fachlich, die Umsetzung kennt die Tabellen
Wann ist es sinnvoll und wann nicht?
Ein Repository lohnt sich
- Die Anwendung hat umfangreiche fachliche Regeln, die von der Speichertechnik getrennt bleiben sollen. Ohne Repository steht die Datenbankabfrage direkt in der Fachlogik. Die Regel für die Arbeitsliste enthält dann Tabellennamen, Spaltennamen und SQL-Befehle, und die fachliche Frage „Welche Schäden sind noch offen?“ geht darin unter.
- Die fachlichen Regeln sollen ohne Datenbank automatisch getestet werden. Ohne Repository braucht jeder Test der Fachlogik eine Datenbank mit passenden Testdaten. Vor jedem Test müssen die Testdaten in die Datenbank geschrieben werden, und jeder Test wartet auf die Antworten der Datenbank.
- Die Art der Speicherung ändert sich, ohne dass sich fachlich etwas ändert. Speichert das Team den Status zum Beispiel künftig in einer eigenen Tabelle, ändert das Team nur die Datenbankumsetzung. Die Fachlogik bleibt unverändert, solange die Datenbankumsetzung weiterhin dieselben offenen Schäden mit derselben Bedeutung liefert. Ohne Repository müsste das Team auch die Fachlogik ändern.
- Mehrere Programmteile brauchen dieselbe fachliche Abfrage, zum Beispiel die Abfrage der offenen Schäden. Ohne Repository steht die Abfrage in jedem dieser Programmteile, und bei einer Änderung wird leicht einer davon vergessen. Mit Repository steht sie nur in der Datenbankumsetzung.
Ein Repository ist nicht das Richtige
- Die Anwendung ist klein, zeigt im Wesentlichen Daten aus Tabellen an und hat kaum eigene Regeln. Der zusätzliche Code eines Repositorys lohnt sich dann nicht, weil es kaum Regeln gibt, die getrennt getestet werden müssten. Dann schreibt das Team die Datenbankabfragen direkt in die Anwendung und nutzt dafür eine Datenzugriffsbibliothek, also fertigen Code für Datenbankzugriffe. Schnittstelle, Datenbankumsetzung und Testumsetzung entfallen, und für eine neue Abfrage schreibt das Team nur die Abfrage selbst.
- Es geht um umfangreiche Berichte und Auswertungen, die viele Tabellen verbinden. Über das SchadenRepository müsste die Anwendung dafür erst vollständige Schadenobjekte laden und die Daten der übrigen Tabellen einzeln dazuholen. Dann schreibt das Team für jeden Bericht eine eigene Abfrage außerhalb des Repositorys. Die Abfrage holt die benötigten Spalten aus allen Tabellen mit einem einzigen Befehl. CQRS beschreibt diese Trennung von Änderungen und Abfragen: Änderungen laufen über Repositories, umfangreiche Abfragen für Berichte greifen direkt auf die Datenbank zu.
- Sehr viele Datensätze sollen auf einmal geändert werden. Über das SchadenRepository müsste die Anwendung jedes Schadenobjekt einzeln laden und zurücklegen, bei hunderttausend Schäden also hunderttausendmal. Dann schreibt das Team einen einzigen Änderungsbefehl, etwa „setze alle abgeschlossenen Schäden auf archiviert“, und die Anwendung schickt diesen Befehl an die Datenbank. Die Datenbank ändert alle betroffenen Zeilen in einem Durchgang.
Nachteile und typische Fehler
Für ein Repository schreibt und pflegt das Team zusätzlich eine Schnittstelle und mindestens zwei Umsetzungen. Kommt eine neue fachliche Frage hinzu, müssen Schnittstelle, Datenbankumsetzung und Testumsetzung gemeinsam erweitert werden. Neben den schnellen Tests mit der Testumsetzung braucht das Team einige Tests gegen eine echte Datenbank, denn nur diese Tests zeigen, ob sich die Testumsetzung so verhält wie die Datenbankumsetzung. Das Repository verbirgt außerdem, wie viele Datenbankabfragen der Aufruf einer Methode auslöst und wie lange sie dauern. Das Team muss deshalb Zahl und Dauer der Datenbankabfragen im Betrieb beobachten.
Typische Fehler und woran man sie erkennt:
- Allgemeines Repository: Ein Team baut ein allgemeines Repository, das für alle Arten von Daten nur Speichern, Laden und Löschen anbietet. Fachlich wichtige Abfragen wie „offene Schäden eines Kunden“ entstehen dann außerhalb des Repositorys, und die fachliche Frage ist im Code schwer zu finden. Erkennbar ist das an Abfragebedingungen, die in der Fachlogik zusammengesetzt werden.
- Verborgene Datenbanklast: Die Fachlogik ruft eine Methode des SchadenRepositorys für jeden Schaden der Arbeitsliste einzeln auf, bei tausend Schäden also tausendmal hintereinander, und jeder Aufruf löst eine eigene Datenbankabfrage aus. Im Code der Fachlogik sind diese Abfragen nicht zu sehen, denn dort steht nur ein gewöhnlicher Aufruf des SchadenRepositorys. Erkennbar ist das an Tausenden gleichartigen Abfragen in den Protokollen der Datenbank, sobald jemand die Arbeitsliste öffnet.
- Abweichende Testumsetzung: Die Testumsetzung liefert andere Ergebnisse als die Datenbankumsetzung. In der Schadentabelle steht bei manchen Fällen der Status „Offen“ mit großem Anfangsbuchstaben. Die Abfrage der Datenbankumsetzung sucht nur nach „offen“ und findet diese Fälle nicht. Die Testumsetzung achtet nicht auf Groß- und Kleinschreibung und liefert auch Fälle mit „Offen“. Die Tests bestehen, im Betrieb fehlen Schäden in der Arbeitsliste. Erkennbar ist das an Fehlern im Betrieb, die kein automatischer Test zeigt.
- Datenbankfehler als leere Liste: Die Datenbankumsetzung gibt bei einer gestörten Datenbank eine leere Liste statt eines Fehlers zurück. Sachbearbeiter halten ihre Arbeit dann für erledigt. Erkennbar ist das an leeren Arbeitslisten zur selben Zeit, in der die Datenbank Störungen meldet.
Weiterführend
Verwandte Ansätze
- Unit of Work: sammelt die Änderungen eines Vorgangs und speichert sie gemeinsam in einer einzigen Datenbanktransaktion. Das Repository liefert die Objekte, die Unit of Work schreibt die Änderungen zurück.
- Dependency Injection: setzt beim Start der Anwendung die passende Umsetzung ein, im Betrieb die Datenbankumsetzung und im Test die Testumsetzung.
- Hexagonal Architecture: baut eine ganze Anwendung so auf, dass die Fachlogik nur Schnittstellen kennt. Dort entspricht die Schnittstelle des Repositorys einem Port, also einer fest vereinbarten Schnittstelle der Anwendung. Die Datenbankumsetzung entspricht einem Adapter.
- Domain Driven Design: beschreibt Repositories als Zugang zu fachlichen Objekten und richtet sie nach zusammengehörigen Gruppen von Objekten aus statt nach einzelnen Tabellen.
Quellen
- Edward Hieatt, Rob Mee, Martin Fowler: Repository: Beschreibung des Musters aus dem Buch „Patterns of Enterprise Application Architecture“ von 2002, mit einer Schnittstelle, die für die Fachlogik wie eine Sammlung von Objekten aussieht, und gebündelten Abfragen.
- Microsoft: Design the infrastructure persistence layer: erklärt, wie Repositories die Fachlogik von der Speichertechnik trennen, wie Tests ohne Datenbank mit ausgetauschten Umsetzungen laufen und warum reine Abfragen das Repository umgehen können.