
Serverless Architecture
Rechenleistung bei Bedarf vom Anbieter beziehen
Die Idee und ihr Nutzen
Eine Versicherung möchte Schadenmeldungen ihrer Kunden über das Internet annehmen, ohne dafür eigene Server rund um die Uhr zu betreiben. Sie nutzt dazu die Dienste eines Cloud-Anbieters, also eines Unternehmens, das Rechenzeit und Speicherplatz auf seinen Servern über das Internet vermietet. Das Gateway, ein vom Anbieter betriebenes Programm, nimmt die Meldungen aus dem Internet entgegen. Für jede Meldung startet die Plattform die Schadenfunktion. Die Plattform ist ein Dienst des Anbieters, der Programme anderer Unternehmen bei Bedarf ausführt. Die Schadenfunktion ist ein kleines Programm der Versicherung, das die Meldung prüft und in einer ebenfalls vom Anbieter betriebenen Datenbank speichert. Die Server betreibt der Anbieter, und die Versicherung zahlt meist nur für die tatsächlich genutzte Rechenzeit. Diese Betriebsweise heißt Serverless, auf Deutsch serverlos. Die Server gibt es weiterhin; der Name meint, dass die Versicherung keinen dieser Server selbst einrichtet, aktualisiert oder überwacht.

Wie funktioniert es?
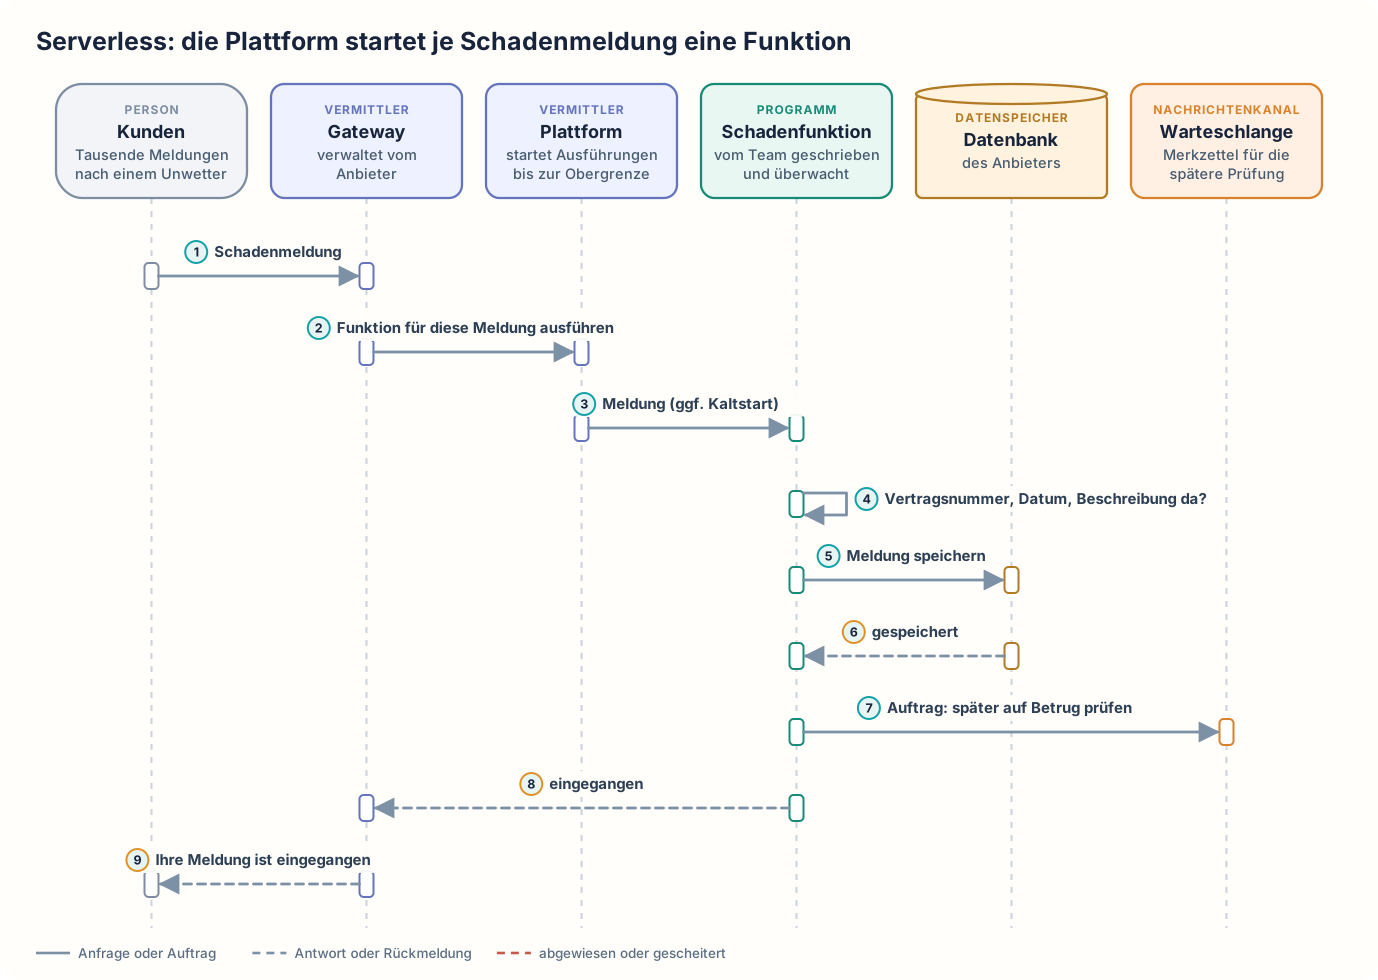
Nach einem Unwetter senden Tausende Kunden innerhalb einer Stunde ihre Schadenmeldungen. Jede Meldung erreicht das Gateway, und das Gateway fordert für jede Meldung bei der Plattform eine Ausführung der Schadenfunktion an. Eine Ausführung ist ein laufendes Exemplar der Schadenfunktion, das eine Meldung bearbeitet. Für jede Ausführung nutzt die Plattform eine schon laufende Ausführungsumgebung oder startet eine neue. Eine Ausführungsumgebung ist ein abgeschotteter Bereich auf einem Server des Anbieters, in dem die Schadenfunktion läuft. Der Start einer neuen Ausführungsumgebung heißt Kaltstart und dauert spürbar länger, als eine laufende zu nutzen. Bei vielen Meldungen lässt die Plattform so viele Ausführungen parallel laufen wie nötig, bis zu einer Obergrenze, die der Anbieter oder das Team der Versicherung festlegt. Jede Ausführung der Schadenfunktion prüft, ob Vertragsnummer, Schadendatum und Beschreibung vorhanden sind, und speichert die Meldung dauerhaft in der Datenbank. Erst wenn die Datenbank „gespeichert“ bestätigt, arbeitet die Schadenfunktion weiter, damit kein Kunde eine Bestätigung für eine Meldung erhält, die nicht gespeichert wurde. Die Schadenfunktion legt dann einen Auftrag für die spätere Betrugsprüfung in die Warteschlange, einen Zwischenspeicher des Anbieters, in dem Aufträge warten, bis ein anderes Programm sie bearbeitet. Der Auftrag ist noch keine Prüfung, sondern nur ein Merkzettel für die Prüfung. Zuletzt meldet die Schadenfunktion dem Gateway „eingegangen“, und der Kunde erhält die Bestätigung „Ihre Meldung ist eingegangen“.
Von den fünf Bausteinen Gateway, Plattform, Schadenfunktion, Datenbank und Warteschlange schreibt die Versicherung nur die Schadenfunktion. Ein solches kleines Programm, das eine Plattform bei Bedarf startet, heißt Funktion. Die übrigen vier Bausteine betreibt der Anbieter. Der Anbieter spielt auch die Aktualisierungen der Betriebssysteme auf seinen Servern ein. Die Plattform beendet Ausführungen wieder, wenn nichts zu tun ist; weitere Server muss niemand von Hand hinzufügen. Das Team der Versicherung überwacht die Schadenfunktion. Das Team legt fest, auf welche Daten und Dienste die Schadenfunktion zugreifen darf, was bei Fehlern geschieht und wie hoch die Kosten höchstens werden dürfen. Ob die Schadenfunktion die Pflichtangaben richtig prüft, verantwortet weiterhin das Team. Weil jede Ausführung nach ihrer Aufgabe endet, muss alles, was erhalten bleiben soll, in der Datenbank oder in der Warteschlange stehen, etwa die Meldung selbst und der Auftrag für die Betrugsprüfung.
Scheitert das Speichern, erhält der Kunde eine Fehlermeldung statt einer Eingangsbestätigung. Ist die Obergrenze erreicht, startet die Plattform keine weiteren Ausführungen. Zusätzliche Meldungen werden dann abgewiesen oder müssen warten, je nachdem, wie Gateway und Plattform eingestellt sind.
Serverless: die Plattform startet je Schadenmeldung eine Funktion
Wann ist es sinnvoll und wann nicht?
Serverless lohnt sich
- Die Menge der Aufgaben schwankt stark. An einem ruhigen Tag kommen wenige Hundert Schadenmeldungen, nach einem schweren Unwetter Zehntausende in wenigen Stunden. Mit eigenen Servern müsste die Versicherung genug Server für die größte denkbare Spitze bereithalten. Diese Server würden an den meisten Tagen fast nichts tun und trotzdem Geld kosten.
- Das Team will keine eigenen Server betreiben. Hält die Versicherung weniger eigene Server vor, als die größte Spitze braucht, muss bei einem Unwetter jemand schnell von Hand weitere Server einrichten, oft nachts oder am Wochenende. Bei Serverless startet die Plattform die zusätzlichen Ausführungen selbst, und der Anbieter spielt die Aktualisierungen der Server ein.
- Die Aufgaben werden durch einzelne Ereignisse oder zu festen Zeiten ausgelöst. Ein solches Ereignis ist etwa eine eingehende Meldung oder eine hochgeladene Datei. Ein ständig laufender Dienst würde zwischen zwei Ereignissen warten und trotzdem bezahlt. Die Plattform startet die Schadenfunktion nur, wenn eine Meldung eingeht.
- Jede Aufgabe ist nach kurzer Zeit erledigt. Die Prüfung und Speicherung einer Schadenmeldung ist eine solche Aufgabe. Die Plattform lässt eine einzelne Ausführung nur bis zu einer Laufzeitgrenze laufen und bricht sie danach ab. Eine Schadenmeldung ist lange vor dieser Grenze geprüft und gespeichert, und das Team muss die Aufgabe nicht in Teile zerlegen.
Serverless ist nicht das Richtige
- Ein Programm rechnet dauerhaft viel oder läuft sehr lange. Dann betreibt das Team das Programm als ständig laufenden Dienst auf gemieteten Servern zu einem festen Monatspreis. Bei Serverless bezahlt die Versicherung jeden Aufruf und jede Sekunde Rechenzeit einzeln, und bei dauerhafter Last liegt diese Summe meist über dem festen Preis der Server. Ein sehr lange laufendes Programm müsste das Team außerdem in Teile zerlegen, die jeweils vor der Laufzeitgrenze fertig werden.
- Über den ganzen Tag gehen gleichmäßig viele Meldungen ein. Serverless spart dann nichts, denn es gibt keine Spitze, für die die Versicherung sonst Server bereithalten müsste, die an anderen Tagen nichts tun. Das Team betreibt deshalb einen ständig laufenden Meldedienst auf gemieteten Servern zu einem festen Monatspreis. Weil die Meldungen gleichmäßig eingehen, sind die Server den ganzen Tag beschäftigt. Kommt doch einmal eine Spitze, startet Autoscaling nach einer Regel weitere Exemplare desselben Meldedienstes und beendet sie danach wieder. Ein neues Exemplar braucht für den Start meist länger als eine Funktion.
- Jede Anfrage muss in sehr kurzer, fest zugesagter Zeit beantwortet werden. Bei Serverless kann ein Kaltstart diese Zeit überschreiten. Dann betreibt das Team die Anwendung als ständig laufenden Dienst auf gemieteten Servern. Jede Anfrage trifft dort auf ein schon gestartetes Programm, und kein Kunde wartet auf einen Kaltstart.
- Die Anwendung darf aus vertraglichen oder rechtlichen Gründen nicht von den Diensten eines einzelnen Anbieters abhängen. Bei Serverless stammen Gateway, Plattform, Datenbank und Warteschlange aber alle vom selben Anbieter. Dann betreibt das Team die Anwendung auf gemieteten Servern und nutzt nur Programme, die auch bei anderen Anbietern laufen, etwa eine gewöhnliche Datenbank statt der Datenbank des Anbieters. Bei einem Wechsel zieht das Team die Anwendung auf die Server des neuen Anbieters um und muss sie nicht an dessen Dienste anpassen.
- Die Anwendung muss im eigenen Rechenzentrum laufen. Bei Serverless läuft sie aber auf den Servern des Anbieters. Dann betreibt die Versicherung im eigenen Rechenzentrum eigene Server und hält so viele bereit, wie die größte erwartete Spitze nach einem Unwetter braucht.
Nachteile und typische Fehler
Jede Plattform setzt Grenzen. Dazu gehören die längste Laufzeit einer Ausführung und die Zahl gleichzeitiger Ausführungen. Die Anwendung hängt stark von einem einzigen Anbieter ab: Gateway, Plattform, Datenbank und Warteschlange stammen alle vom selben Anbieter. Bei einem späteren Wechsel müsste die Versicherung diese vier Dienste beim neuen Anbieter neu einrichten und die Schadenfunktion an dessen Dienste anpassen. Die monatlichen Kosten sind schwerer vorherzusagen als bei fest gemieteten Servern, weil sie pro Aufruf anfallen. Wie teuer und wie schnell die Anwendung ist, hängt stark davon ab, wie oft die Schadenfunktion aufgerufen wird, wie lange der Start einer Ausführung dauert und wie schnell Datenbank und Warteschlange antworten. Auch ohne eigene Server bleibt Betriebsaufwand: Das Team muss vorab prüfen, ob die Obergrenzen der Plattform, die Datenbank, die Warteschlange und das Budget eine Spitze nach einem Unwetter bewältigen.
Typische Fehler und woran man sie erkennt:
- Aufrufe in einer Endlosschleife: Das Team richtet die Plattform so ein, dass jede Änderung in der Datenbank die Schadenfunktion startet, damit geänderte Meldungen erneut geprüft werden. Die Schadenfunktion speichert die geprüfte Meldung wieder in der Datenbank. Diese Änderung startet die Schadenfunktion ein weiteres Mal, und so fort. Dauert eine Ausführung 200 Millisekunden, entstehen so aus einer einzigen Meldung 18.000 Aufrufe in der Stunde, und die Versicherung bezahlt jeden davon. Erkennbar ist das an einer Zahl von Aufrufen, die weit über der Zahl der eingegangenen Meldungen liegt.
- Obergrenze erreicht: Nach dem Unwetter laufen so viele Ausführungen gleichzeitig, wie die Obergrenze erlaubt, und am Gateway treffen weitere Meldungen ein. Die Plattform weist die Anforderungen des Gateways für diese Meldungen ab, und das Gateway schickt den Kunden eine Fehlermeldung. Erkennbar ist das an Hinweisen der Plattform auf abgewiesene Aufrufe und an Kunden, die ihre Meldung mehrfach senden.
- Überlastete Datenbank: Nach dem Unwetter lässt die Plattform zum Beispiel 1.000 Ausführungen gleichzeitig laufen, und jede Ausführung will eine Meldung in der Datenbank speichern. Die Datenbank bearbeitet aber nur 200 Schreibvorgänge gleichzeitig, und die übrigen 800 Ausführungen warten. Wartende Ausführungen erreichen ihre Laufzeitgrenze, und die Plattform bricht sie ab. Die Kunden dieser Meldungen erhalten eine Fehlermeldung statt einer Eingangsbestätigung. Erkennbar ist das an langen Antwortzeiten der Datenbank zur selben Zeit wie die Spitze der Meldungen.
- Verlorener Merkzettel: Das Speichern in der Datenbank und das Einstellen in die Warteschlange gelingen oder scheitern ohne zusätzliche Vorkehrungen unabhängig voneinander. Die Meldung ist gespeichert, aber das Einstellen in die Warteschlange scheitert, und das Programm für die Betrugsprüfung erhält den Auftrag nie. Erkennbar ist das an gespeicherten Meldungen, zu denen keine Betrugsprüfung stattgefunden hat.
- Spürbare Kaltstarts: Die Plattform beendet eine Ausführungsumgebung, in der eine Weile keine Ausführung lief. In der Nacht vergeht zwischen zwei Meldungen oft so viel Zeit, dass die Plattform für fast jede Meldung eine neue Ausführungsumgebung starten muss. Die Kunden dieser Meldungen warten um die Dauer eines Kaltstarts länger auf die Bestätigung. Erkennbar ist das an Antwortzeiten, die bei wenigen Meldungen länger sind als bei mittlerem Andrang.
Weiterführend
Verwandte Ansätze
- Function as a Service: beschreibt die Plattform, die einzelne Funktionen bei Bedarf startet und parallel ausführt. Serverless nutzt diese Plattform zusammen mit weiteren vom Anbieter betriebenen Diensten wie Gateway, Datenbank und Warteschlange.
- Event Driven Architecture: lässt Programme auf gemeldete Ereignisse reagieren. Serverless-Funktionen werden typischerweise durch solche Ereignisse gestartet.
- Stateless Services: beschreibt Dienste, die sich zwischen zwei Anfragen nichts merken. So muss auch die Schadenfunktion gebaut sein.
- Outbox Pattern: Die Schadenfunktion speichert den Auftrag für die Betrugsprüfung zusammen mit der Meldung in der Datenbank, und ein eigenes Programm stellt den Auftrag danach in die Warteschlange. So geht kein Auftrag verloren, wenn das Einstellen in die Warteschlange zunächst scheitert.
Quellen
- Mike Roberts: Serverless Architectures: Artikel auf martinfowler.com von 2018, der Serverless als Kombination von Funktionen auf einer Plattform mit vom Anbieter betriebenen Diensten beschreibt und Vorteile sowie Nachteile wie Anbieterbindung, Kaltstarts und Laufzeitgrenzen erläutert.
- AWS: Understanding Lambda function scaling: Dokumentation von AWS Lambda dazu, wie die Plattform je gleichzeitiger Anfrage eine Ausführungsumgebung bereitstellt oder wiederverwendet, welche Obergrenzen für gleichzeitige Ausführungen gelten und wann Kaltstarts entstehen.