
Canary Release
Eine neue Version zuerst für wenige Nutzer freigeben
Die Idee und ihr Nutzen
Der Schadendienst einer Versicherung nimmt Schadenmeldungen von Kunden an. Das Entwicklungsteam des Schadendienstes hat Version 3.4 mit einer neuen Betrugsprüfung fertiggestellt. Statt alle Schadenmeldungen sofort an die neue Version zu schicken, leitet das Entwicklungsteam zunächst nur 5 von 100 Meldungen an Version 3.4 und die übrigen weiter an die alte Version 3.3. Jede Schadenmeldung geht dafür zuerst an einen Lastverteiler, ein Programm, das die Meldungen auf die beiden Versionen aufteilt. Ein Prüfprogramm vergleicht Fehler und Antwortzeiten beider Versionen. Bleiben Fehler und Antwortzeiten der neuen Version innerhalb festgelegter Grenzen, erhöht das Entwicklungsteam ihren Anteil Schritt für Schritt; überschreitet die neue Version eine Grenze, gehen neue Meldungen wieder nur an die alte Version. Ein Fehler trifft so zunächst nur wenige Kunden. Dieses Vorgehen heißt Canary Release, nach den Kanarienvögeln, die Bergleute früher mitnahmen, weil die Vögel giftiges Gas eher anzeigten, als Menschen es bemerkten.

Wie funktioniert es?
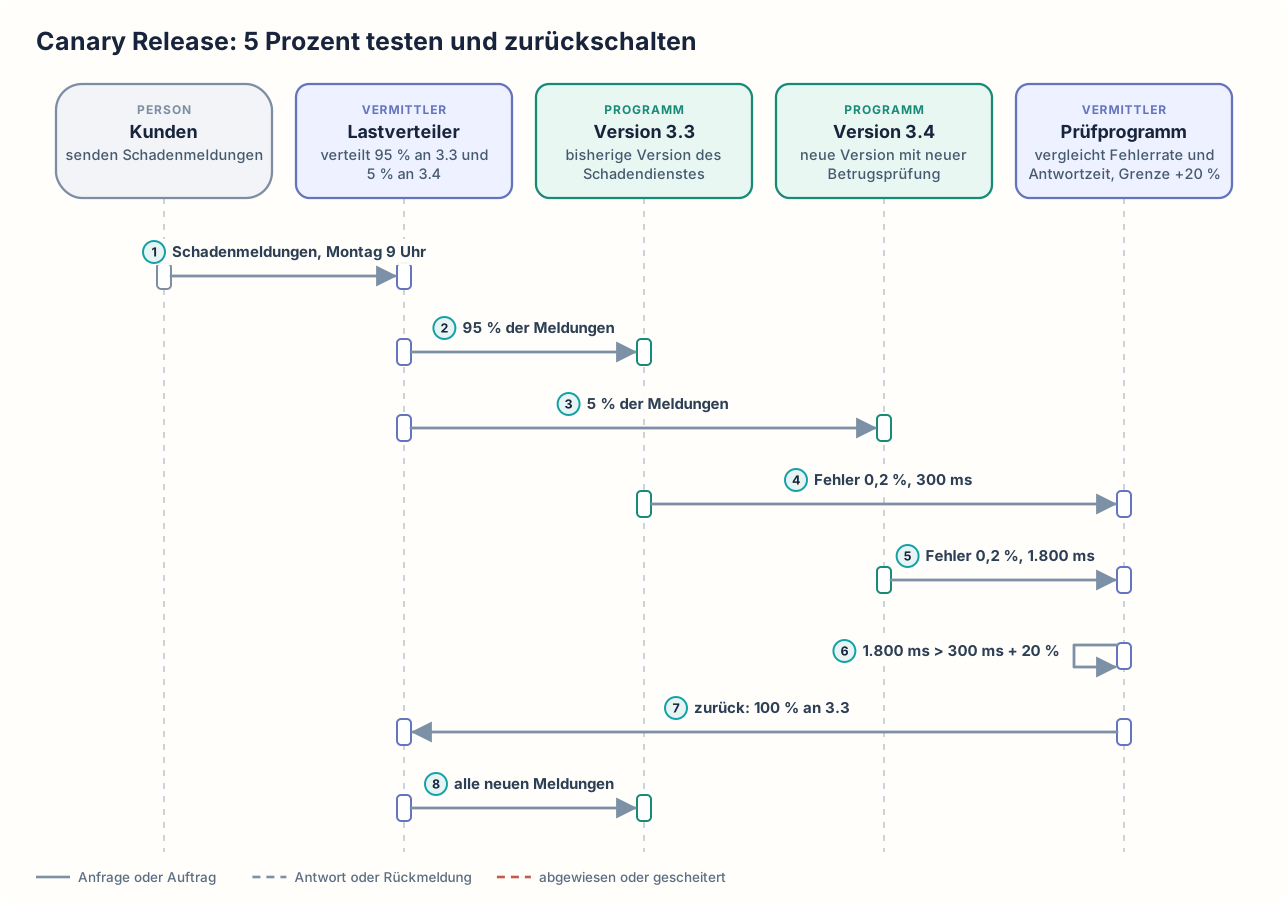
Das Entwicklungsteam startet Version 3.4 zunächst, ohne dass sie Meldungen erhält. Am Montag um 9 Uhr beginnt die Freigabe von Version 3.4: Das Entwicklungsteam stellt den Lastverteiler so ein, dass Version 3.4 nur 5 Prozent der Schadenmeldungen erhält und Version 3.3 die übrigen 95 Prozent. Version 3.4 bekommt also etwa jede zwanzigste Meldung. Ein kleinerer Anteil würde den Vergleich verzögern, ein größerer würde bei einem Fehler mehr Kunden treffen. Der Lastverteiler empfängt alle neuen Schadenmeldungen der Kunden und verteilt sie nach diesen Anteilen. Beide Versionen melden ihre Messwerte an das Prüfprogramm. Version 3.3 meldet eine Fehlerrate von 0,2 Prozent und eine Antwortzeit von 300 Millisekunden. Die Fehlerrate ist der Anteil gescheiterter Anfragen. Version 3.4 hat dieselbe Fehlerrate, braucht für eine Antwort aber durchschnittlich 1.800 Millisekunden, sechsmal so lange. Im Prüfprogramm hat das Entwicklungsteam als Grenze eingestellt, dass die Antwortzeit von Version 3.4 höchstens 20 Prozent über der von Version 3.3 liegen darf. Etwas mehr Zeit für die neue Betrugsprüfung nimmt das Entwicklungsteam hin, denn 360 statt 300 Millisekunden bemerkt ein Kunde beim Absenden einer Meldung nicht. Das Prüfprogramm vergleicht die Werte beider Versionen jeweils nach 30 Minuten. Version 3.4 erhält nur jede zwanzigste Meldung und hat erst nach dieser Zeit so viele Meldungen bearbeitet, dass einzelne langsame Antworten das Ergebnis nicht verfälschen. Nach den ersten 30 Minuten liegt die Antwortzeit von Version 3.4 weit über der Grenze. Das Prüfprogramm bricht die Freigabe von Version 3.4 ab und stellt den Lastverteiler zurück, sodass alle neuen Meldungen wieder an Version 3.3 gehen. Meldungen, die Version 3.4 gerade bearbeitet, dürfen zu Ende laufen, und was Version 3.4 schon gespeichert hat, bleibt bestehen. Version 3.3 ist die ganze Zeit weitergelaufen, und zum Zurückstellen genügt eine geänderte Einstellung am Lastverteiler. Von der langsamen Antwort betroffen sind nur die Kunden, deren Meldungen in diesen 30 Minuten zu Version 3.4 gegangen sind. Das Entwicklungsteam sucht die Ursache in Ruhe, statt unter dem Druck einer Störung für alle Kunden zu arbeiten, und startet später einen neuen Versuch.
Der Lastverteiler ist ein Programm, das jede eingehende Anfrage zuerst annimmt und nach einstellbaren Anteilen an eine der laufenden Versionen weiterleitet. Statt eines Anteils kann der Lastverteiler auch ausgewählte Nutzer zur neuen Version leiten, zum Beispiel die eigenen Mitarbeiter der Versicherung. Meist wird der Lastverteiler so eingestellt, dass ein Kunde während der Freigabe bei derselben Version bleibt. Sonst wechselt ein Kunde beim Ausfüllen einer Schadenmeldung womöglich zwischen beiden Versionen. Das Prüfprogramm vergleicht Kennzahlen beider Versionen: die Fehlerrate, die Antwortzeit und fachliche Werte wie die Zahl abgeschlossener Meldungen. Verglichen wird mit der alten Version zur selben Zeit, weil sich die Werte über den Tag ohnehin ändern. Für jede Kennzahl gibt es eine festgelegte Grenze. Bleiben die Werte der neuen Version innerhalb der Grenzen, steigt ihr Anteil in weiteren Stufen, zum Beispiel erst auf 25, dann auf 50 und schließlich auf 100 Prozent. Ob die Freigabe in die nächste Stufe geht, entscheidet entweder das Entwicklungsteam oder das Prüfprogramm selbst. Entscheidet das Prüfprogramm, prüft es nach jeder Stufe die Kennzahlen gegen die Grenzen und setzt die Freigabe fort oder bricht sie ab.
Das Zurückstellen des Lastverteilers betrifft nur neue Meldungen. Es macht weder Nachrichten rückgängig, die Version 3.4 schon verschickt hat, noch Zahlungen, die Version 3.4 ausgelöst hat.
Canary Release: 5 Prozent testen und zurückschalten
Wann ist es sinnvoll und wann nicht?
Ein Canary Release lohnt sich
- Manche Fehler zeigen sich erst mit echten Kunden, echten Daten und vielen gleichzeitigen Meldungen. Ein Beispiel ist eine neue Prüfung, die bei bestimmten Schadenarten eine langsame Datenbankabfrage auslöst. Im Testsystem fällt die langsame Abfrage nicht auf, weil das Testsystem deutlich weniger Daten enthält als die Produktion, also das System, das echte Kunden nutzen. Ohne Canary Release fällt die langsame Abfrage erst auf, wenn alle Kunden die neue Version nutzen.
- Ein Fehler soll nicht alle Kunden gleichzeitig treffen. Schaltet das Entwicklungsteam die neue Version sofort für alle Kunden frei, haben womöglich schon Tausende Kunden eine fehlerhafte oder sehr langsame Antwort erhalten, bis das Entwicklungsteam den Fehler bemerkt.
- Viele Menschen nutzen das System, sodass schon ein kleiner Anteil der Anfragen aussagekräftige Messwerte liefert.
- Messwerte werden automatisch erhoben und lassen sich nach Version getrennt vergleichen.
Ein Canary Release ist nicht das Richtige
- Es gibt nur wenige Nutzer. Bei 40 Anfragen am Tag erhält die neue Version mit 5 Prozent nur zwei Anfragen, und daraus lässt sich nichts ablesen. Dann gibt das Entwicklungsteam die neue Version für alle Nutzer auf einmal frei und beobachtet selbst die ersten Anfragen. Die Einstellung von Anteilen am Lastverteiler und das Prüfprogramm entfallen.
- Die neue Version speichert Daten in einer Form, die die alte Version nicht lesen kann. Dann stellt das Entwicklungsteam zuerst die Datenbank so um, dass beide Versionen die Daten lesen können, und gibt die neue Version erst danach frei. So scheitert die alte Version nach einem Zurückstellen nicht an den Daten, die die neue Version gespeichert hat.
- Ein Fehler darf auch bei wenigen Kunden nicht auftreten. Ein Beispiel ist eine falsch berechnete Auszahlung. Ein Canary Release begrenzt nur, wie viele Kunden ein Fehler trifft. Dann prüft das Entwicklungsteam die Berechnung vor der Freigabe mit Tests an Fällen, deren richtige Auszahlung bekannt ist. So findet das Entwicklungsteam den Fehler, bevor ein Kunde eine falsche Auszahlung erhält.
- Ein Fehler fällt nach dem Umschalten aller Kunden auf die neue Version schnell auf, und es ist hinnehmbar, dass er bis zum Zurückschalten alle Kunden trifft. Dann nutzt das Entwicklungsteam ein Blue Green Deployment: Die neue Version läuft vollständig in einer zweiten Umgebung, während die alte Version weiterläuft, und das Entwicklungsteam schaltet alle Kunden auf einmal um und bei einem Fehler auf einmal zurück. Die Einstellung von Anteilen am Lastverteiler und das Prüfprogramm entfallen.
- Die Änderung betrifft nur eine einzelne Funktion wie die neue Betrugsprüfung. Dann baut das Entwicklungsteam die Funktion mit einem Feature Toggle ein, einem Schalter im Programm, und schaltet sie nur für einen Teil der Meldungen ein. Eine zweite laufende Version und die Server dafür entfallen.
Nachteile und typische Fehler
Zwei Versionen laufen gleichzeitig. Datenbank, Schnittstellen und Nachrichten müssen zu beiden Versionen passen, und während der Freigabe braucht der Betrieb Server für beide Versionen. Das Verfahren braucht verlässliche Kennzahlen je Version, festgelegte Grenzen und einen Lastverteiler, der Anteile genau einstellen kann. Ein Canary Release findet nur Fehler, die sich während der Freigabe in den gemessenen Kennzahlen zeigen. Eine Freigabe in mehreren Stufen dauert außerdem länger als ein Umschalten aller Kunden auf einmal.
Typische Fehler und woran man sie erkennt:
- Späte Fehler: Ein Fehler tritt erst nach Tagen auf und fällt während einer kurzen Stufe der Freigabe nicht auf. Ein Beispiel ist ein Fehler, der erst beim Monatsabschluss auftritt. Erkennbar ist das an Störungen, die erst lange nach der vollständigen Freigabe gemeldet werden.
- Unbrauchbare Kennzahlen: Das Prüfprogramm vergleicht nur Werte, die sich bei beiden Versionen kaum unterscheiden, oder es gibt keine festgelegten Grenzen. Eine schlechte Version erreicht dann 100 Prozent. Erkennbar ist das an Freigaben, die nie abgebrochen werden, obwohl Kunden sich danach über die neue Version beschweren.
- Wechselnde Version: Der Lastverteiler ordnet jede Anfrage neu zu, und ein Kunde sieht beim Ausfüllen einer Schadenmeldung abwechselnd das Verhalten von Version 3.3 und Version 3.4. Erkennbar ist das an Beschwerden über Angaben, die zwischen zwei Seiten des Meldeformulars verschwinden oder sich ändern.
- Unverträgliche Daten: Beide Versionen speichern in dieselbe Datenbank. Version 3.4 speichert Meldungen in einer Form, die Version 3.3 nicht lesen kann. Nach dem Zurückstellen ruft ein Kunde eine solche Meldung wieder auf. Der Lastverteiler schickt die Anfrage an Version 3.3, und Version 3.3 scheitert an der Meldung. Erkennbar ist das an Fehlern der alten Version, die genau die Meldungen betreffen, die während der Freigabe bei Version 3.4 waren.
- Vergleich mit früher: Das Prüfprogramm vergleicht die neue Version mit Werten der alten Version vom Vortag statt mit Werten zur selben Zeit. Tageszeitliche Schwankungen sehen dann wie Fehler aus oder verdecken sie. Erkennbar ist das an Abbrüchen und Freigaben, die sich bei einer Wiederholung zu einer anderen Tageszeit nicht bestätigen.
Weiterführend
Verwandte Ansätze
- Rolling Deployment: ersetzt die laufenden Exemplare eines Programms nacheinander durch die neue Version, ohne den Anteil der Anfragen gezielt zu steuern.
- Observability: beschreibt, wie Messwerte, Protokolle und Aufzeichnungen einzelner Anfragen über alle beteiligten Dienste erhoben werden. An diesen Daten liest das Entwicklungsteam den Erfolg einer Stufe der Freigabe ab.
Werkzeuge und Umsetzungen
- Argo Rollouts: steuert Freigaben in Stufen und wertet Messwerte automatisch aus. Argo Rollouts läuft in Kubernetes, einer verbreiteten Plattform zum Betrieb von Anwendungen auf vielen Servern.
- Flagger: führt schrittweise Freigaben in Kubernetes automatisch durch und bricht ab, wenn Messwerte die festgelegten Grenzen überschreiten.
- Istio: ein Service Mesh, also zusätzliche Programme, die die Anfragen zwischen Diensten steuern. Istio kann Anfragen nach genauen Prozentanteilen auf zwei Versionen verteilen; die Auswertung der Messwerte übernimmt ein anderes Werkzeug.
- Spinnaker: Plattform für Auslieferungen, die schrittweise Freigaben automatisch auswerten kann.
Quellen
- Danilo Sato: Canary Release: Beitrag von 2014 auf martinfowler.com, der das Vorgehen, die Auswahl der ersten Nutzer, das Zurückleiten und die Grenzen bei Datenbankänderungen beschreibt.
- Google: The Site Reliability Workbook, Chapter 16: Canarying Releases: Kapitel aus dem Buch von Google zum Betrieb großer Systeme. Das Kapitel begründet den gleichzeitigen Vergleich mit der alten Version, die Wahl der Kennzahlen und die Grenzen des Verfahrens.