
Rolling Deployment
Instanzen nacheinander aktualisieren
Die Idee und ihr Nutzen
Das Kundenportal einer Versicherung läuft gleichzeitig als drei gleichartige Exemplare auf drei Servern, Instanz 1, 2 und 3 genannt. Jede Kundenanfrage geht zuerst an einen Lastverteiler, ein Programm, das eingehende Anfragen auf die Instanzen aufteilt. Der Lastverteiler schickt jede Kundenanfrage an eine der Instanzen. Weil alle drei Instanzen dasselbe Programm sind, kann jede von ihnen jede Kundenanfrage beantworten. Das Betriebsteam möchte eine neue Version 2 des Kundenportals einspielen und ersetzt die Instanzen dafür nicht alle auf einmal, sondern nacheinander: zuerst Instanz 1, dann Instanz 2, dann Instanz 3. Die jeweils anderen Instanzen beantworten währenddessen weiter die Anfragen der Kunden. So bleibt das Kundenportal ohne Unterbrechung erreichbar, und ein Fehler in Version 2 trifft zunächst nur eine Instanz. Dieses Vorgehen heißt Rolling Deployment, auf Deutsch etwa rollende Auslieferung. „Rollend“ meint, dass Version 2 eine Instanz nach der anderen erreicht.

Wie funktioniert es?
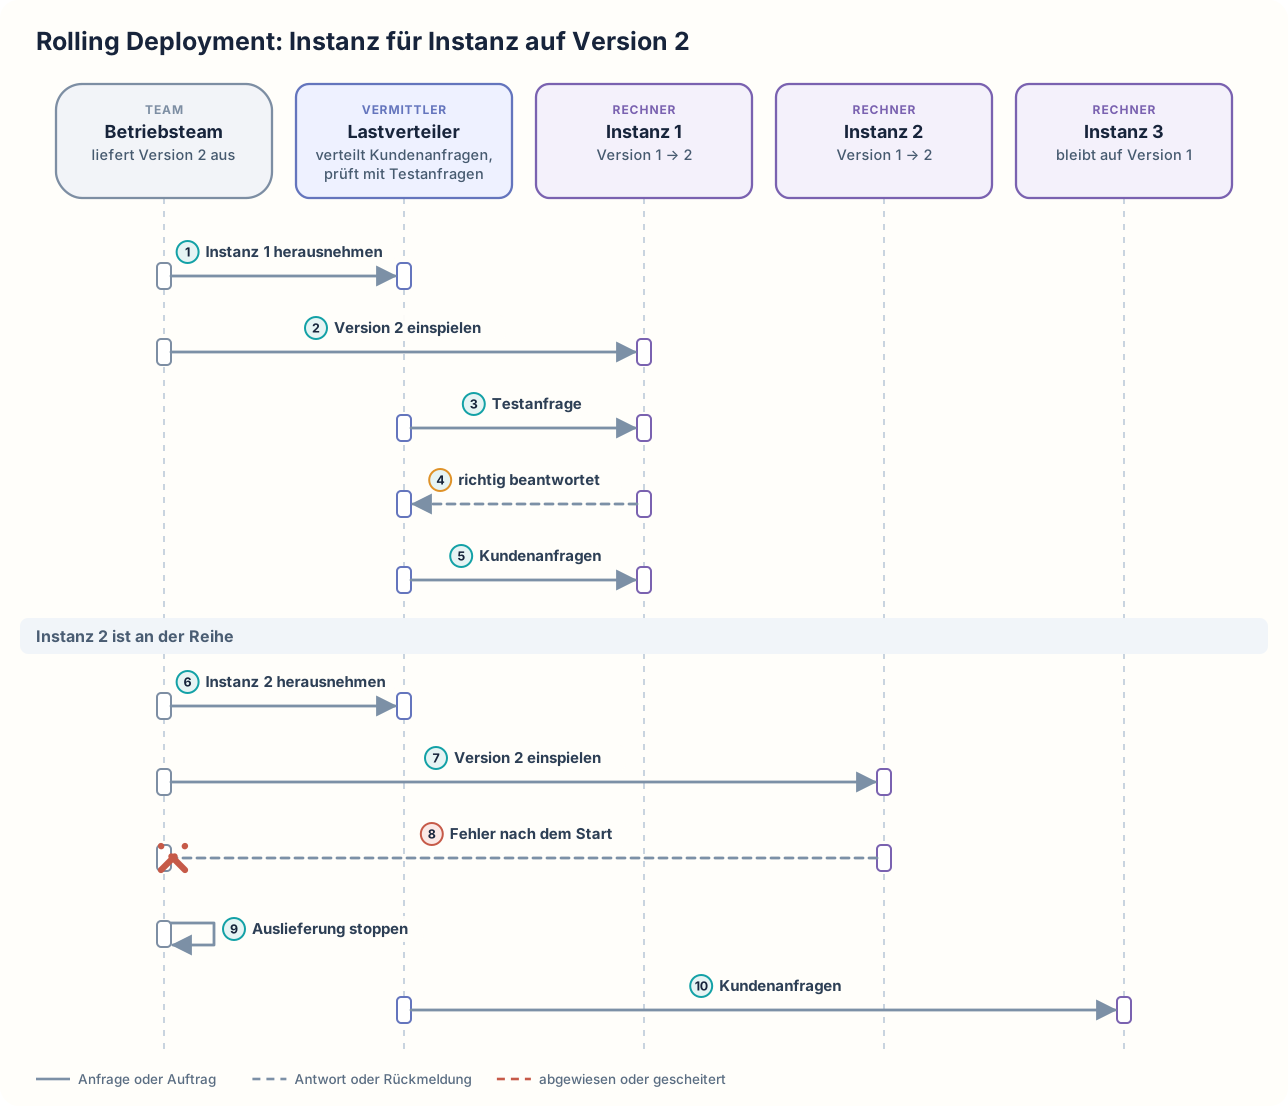
Version 2 des Kundenportals bringt eine neue Darstellung der Schadenakte. Zuerst weist das Betriebsteam den Lastverteiler an, Instanz 1 herauszunehmen: Der Lastverteiler schickt Instanz 1 keine neuen Kundenanfragen mehr. Anfragen, die Instanz 1 gerade bearbeitet, darf sie noch zu Ende führen. Instanz 2 und 3 bedienen die Kunden währenddessen weiter mit Version 1. Das Betriebsteam startet Instanz 1 mit Version 2. Der Lastverteiler schickt Instanz 1 eine Testanfrage, also eine Anfrage, deren richtige Antwort bekannt ist. Instanz 1 beantwortet die Testanfrage richtig und erhält danach wieder Kundenanfragen. Ab jetzt laufen Version 1 und Version 2 nebeneinander. Dann nimmt der Lastverteiler Instanz 2 heraus. Nie fehlt mehr als eine Instanz, und zwei Instanzen müssen in dieser Zeit die Anfragen aller Kunden bewältigen. Das Betriebsteam startet Instanz 2 mit Version 2, doch nach dem Start meldet Instanz 2 Fehler. Das Betriebsteam stoppt die Auslieferung, bevor Instanz 3 an der Reihe ist, und Instanz 3 bedient die Kunden weiter mit Version 1.
Das Betriebsteam steuert die Auslieferung: Es bestimmt die Reihenfolge der Instanzen, spielt die neue Version ein und entscheidet, ob die Auslieferung weitergeht. Herausnehmen, Prüfen und Wiederaufnehmen der Instanzen übernimmt der Lastverteiler. Weil Version 1 und Version 2 eine Zeit lang gleichzeitig laufen, kann ein Kunde mit einer Anfrage bei Version 1 und mit der nächsten bei Version 2 ankommen. Beide Versionen müssen deshalb dieselben gespeicherten Daten lesen können und mit denselben Schnittstellen zu anderen Programmen arbeiten. Eine Schnittstelle ist die vereinbarte Form, in der ein Programm ein anderes aufruft, also der Name des Aufrufs, die übergebenen Angaben und die Art der Antwort. Braucht Version 2 eine Änderung am Aufbau der Datenbank, muss diese Änderung so gestaltet sein, dass Version 1 weiter funktioniert. Eine neue Spalte in einer Tabelle der Datenbank wird dann zum Beispiel zunächst nur hinzugefügt, und keine alte Spalte wird entfernt.
Ob das Betriebsteam Instanz 1 und 2 nach dem Fehler auf Version 1 zurücksetzen kann, hängt davon ab, ob Daten und Schnittstellen noch zur alten Version passen. Hat Version 2 zum Beispiel bereits Daten in einem neuen Format gespeichert, reicht es nicht, Version 1 wieder einzuspielen, denn Version 1 kann diese Daten nicht lesen. Das Zurücksetzen auf Version 1 ist selbst eine weitere rollende Auslieferung und kein sofortiges Umschalten.
Rolling Deployment: Instanz für Instanz auf Version 2
Wann ist es sinnvoll und wann nicht?
Ein Rolling Deployment lohnt sich
- Eine Anwendung läuft in mehreren gleichartigen, austauschbaren Instanzen, und ein Lastverteiler verteilt die Anfragen auf diese Instanzen. Würde das Betriebsteam alle drei Instanzen gleichzeitig anhalten, die neue Version einspielen und wieder starten, könnte in dieser Zeit kein Kunde das Kundenportal nutzen. Je nach Umfang der Aktualisierung dauert das einige Minuten.
- Ein Fehler in der neuen Version soll auffallen, solange erst ein Teil der Instanzen sie hat. Würde das Betriebsteam alle Instanzen gleichzeitig umstellen, träfe ein Fehler in Version 2 sofort alle Kunden.
- Die verbleibenden Instanzen können die Anfragen eine Weile allein bewältigen. Beim Kundenportal reichen dafür zwei von drei Instanzen, denn das Betriebsteam hat die Instanzen so bemessen, dass zwei von ihnen auch zu den Tageszeiten mit den meisten Anfragen alle Kunden bedienen.
- Version 1 und Version 2 können für die Dauer der Auslieferung mit denselben Daten und Schnittstellen arbeiten. Ein Kunde kann dann mit einer Anfrage bei Version 1 und mit der nächsten bei Version 2 ankommen, ohne dass eine Anfrage scheitert.
- Es sollen keine zusätzlichen Server nötig sein. Ohne Rolling Deployment müsste das Betriebsteam für eine Auslieferung ohne Unterbrechung drei weitere Instanzen auf drei weiteren Servern starten. Mit Rolling Deployment kommt das Betriebsteam mit den drei vorhandenen Servern aus.
Ein Rolling Deployment ist nicht das Richtige
- Es läuft nur eine einzige Instanz. Dann gibt es keine Instanz, die während der Aktualisierung die Anfragen übernimmt. Ist eine kurze Wartungspause hinnehmbar, hält das Betriebsteam die Instanz an und startet sie mit der neuen Version neu. Ein Lastverteiler und weitere Instanzen sind dafür nicht nötig.
- Die neue Version braucht eine Datenbankänderung, mit der die alte Version nicht mehr arbeiten kann, und die Änderung lässt sich nicht auf mehrere Auslieferungen verteilen. Während eines Rolling Deployments würden Kundenanfragen an Instanzen mit Version 1 an der geänderten Datenbank scheitern. Dann hält das Betriebsteam alle Instanzen in einer angekündigten Wartungspause an, ändert die Datenbank und startet alle Instanzen mit der neuen Version.
- Ein Fehler in der neuen Version darf keinen einzigen Kunden erreichen, und ein sofortiges Zurückschalten auf die alte Version ist Pflicht. Beim Rolling Deployment erreicht ein Fehler schon mit der ersten Instanz Kunden, und das Zurücksetzen ist selbst eine rollende Auslieferung. Dann wählt das Betriebsteam ein Blue Green Deployment. Das Betriebsteam startet neben den drei Instanzen mit Version 1 drei weitere Instanzen mit Version 2. Das Betriebsteam prüft diese drei Instanzen, bevor ein Kunde sie erreicht. Danach schaltet das Betriebsteam am Lastverteiler alle Kunden auf einmal auf Version 2 um. Zeigt sich doch ein Fehler, schaltet das Betriebsteam alle Kunden ebenso auf einmal auf Version 1 zurück, und kein Kunde sieht zwei Versionen nebeneinander. Dafür braucht das Betriebsteam während der Auslieferung sechs statt drei Server.
- Das Betriebsteam will eine neue Version zuerst an wenigen Kunden beobachten. Dann wählt das Betriebsteam ein Canary Release: Der Lastverteiler schickt zunächst nur einen kleinen Teil der Anfragen an die neue Version. Ein Fehler trifft so nur wenige Kunden. Beim Rolling Deployment mit drei Instanzen erreicht Version 2 dagegen schon mit der ersten Instanz etwa ein Drittel der Anfragen.
Nachteile und typische Fehler
Während der Auslieferung fehlt zeitweise eine Instanz. Die übrigen Instanzen müssen deshalb so ausgelegt sein, dass sie alle Kunden bedienen können, oder das Betriebsteam startet vorübergehend eine zusätzliche Instanz. Damit Version 1 und Version 2 während des Übergangs dieselben Daten lesen und schreiben können, verteilt das Betriebsteam eine Änderung am Aufbau der Datenbank oft auf mehrere Auslieferungen. Eine erste Auslieferung fügt zum Beispiel eine neue Spalte hinzu, und erst eine spätere Auslieferung entfernt die alte Spalte, wenn keine Instanz mehr mit Version 1 läuft. Kunden können während der Auslieferung abwechselnd die alte und die neue Darstellung der Schadenakte sehen. Jede Instanz beendet vor dem Anhalten ihre laufenden Anfragen, und bei vielen Instanzen summieren sich diese Wartezeiten zu einer langen Auslieferung.
Typische Fehler und woran man sie erkennt:
- Zu früh angehaltene Instanz: Das Betriebsteam hält eine Instanz an, bevor sie ihre laufenden Anfragen beendet hat. Diese Anfragen brechen ab, und Kunden sehen trotz mehrerer Instanzen eine Fehlermeldung. Erkennbar ist das an Fehlermeldungen, die genau beim Herausnehmen einer Instanz auftreten.
- Unverträgliche Datenänderung: Instanz 1 mit Version 2 speichert eine Schadenakte in einem neuen Format, das Version 1 nicht lesen kann. Die nächste Anfrage zu dieser Schadenakte schickt der Lastverteiler an Instanz 3 mit Version 1. Instanz 3 scheitert beim Lesen der Schadenakte. Auch ein Zurücksetzen auf Version 1 hilft nicht, denn die Schadenakte bleibt im neuen Format gespeichert. Erkennbar ist das an Lesefehlern, die nur auf Instanzen mit Version 1 auftreten.
- Überlastete Instanzen: Solange eine Instanz herausgenommen ist, verteilt der Lastverteiler alle Kundenanfragen auf die zwei verbleibenden Instanzen. Jede der beiden erhält dann die Hälfte statt eines Drittels der Anfragen, also anderthalbmal so viele wie sonst. Sind die Instanzen dafür nicht ausgelegt, antworten sie langsamer. Erkennbar ist das an langen Antwortzeiten, die mit jeder herausgenommenen Instanz beginnen und nach ihrer Rückkehr enden.
- Unzureichende Testanfrage: Die Testanfrage prüft nur, ob eine Instanz überhaupt antwortet, nicht ob die Antwort richtig ist. Instanz 1 zeigt mit Version 2 die Schadenakte fehlerhaft an, antwortet aber auf die Testanfrage. Der Lastverteiler schickt Instanz 1 deshalb wieder Kundenanfragen, und das Betriebsteam nimmt sich die nächste Instanz vor. Erkennbar ist das an Fehlern bei Kunden, obwohl alle Instanzen als bereit gelten.
- Nicht gestoppte Auslieferung: Das Betriebsteam lässt die Auslieferung als festgelegten Ablauf über alle drei Instanzen laufen, ohne nach jeder Instanz zu prüfen. Instanz 2 meldet nach dem Start Fehler. Trotzdem nimmt der Lastverteiler auch Instanz 3 heraus, und Instanz 3 erhält Version 2. Erkennbar ist das an Fehlern, die mit jeder aktualisierten Instanz zunehmen.
Weiterführend
Verwandte Ansätze
- Feature Toggles: trennen die Auslieferung des Codes von der Freigabe einer Funktion. Damit lässt sich die neue Darstellung der Schadenakte erst einschalten, wenn alle Instanzen Version 2 haben.
- Health Checks: beschreiben die Testanfragen, mit denen der Lastverteiler feststellt, ob eine Instanz bereit ist.
- Load Balancing: beschreibt den Lastverteiler, der Instanzen aus der Verteilung nimmt und wieder aufnimmt.
Quellen
- Kubernetes: Update a Deployment Without Downtime: offizielle Anleitung zur rollenden Aktualisierung, bei der neue Instanzen die alten schrittweise ersetzen, mit Einstellungen für den Ablauf sowie Anhalten und Zurücksetzen einer Auslieferung.
- AWS: Rolling deployments: Abschnitt aus dem Leitfaden Overview of Deployment Options on AWS, der das schrittweise Ersetzen beschreibt und darauf hinweist, dass alte und neue Version nicht voneinander getrennt laufen und ein Zurücksetzen dadurch schwieriger wird.