
Client Server
Anfragen an einen zentralen Anbieter
Die Idee und ihr Nutzen
Sachbearbeiter einer Versicherung in Köln, Hamburg und München öffnen die Schadenanwendung in ihrem Webbrowser. Der Browser zeigt die Liste der offenen Schäden und schickt Eingaben wie eine Freigabe weiter. Gespeichert und geprüft werden die Schäden aber nicht vom Browser, sondern vom Serverdienst, einem Programm im Rechenzentrum. So arbeiten alle Sachbearbeiter mit demselben Datenbestand und denselben Regeln. Diese Aufteilung heißt Client Server. Der Browser ist dabei der Client: Er stellt Anfragen und zeigt Antworten an. Der Serverdienst ist der Server: Er beantwortet die Anfragen, prüft die verbindlichen Regeln, etwa bis zu welchem Betrag ein Sachbearbeiter einen Schaden freigeben darf, und speichert die Daten.

Wie funktioniert es?
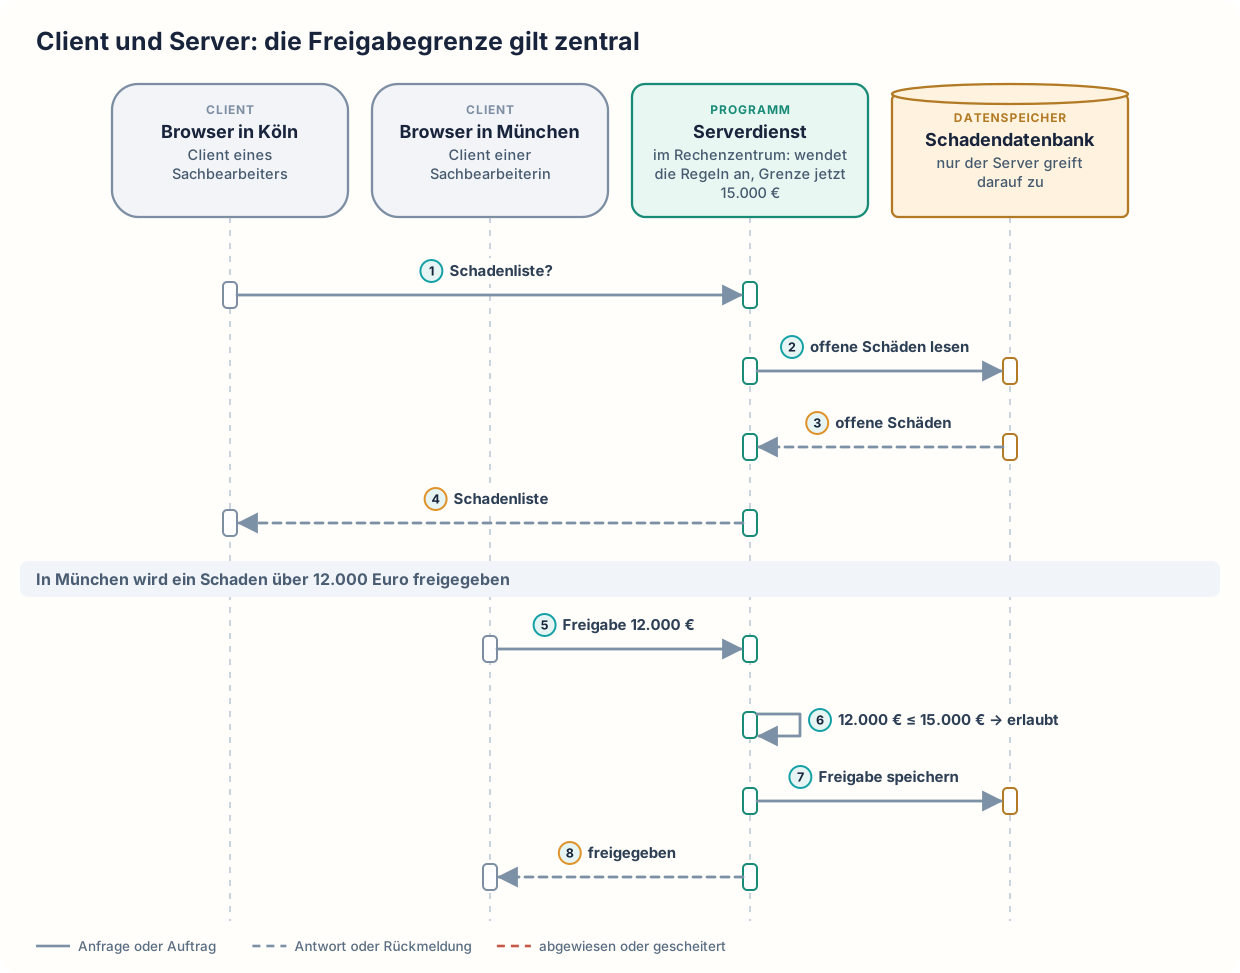
Morgens öffnet ein Sachbearbeiter in Köln die Schadenliste. Der Browser in Köln schickt dazu eine Anfrage an den Serverdienst im Rechenzentrum. Der Serverdienst liest die offenen Schäden aus der Schadendatenbank und schickt die Liste an den Browser in Köln, der sie anzeigt. Fragt der Browser einer Sachbearbeiterin in Hamburg an, erhält er dieselbe Liste. Später gibt eine Sachbearbeiterin in München einen Schaden über 12.000 Euro frei. Der Browser in München schickt die Freigabe an den Serverdienst. Der Serverdienst prüft den Betrag gegen die Freigabegrenze, die er für die Benutzerrolle der Sachbearbeiterin gespeichert hat. Diese Freigabegrenze liegt seit dieser Woche bei 15.000 Euro statt bisher 10.000 Euro, die Freigabe ist also erlaubt. Der Serverdienst speichert die Freigabe in der Schadendatenbank und schickt das Ergebnis an den Browser in München, der „freigegeben“ anzeigt. Die neue Grenze von 15.000 Euro musste nur einmal im Serverdienst geändert werden und galt sofort für alle Standorte.
Auf die Schadendatenbank greift nur der Serverdienst zu, kein Browser. Ein Client kann statt eines Webbrowsers auch eine App oder ein Programm auf dem Arbeitsplatzrechner sein. Die Arbeitsplatzrechner sind über das Firmennetz mit dem Rechenzentrum verbunden. Rechner und Browser am Arbeitsplatz bedient der jeweilige Nutzer; das Rechenzentrum mit Serverdienst und Schadendatenbank betreibt die Versicherung selbst. In der Grundform beginnt immer der Client den Austausch: Er fragt, der Server antwortet. Es gibt auch Formen, in denen der Server den Client von sich aus benachrichtigt, etwa bei einer neuen Aufgabe. Wie viel der Client selbst erledigt, ist unterschiedlich. Manche Clients zeigen nur an, was der Server liefert. Andere prüfen Eingaben schon selbst, damit der Nutzer schneller eine Rückmeldung erhält. Ein Beispiel ist die Prüfung, ob ein Pflichtfeld ausgefüllt ist. Verbindliche Entscheidungen trifft aber auch dann der Server, weil der Nutzer den Client in der Hand hat und verändern kann, den Server aber nicht. Client und Server sind außerdem Rollen, keine festen Rechner. Der Server kann seinerseits Client eines anderen Servers sein: Liest der Serverdienst die offenen Schäden aus der Schadendatenbank, ist er der Client und die Schadendatenbank der Server.
Liegt der Betrag über der Freigabegrenze, lehnt der Serverdienst die Freigabe ab und speichert nichts. Bleibt die Antwort des Serverdienstes aus, etwa weil das Netz kurz unterbrochen ist, kann der Browser nicht feststellen, ob die Freigabe gespeichert wurde. Der Browser darf dann weder „freigegeben“ noch „abgelehnt“ anzeigen. Den tatsächlichen Stand erfährt die Sachbearbeiterin erst, wenn der Browser ihn erneut beim Serverdienst abfragt.
Client und Server: die Freigabegrenze gilt zentral
Wann ist es sinnvoll und wann nicht?
Client Server lohnt sich
- Viele Menschen bearbeiten gemeinsame Daten. Das ist in nahezu allen Geschäftsanwendungen so. Hätte jeder Sachbearbeiter das Programm und eine eigene Kopie der Daten auf seinem Rechner, würden die Kopien schnell voneinander abweichen. Was in Köln freigegeben wurde, wäre in Hamburg nicht bekannt.
- Eine Regel wie die Freigabegrenze ändert sich, und die Änderung soll sofort an allen Standorten gelten. Ohne zentralen Server müsste jede Regeländerung auf jeden einzelnen Rechner verteilt werden. Solange das nicht überall geschehen ist, gälten an verschiedenen Arbeitsplätzen verschiedene Regeln.
- Regeln sollen zentral durchgesetzt werden. Eine Freigabe über der Grenze lehnt der Serverdienst ab, auch wenn jemand die Prüfung im Browser umgeht. Prüfte nur der Browser die Grenze, könnte jemand mit einem veränderten Browser einen Schaden über der Grenze freigeben.
- Daten sollen zentral gesichert werden. Die Schadendaten werden im Rechenzentrum gesichert, nicht auf jedem Arbeitsplatzrechner. Lägen die Daten auf den Arbeitsplatzrechnern, müsste jeder Rechner einzeln gesichert werden, und mit einem defekten Rechner gingen seine ungesicherten Daten verloren.
Client Server ist nicht das Richtige
- Nutzer arbeiten oft ohne Netzverbindung. Ein Beispiel sind Außendienstmitarbeiter beim Kunden auf dem Land. In der Grundform kann der Client ohne Netz weder Schäden laden noch eine Änderung an den Serverdienst schicken. Dann speichert der Client, etwa eine App auf dem Gerät des Außendienstmitarbeiters, eine eigene Kopie der benötigten Schäden. Der Außendienstmitarbeiter arbeitet mit dieser Kopie, und die App gleicht die Änderungen mit dem Serverdienst ab, sobald wieder eine Netzverbindung besteht. Erst beim Abgleich prüft der Serverdienst verbindlich, ob zum Beispiel eine Freigabe unter der Freigabegrenze liegt. Für den Abgleich braucht es außerdem Regeln für den Fall, dass zwei Personen denselben Schaden zwischenzeitlich verschieden geändert haben.
- Kein einzelner Betreiber soll oder darf alle Daten halten. Ein Beispiel ist ein Verbund mehrerer Firmen, in dem keine Firma die Daten der anderen speichern darf. Ein Server nach Client Server müsste aber die Daten aller Firmen halten, und sein Betreiber hätte damit alle Daten. Stattdessen arbeiten gleichberechtigte Rechner der Firmen nach Peer to Peer direkt miteinander, und jede Firma behält ihre Daten auf ihren eigenen Rechnern.
Nachteile und typische Fehler
Alle Anfragen laufen beim Serverdienst zusammen. Mehrere Exemplare desselben Serverdienstes können die Last verteilen und den Ausfall eines einzelnen Exemplars abfangen. Das geht, weil alle Exemplare dieselbe Schadendatenbank nutzen und deshalb jedes Exemplar jede Anfrage beantworten kann. Dafür muss auch die Schadendatenbank die Anfragen aller Exemplare schnell genug beantworten, und das Firmennetz muss die Anfragen aller Standorte übertragen können. Ohne Netzverbindung zum Serverdienst kann der Browser keine Schadenliste anzeigen und keine Freigabe speichern. Ein Ausfall des Rechenzentrums oder des Netzes trifft deshalb alle Standorte gleichzeitig. Prüft der Client Regeln zusätzlich selbst, müssen diese Prüfungen mit denen des Servers übereinstimmen. Jede Regeländerung bedeutet dann zwei Änderungen, eine an der verbindlichen Prüfung im Serverdienst und eine an der Vorabprüfung im Browser. Zeigt der Browser etwa einen Hinweis zur Freigabegrenze an, muss auch dieser Hinweis angepasst werden.
Typische Fehler und woran man sie erkennt:
- Abweichende Prüfung im Browser: Der Browser prüft die Freigabegrenze vorab selbst, aber mit einem anderen Wert als der Serverdienst, zum Beispiel mit 20.000 Euro statt 15.000 Euro. Der Browser lässt dann eine Freigabe über 18.000 Euro zu. Der Serverdienst lehnt diese Freigabe danach ab, und die Sachbearbeiterin versteht nicht, warum. Erkennbar ist das an Ablehnungen durch den Serverdienst bei Eingaben, die der Browser zuvor als zulässig angezeigt hat.
- Vertrauen in den Client: Verlässt sich der Server auf eine Prüfung im Browser, kann ein Angreifer die Prüfung umgehen, indem er Anfragen direkt an den Server schickt. Erkennbar ist das an Freigaben über der Grenze in der Schadendatenbank.
- Überlasteter Server: Es läuft nur ein Exemplar des Serverdienstes, und alle Anfragen aller Standorte treffen auf dieses Exemplar. Morgens öffnen die Sachbearbeiter in Köln, Hamburg und München fast gleichzeitig die Schadenliste. Kommen mehr Anfragen an, als das Exemplar gleichzeitig bearbeiten kann, warten die übrigen Anfragen, bis eine laufende Anfrage fertig ist. Erkennbar ist das an langen Antwortzeiten an allen Standorten gleichzeitig.
- Doppelte Freigabe: Der Serverdienst speichert eine Freigabe, aber seine Antwort an den Browser geht unterwegs verloren. Der Browser meldet einen Fehler, und die Sachbearbeiterin gibt den Schaden erneut frei. Der Serverdienst speichert daraufhin eine zweite Freigabe zum selben Schaden. Erkennbar ist das an zwei Freigaben zum selben Schaden im Abstand weniger Sekunden.
Weiterführend
Verwandte Ansätze
- Layered Architecture: gliedert den Serverdienst intern weiter, etwa in Oberflächenlogik, Fachlogik und Datenzugriff.
- Load Balancing: verteilt die Anfragen vieler Clients auf mehrere Exemplare des Serverdienstes.
- REST: verbreiteter Stil, nach dem Clients und Server im Web ihre Anfragen und Antworten gestalten.
Beispiele zur Einordnung
Client Server ist die Grundform fast aller Anwendungen, die über ein Netz arbeiten.
- PostgreSQL: Datenbankserver. Programme wie der Serverdienst arbeiten mit ihm als Clients.
- NGINX und Apache HTTP Server: Webserver, die Anfragen von Browsern beantworten.
- Mozilla Firefox: Webbrowser, der als Client für Webanwendungen dient.
Quellen
- Roy T. Fielding: Architectural Styles and the Design of Network-based Software Architectures, Kapitel 3: Dissertation, die Client Server als häufigsten Architekturstil für Anwendungen im Netz beschreibt und ihn mit der Trennung der Zuständigkeiten begründet.
- IETF: RFC 9110, HTTP Semantics: Standard des Webs, der Client und Server als Rollen für eine bestimmte Verbindung festlegt; dasselbe Programm kann auf einer Verbindung Client und auf einer anderen Server sein.