
REST
Ressourcen mit einheitlichen Befehlen über HTTP ansprechen
Die Idee und ihr Nutzen
Ein Kunde öffnet im Kundenportal seiner Versicherung den Schadenfall 4711. Das Kundenportal fragt die Daten des Falls bei der Versicherung ab, und zwar über die feste Adresse /schaeden/4711, die genau diesen einen Fall bezeichnet. Die Antwort enthält den aktuellen Stand „in Prüfung“. Der Abruf folgt Regeln für Schnittstellen, also für die festgelegte Form, in der Programme im Netz einander Anfragen schicken und Antworten erhalten. Jedes Ding, auf das man zugreifen kann, bekommt eine eigene Adresse, etwa jeder Schadenfall und jeder Vertrag. Alle Zugriffe verwenden dieselben wenigen Befehle, zum Beispiel GET zum Abrufen. Jede Anfrage bringt alle Angaben mit, die zu ihrer Bearbeitung nötig sind, auch den Nachweis, dass der Kunde angemeldet ist. So können viele verschiedene Programme nach denselben Regeln auf die Schadenfälle zugreifen. Diese Regeln heißen REST, eine Abkürzung für Representational State Transfer, auf Deutsch etwa Übertragung eines Zustands in einer Darstellung. Der Name meint: Die Antwort überträgt den aktuellen Stand von Fall 4711 in einem vereinbarten Textformat.

Wie funktioniert es?
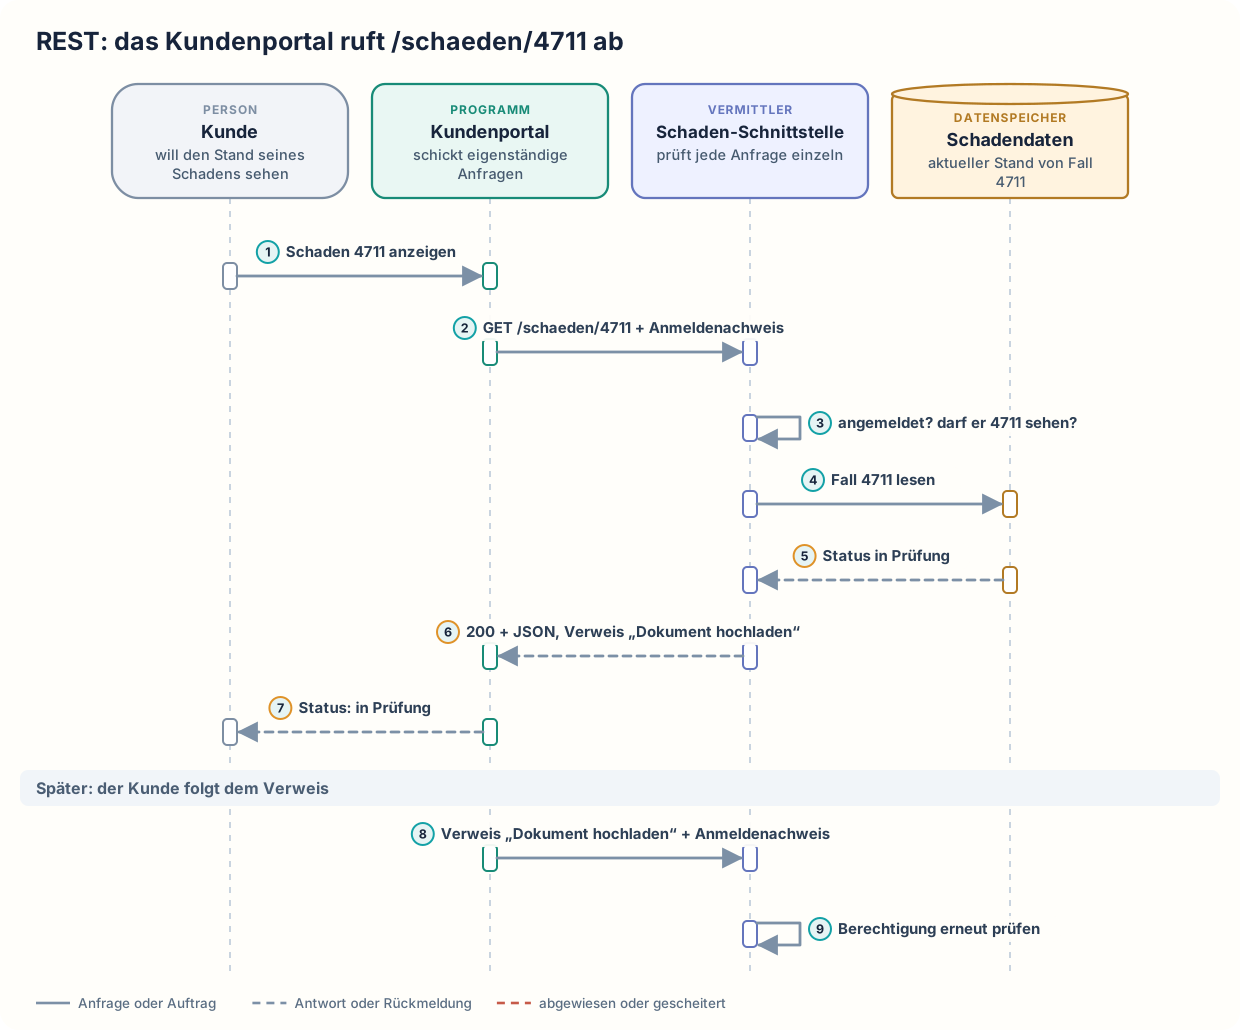
Der Kunde öffnet im Kundenportal seinen Schadenfall 4711. Das Kundenportal schickt die Anfrage GET /schaeden/4711 an die Schaden-Schnittstelle, das Programm auf dem Server der Versicherung, das die Schadenfälle anbietet. GET ist der Befehl zum Abrufen. Mit der Anfrage schickt das Kundenportal den Anmeldenachweis des Kunden mit, einen Beleg dafür, dass sich der Kunde angemeldet hat. Die Schaden-Schnittstelle prüft zuerst, ob der Kunde angemeldet ist und ob er Fall 4711 sehen darf, denn es könnte der Fall eines anderen Kunden sein. Danach liest die Schaden-Schnittstelle die Fallnummer 4711 und den Status „in Prüfung“ aus den Schadendaten, der Datenbank mit den Schadenfällen. Die Schaden-Schnittstelle antwortet mit dem Code 200 für Erfolg und einer Darstellung des Falls in JSON, einem weit verbreiteten Textformat. Die Darstellung enthält neben Fallnummer und Status einen Verweis „Dokument hochladen“ als mögliche Folgeaktion. Das Kundenportal zeigt dem Kunden den Status an. Später wählt der Kunde den Verweis „Dokument hochladen“ aus. Das Kundenportal folgt dem Verweis, statt die Adresse selbst zusammenzusetzen, und schickt dafür eine neue, eigenständige Anfrage mit dem Anmeldenachweis. Die Schaden-Schnittstelle prüft die Berechtigung erneut, denn ein Verweis in einer Antwort ist für sich noch keine Erlaubnis.
Der Informatiker Roy Fielding hat REST im Jahr 2000 als Architekturstil beschrieben. Ein Architekturstil ist eine Sammlung von Regeln, nach denen verteilte Systeme aufgebaut werden können, also Systeme aus mehreren Programmen, die über ein Netz zusammenarbeiten. REST ist kein Produkt. Nach diesen Regeln ist jeder Schadenfall eine Ressource, also ein Ding mit eigener Adresse wie /schaeden/4711. Für alle Ressourcen gelten dieselben wenigen Befehle. Beim Übertragungsverfahren HTTP, das auch Webbrowser nutzen, sind das zum Beispiel:
GETruft eine Ressource ab.PUTersetzt eine Ressource.POSTlegt eine neue Ressource an oder löst einen Vorgang aus.DELETElöscht eine Ressource.
Um eine zulässige Änderung an einem Fall anzustoßen, nutzt das Kundenportal statt GET einen der anderen Befehle, etwa POST zum Hochladen eines Dokuments. Die Antwort mit dem aktuellen Stand in einem vereinbarten Format wie JSON heißt Darstellung der Ressource. Der Zahlencode in der Antwort gibt an, ob die Anfrage gelungen ist. Zwischen zwei Anfragen merkt sich die Schaden-Schnittstelle nicht, was der Aufrufer vorher getan hat. Sie weiß zum Beispiel nicht, welche Seite der Kunde zuvor geöffnet hatte. Deshalb bringt jede Anfrage den Anmeldenachweis mit. Diese Regel betrifft nur den sogenannten Sitzungszustand, also das Wissen über frühere Anfragen desselben Aufrufers. Die Schadenfälle bleiben in den Schadendaten gespeichert.
Die Schaden-Schnittstelle bietet die Ressourcen an. Das Kundenportal, die App der Versicherung für Mobiltelefone und das Programm einer Partnerwerkstatt rufen die Ressourcen mit denselben Adressen und Befehlen ab. Welche Dinge eigene Ressourcen werden und wie die Adressen heißen, legt REST nicht fest. Das entscheidet das Team, das die Schaden-Schnittstelle entwickelt. Von dieser Entscheidung hängt ab, ob die Schaden-Schnittstelle für die Aufrufer verständlich ist. Eine Adresse wie /schaeden/4711 verstehen die Entwickler einer Partnerwerkstatt ohne Erklärung. REST legt auch nicht fest, wer welchen Fall sehen darf. Die Prüfung der Berechtigung muss die Schaden-Schnittstelle selbst durchführen. Ob eine Schnittstelle REST folgt, hängt davon ab, welche Regeln von REST sie tatsächlich umsetzt. Dass eine Schnittstelle HTTP nutzt und Daten in JSON liefert, macht sie allein noch nicht zu einer Schnittstelle im Sinne von REST.
Ist der Kunde nicht angemeldet oder darf er den angefragten Fall nicht sehen, antwortet die Schaden-Schnittstelle mit einem Fehlercode statt mit einer Darstellung. Gibt es den angefragten Fall nicht, antwortet sie mit dem Code 404 für „nicht gefunden“.
REST: das Kundenportal ruft /schaeden/4711 ab
Wann ist es sinnvoll und wann nicht?
REST lohnt sich
- Eine Schnittstelle läuft über HTTP, und die Daten lassen sich gut als einzelne Dinge mit eigener Adresse beschreiben. Ein Beispiel sind einzelne Schadenfälle. Ohne REST erfindet das Team der Schaden-Schnittstelle für jeden Zugriff einen eigenen Aufruf, obwohl
GET /schaeden/4711den Abruf von Fall 4711 schon vollständig beschreibt. - Viele unterschiedliche, unabhängig entwickelte Programme greifen zu. Bei der Versicherung greifen das Kundenportal, die App und Programme von Partnerwerkstätten zu. Bietet die Schaden-Schnittstelle ohne REST für jeden Zweck einen eigenen Aufruf wie
holeSchadenFürPortalundladeSchadendatenMobilan, müssen Kundenportal und App jeden dieser Aufrufe einzeln kennen. Jede Änderung an der Schaden-Schnittstelle zieht dann Änderungen in beiden Programmen nach sich. - Neue Programme sollen sich ohne lange Einarbeitung anbinden lassen. Das Programm einer Partnerwerkstatt nutzt dieselben Befehle wie alle anderen Aufrufer und erhält für einen fehlenden Fall denselben Zahlencode 404. Die Entwickler der Partnerwerkstatt müssen deshalb keine lange Liste von Sonderaufrufen und eigenen Fehlermeldungen lernen.
- Adressen sollen sich ändern können, ohne dass die Aufrufer angepasst werden. Setzt das Kundenportal die Adresse für das Hochladen von Dokumenten selbst zusammen, muss das Team des Kundenportals das Kundenportal bei jeder Änderung dieser Adresse anpassen. Folgt das Kundenportal dem Verweis in der Antwort, muss es nicht geändert werden, wenn das Team der Schaden-Schnittstelle die Adresse ändert.
- Die Schaden-Schnittstelle soll auf mehreren Servern gleichzeitig laufen. Jedes laufende Exemplar der Schaden-Schnittstelle heißt Instanz. Merkt sich eine Instanz frühere Anfragen eines Kunden, muss jede weitere Anfrage dieses Kunden an dieselbe Instanz gehen. Weil bei REST jede Anfrage ihren Anmeldenachweis mitbringt, kann jede Instanz sie beantworten, ohne frühere Anfragen zu kennen.
REST ist nicht das Richtige
- Eine interne Funktion ist eine Handlung und kein Zugriff auf ein Ding. Ein Beispiel ist „berechne den Auszahlungsbetrag für diese Angaben“. Mit REST müsste das Team die Berechnung als Ressource mit eigener Adresse beschreiben, obwohl die Berechnung kein gespeichertes Ding ist. Dann ruft das aufrufende Programm die Funktion als Remote Procedure Call auf, also so, als läge die Funktion im eigenen Programm, und übergibt ihr die Angaben. Eine Adresse für die Berechnung entfällt.
- Die Startseite der App braucht Daten aus sehr vielen Ressourcen gleichzeitig. Mit REST schickt die App für jede Ressource eine eigene Anfrage, und jede einzelne Anfrage verlängert die Ladezeit. Dann bietet das Team der Schaden-Schnittstelle zusätzlich eine Abfragesprache wie GraphQL an. Mit GraphQL beschreibt die App in einer einzigen Anfrage, welche Angaben sie braucht, und erhält alle Angaben in einer einzigen Antwort. Die vielen einzelnen Anfragen nacheinander entfallen.
- Das Programm einer Partnerwerkstatt soll eine Meldung erhalten, sobald sich der Status eines Schadenfalls ändert. Mit REST müsste das Programm der Partnerwerkstatt in kurzen Abständen
GET /schaeden/4711schicken, und die meisten Antworten enthielten keinen neuen Stand. Dann veröffentlicht das Programm, das die Änderung speichert, jede Änderung nach Publish Subscribe, und jedes angemeldete Programm erhält eine Kopie. Die vielen Anfragen ohne neuen Stand entfallen.
Nachteile und typische Fehler
Jede Anfrage muss ihren Anmeldenachweis mitschicken, und die Schaden-Schnittstelle muss ihn jedes Mal prüfen. Das braucht bei jeder Anfrage etwas Zeit, die eine Schnittstelle mit gespeichertem Sitzungszustand nicht bräuchte. Das Team der Schaden-Schnittstelle muss außerdem seine Regeln für Ressourcen, Adressen und Fehlermeldungen über alle Teile der Schaden-Schnittstelle einheitlich halten, etwa alle Schadenfälle unter /schaeden/ anbieten und jede Fehlermeldung im selben Aufbau ausgeben. Ändert sich eine Darstellung, müssen alle Programme, die sie lesen, damit umgehen können.
Typische Fehler und woran man sie erkennt:
- Verweis als Erlaubnis: Die Schaden-Schnittstelle prüft die Berechtigung nur bei
GET /schaeden/4711und nicht bei der Adresse zum Hochladen, die sie als Verweis „Dokument hochladen“ ausgibt. Ein Kunde ersetzt in dieser Adresse die Fallnummer durch die Nummer eines fremden Falls. Danach schickt der Kunde ein Dokument mit seinem eigenen Anmeldenachweis an diese Adresse, und die Schaden-Schnittstelle nimmt das Dokument für den fremden Fall an. Erkennbar ist das an Zugriffen auf Fälle, die nicht zum Anmeldenachweis passen. - Fehler im Erfolgscode: Die Schaden-Schnittstelle antwortet bei einem Fehler mit dem Code 200 und schreibt den Fehler nur in den Text der Antwort. Programme, die sich auf den Zahlencode verlassen, halten die Anfrage für gelungen. Erkennbar ist das an Anzeigen mit leeren oder unvollständigen Daten ohne Fehlermeldung.
- Uneinheitliche Adressen: Ein Teil der Schaden-Schnittstelle nutzt
/schaeden/4711, ein anderer/getSchaden?id=4711, und Fehlermeldungen sehen überall anders aus. Neue Partner müssen dann jeden Teil der Schaden-Schnittstelle einzeln kennenlernen, obwohl alle Teile HTTP nutzen. Erkennbar ist das an vielen Rückfragen neuer Partner und an Sonderbehandlungen in deren Programmen. - Zu viele kleine Anfragen: Die Startseite der App braucht Daten aus vielen Ressourcen und schickt dafür Dutzende Anfragen nacheinander. Sind es 30 Anfragen und dauert jede 100 Millisekunden, wartet der Kunde drei Sekunden auf die Startseite. Erkennbar ist das an langen Ladezeiten, obwohl jede einzelne Anfrage schnell beantwortet wird.
- Sitzungszustand in der Schaden-Schnittstelle: Die Schaden-Schnittstelle merkt sich doch, welche Seite der Kunde zuvor geöffnet hat, und erwartet die nächste Anfrage bei derselben Instanz. Geht die Anfrage an eine andere Instanz, fehlt dort der gespeicherte Sitzungszustand. Erkennbar ist das an Fehlern, die nur auftreten, wenn mehrere Instanzen der Schaden-Schnittstelle laufen.
Weiterführend
Verwandte Ansätze
- Client Server: teilt die Arbeit zwischen einem Programm, das anfragt, und einem Programm, das Daten hält und prüft. REST setzt diese Aufteilung voraus.
- Stateless Services: beschreibt Dienste, die sich zwischen Anfragen keinen Sitzungszustand merken. REST verlangt genau das.
- Token Based Authentication: erklärt einen verbreiteten Anmeldenachweis, den jede Anfrage an eine REST-Schnittstelle mitschicken kann.
- API Gateway: nimmt Anfragen von außen an einer Adresse an und leitet sie an die zuständigen Schnittstellen weiter, häufig an REST-Schnittstellen.
Quellen
- R. Fielding, M. Nottingham, J. Reschke: RFC 9110, HTTP Semantics: Standard der IETF, der die Befehle wie
GET,PUT,POSTundDELETEund Zahlencodes wie 200 und 404 festlegt, auf denen REST-Schnittstellen über HTTP aufbauen. - Martin Fowler: Richardson Maturity Model: erklärt stufenweise, wie eine Schnittstelle über Ressourcen, einheitliche Befehle mit Zahlencodes und Verweise auf nächste Schritte zu REST im Sinne von Roy Fielding wird.