
Remote Procedure Call
Entfernte Funktion wie eine lokale aufrufen
Die Idee und ihr Nutzen
Der Schadendienst einer Versicherung, also das Programm für die Bearbeitung von Schäden, muss für Fall 4711 berechnen lassen, welchen Betrag die Versicherung erstattet. Diese Berechnung führt ein anderes Programm aus, der Leistungsdienst, der auf einem anderen Rechner läuft. Der Schadendienst ruft in seinem eigenen Programmcode die Funktion berechneLeistung auf, als wäre diese Funktion ein Teil des Schadendienstes. Eine Funktion ist ein benannter Programmteil, der eine bestimmte Aufgabe erledigt; berechneLeistung berechnet den Erstattungsbetrag. In Wirklichkeit nimmt ein Stellvertreter den Aufruf entgegen, ein Programmteil im Schadendienst selbst. Der Stellvertreter schickt den Aufruf als Anfrage über das Netzwerk an den Leistungsdienst und wartet auf die Antwort. Das Team des Schadendienstes muss dafür weder Netzwerkverbindungen öffnen noch die Angaben selbst in eine Nachricht umwandeln. Ein solcher Aufruf heißt Remote Procedure Call, auf Deutsch entfernter Funktionsaufruf, weil die aufgerufene Funktion auf einem anderen Rechner läuft.

Wie funktioniert es?
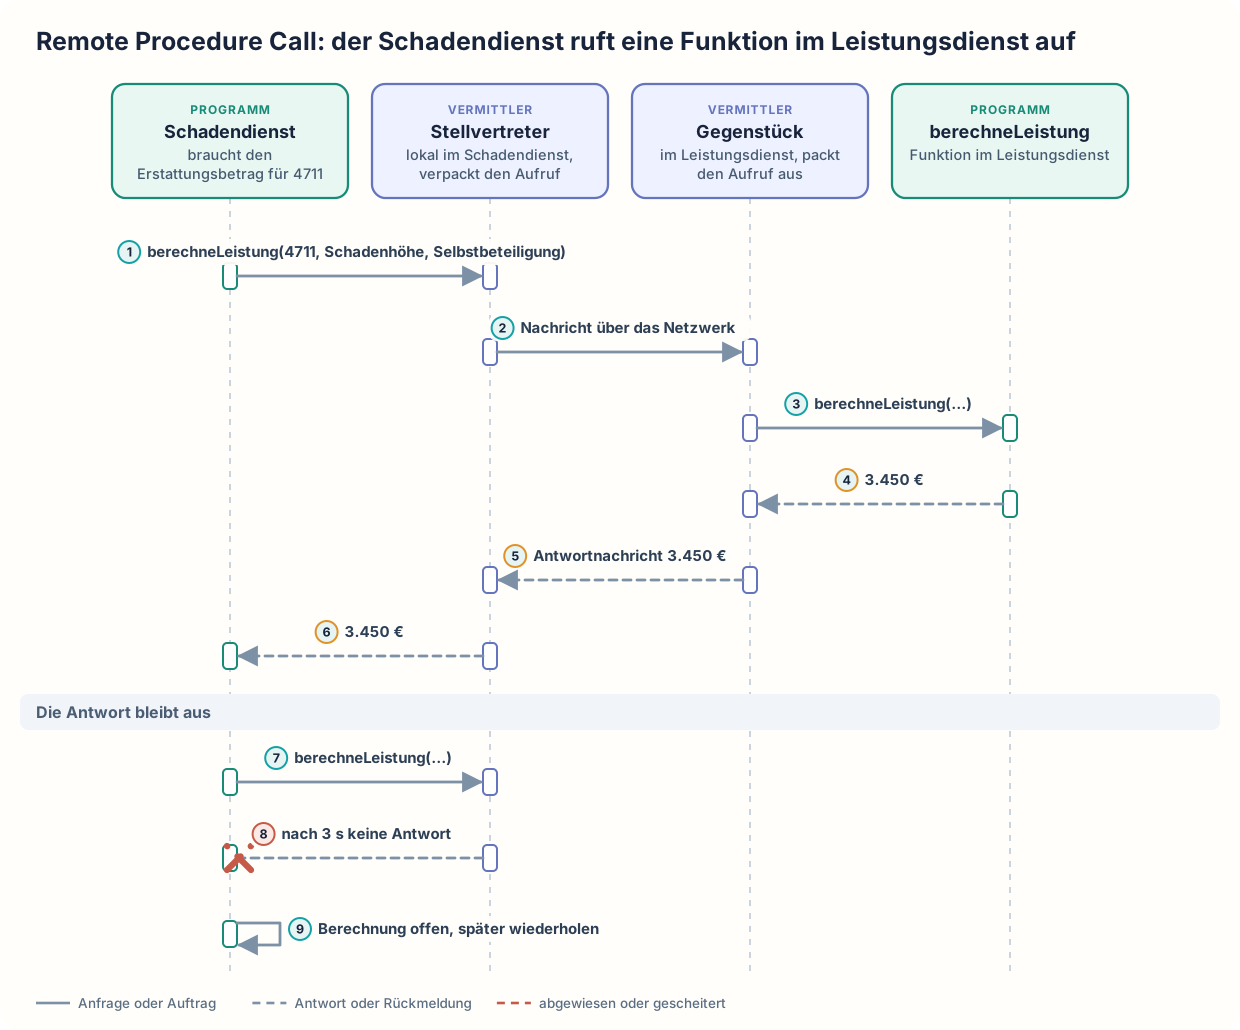
Der Schadendienst hat für Fall 4711 bereits geprüft, dass der Vertrag den Schaden abdeckt, und braucht nun den Erstattungsbetrag. Der Schadendienst ruft beim Stellvertreter berechneLeistung auf, übergibt die Fallnummer 4711, die Schadenhöhe und die Selbstbeteiligung und wartet höchstens drei Sekunden. Der Leistungsdienst antwortet gewöhnlich in weniger als einer halben Sekunde; drei Sekunden lassen ihm auch bei hoher Last genug Zeit, ohne dass die Bearbeitung von Fall 4711 lange stockt. Der Stellvertreter wandelt Funktionsname und Angaben in eine Nachricht um und schickt die Nachricht über das Netzwerk an das Gegenstück, einen Programmteil im Leistungsdienst. Das Gegenstück wandelt die Nachricht zurück und ruft die eigentliche Funktion berechneLeistung auf. Die Funktion ermittelt einen Erstattungsbetrag von 3.450 Euro. Das Gegenstück schickt den Betrag als Antwortnachricht über das Netzwerk an den Stellvertreter zurück, und der Stellvertreter übergibt den Betrag an den Schadendienst, der bis dahin gewartet hat. Bei einem anderen Aufruf von berechneLeistung ist die Netzwerkverbindung gestört. Nach drei Sekunden ohne Antwort meldet der Stellvertreter dem Schadendienst, dass die Zeitgrenze abgelaufen ist. Der Schadendienst weiß nicht, ob die Anfrage den Leistungsdienst erreicht hat. Der Schadendienst trägt nicht 0 Euro ein, denn das wäre die fachliche Aussage „die Versicherung zahlt nichts“, obwohl nur die Verbindung gestört war. Stattdessen markiert der Schadendienst die Berechnung als offen und wiederholt den Aufruf später. Weil berechneLeistung nur rechnet und nichts speichert, ist diese Wiederholung gefahrlos.
Die Teams beider Dienste vereinbaren vorab eine Schnittstelle, also eine Liste der Funktionen mit ihren Eingaben und Ergebnissen. Hier legt die Schnittstelle fest, dass berechneLeistung Fallnummer, Schadenhöhe und Selbstbeteiligung erhält und einen Betrag oder eine Fehlermeldung zurückgibt. Der Leistungsdienst bietet die Funktion an, und der Schadendienst ruft sie über den Stellvertreter auf. RPC ist die übliche Abkürzung für Remote Procedure Call. Ein RPC-Werkzeug wie gRPC liest die vereinbarte Schnittstelle und erzeugt daraus den Programmcode für den Stellvertreter im Schadendienst und für das Gegenstück im Leistungsdienst. Die Regeln für die Berechnung des Erstattungsbetrags pflegt allein das Team des Leistungsdienstes.
Bleibt eine Antwort aus, kann der Leistungsdienst ausgefallen sein, langsam antworten oder die Berechnung erledigt haben, während die Antwort im Netzwerk verloren geht. RPC garantiert also nicht, dass ein Aufruf ankommt oder genau einmal ausgeführt wird. Ein Aufruf, der eine Zahlung anlegt, darf deshalb nicht ohne Schutz gegen doppelte Ausführung wiederholt werden. Hat das aufgerufene Programm die erste Anfrage schon ausgeführt, entsteht die Zahlung doppelt.
Remote Procedure Call: der Schadendienst ruft eine Funktion im Leistungsdienst auf
Wann ist es sinnvoll und wann nicht?
Ein Remote Procedure Call lohnt sich
- Der Aufrufer braucht für einen einzelnen Schritt sofort ein Ergebnis, und die Antwort ist in kurzer Zeit zu erwarten. Beispiele sind eine Berechnung wie
berechneLeistungoder eine Abfrage. Ohne entfernten Aufruf müsste der Schadendienst die Berechnung als Nachricht abschicken und Fall 4711 bis zur Antwort zurückstellen. Mit RPC erhält der Schadendienst den Betrag von 3.450 Euro im laufenden Vorgang und kann Fall 4711 ohne Unterbrechung weiterbearbeiten. - Zwei Programme verschiedener Teams sollen über eine fest vereinbarte Schnittstelle zusammenarbeiten, und der Code für die Übertragung soll aus dieser Vereinbarung erzeugt werden. Ohne RPC-Werkzeug schreibt jedes der beiden Teams den Code zum Umwandeln der Nachrichten selbst, und eine Abweichung zwischen beiden Fassungen fällt erst auf, wenn Aufrufe scheitern. Die Schnittstelle legt Eingaben und Ergebnis eindeutig fest, sodass beide Teams wissen, was sie einander schicken.
- Fachliche Regeln sollen nur in einem Programm gepflegt werden. Würde der Schadendienst die Regeln für den Erstattungsbetrag selbst ausführen, müssten beide Teams dieselben Regeln doppelt pflegen.
- Die aufgerufene Funktion lässt sich gefahrlos wiederholen, oder Wiederholungen werden durch eine eindeutige Auftragskennung abgesichert. Das aufgerufene Programm erkennt eine wiederholte Anfrage dann an ihrer Kennung und führt sie nicht ein zweites Mal aus. Nach einer abgelaufenen Zeitgrenze kann der Aufrufer den Aufruf dann wiederholen, ohne dass etwas doppelt geschieht, wie der Schadendienst bei
berechneLeistung.
Ein Remote Procedure Call ist nicht das Richtige
- Ein Vorgang dauert Minuten oder Tage. Ein Beispiel ist ein Gutachten zu Fall 4711. Mit einem entfernten Aufruf müsste der Schadendienst so lange auf die Antwort warten, und die Zeitgrenze von drei Sekunden wäre längst abgelaufen. Dann legt der Schadendienst den Auftrag als Nachricht auf einer Nachrichtenplattform ab, wie es Messaging beschreibt, und arbeitet an anderen Fällen weiter. Die Antwort holt der Schadendienst ab, sobald sie eingetroffen ist.
- Der Aufrufer muss auch dann weiterarbeiten, wenn der aufgerufene Dienst gerade nicht erreichbar ist. Ein entfernter Aufruf würde in diesem Fall scheitern. Dann schickt der Aufrufer den Auftrag als Nachricht in eine Warteschlange und arbeitet sofort weiter. Die Nachricht bleibt in der Warteschlange, bis der aufgerufene Dienst wieder erreichbar ist und die Nachricht abholt.
- Viele verschiedene Programme, die die beiden Teams nicht kennen, sollen Schadendaten abrufen. Ein Beispiel sind Partner außerhalb der Versicherung. Mit RPC müsste jeder Partner aus der vereinbarten Schnittstelle einen eigenen Stellvertreter erzeugen und ihn nach jeder Änderung der Schnittstelle neu erzeugen. Dann bietet das Team des Schadendienstes die Schadendaten über eine Schnittstelle nach REST an. Die Programme der Partner rufen die Schadendaten mit denselben Befehlen ab, mit denen auch ein Webbrowser Seiten abruft. Einen Stellvertreter, den ein RPC-Werkzeug erst aus einer vereinbarten Schnittstelle erzeugen muss, brauchen die Partner nicht.
Nachteile und typische Fehler
Ein Aufruf über das Netzwerk dauert immer länger als ein Aufruf innerhalb desselben Programms. Weil der entfernte Aufruf im Code wie ein lokaler aussieht, übersehen Entwickler leicht, dass er abbrechen oder ohne Antwort enden kann. Deshalb legt das Team des Schadendienstes für jeden entfernten Aufruf eine Zeitgrenze fest, außerdem, ob und wie oft der Aufruf wiederholt werden darf und wie eine doppelt ausgeführte Änderung verhindert wird. Der Schadendienst ist während des Aufrufs an den Leistungsdienst gebunden: Ist der Leistungsdienst langsam, wird auch der Schadendienst langsam. Ändern lässt sich die gemeinsame Schnittstelle nur, wenn beide Teams sich abstimmen. Die RPC-Werkzeuge, die den Code für Stellvertreter und Gegenstück erzeugen, laufen beim Erstellen beider Programme mit. Beide Teams müssen deshalb Versionen dieser Werkzeuge verwenden, die zueinander passen.
Typische Fehler und woran man sie erkennt:
- Fehlende Antwort als Ergebnis: Der Schadendienst trägt nach abgelaufener Zeitgrenze 0 Euro ein. Erkennbar ist das an Fällen mit 0 Euro Erstattung, die zeitlich mit Netzstörungen zusammenfallen.
- Keine Zeitgrenze: Der Schadendienst wartet unbegrenzt auf den Leistungsdienst. Ist der Leistungsdienst gestört, hängen alle Bearbeitungen, die einen Betrag brauchen. Erkennbar ist das an sich stauenden, nie beendeten Aufrufen im Schadendienst.
- Doppelte Änderung durch Wiederholung: Der Schadendienst ruft eine entfernte Funktion auf, die eine Zahlung anlegt. Die Funktion legt die Zahlung an, doch die Antwort geht im Netzwerk verloren. Nach abgelaufener Zeitgrenze wiederholt der Schadendienst den Aufruf, und die Funktion legt die Zahlung ein zweites Mal an. Der Kunde erhält zweimal Geld. Erkennbar ist das an zwei gleichen Zahlungen für denselben Fall kurz nacheinander.
- Unabgestimmte Schnittstelle: Das Team des Leistungsdienstes ändert die Eingaben von
berechneLeistungund erzeugt das Gegenstück neu. Das Team des Schadendienstes erzeugt den Stellvertreter nicht neu. Der Stellvertreter verpackt die Angaben deshalb weiter in der alten Form, und das Gegenstück liest sie in der neuen Form. Die Aufrufe scheitern oder liefern falsche Beträge. Erkennbar ist das an Fehlern beim Umwandeln der Nachrichten unmittelbar nach einer neuen Version eines der beiden Dienste. - Zu viele kleine Aufrufe: Weil der Aufruf wie ein lokaler aussieht, ruft der Schadendienst für jeden Rechenschritt eine eigene entfernte Funktion auf. Jeder Aufruf wartet auf den Weg durch das Netzwerk hin und zurück. Braucht ein Fall 20 solche Aufrufe und dauert jeder Weg hin und zurück 50 Millisekunden, wartet der Schadendienst allein auf das Netzwerk eine Sekunde. Erkennbar ist das an langen Bearbeitungszeiten, obwohl jeder einzelne Aufruf schnell ist.
Weiterführend
Verwandte Ansätze
- Timeout: legt fest, wie lange der Schadendienst höchstens auf die Antwort von
berechneLeistungwartet. - Idempotency: sorgt dafür, dass ein wiederholter Aufruf nichts zusätzlich bewirkt. Bei Aufrufen, die etwas verändern, ist das die Voraussetzung für gefahrlose Wiederholungen nach einer abgelaufenen Zeitgrenze.
- Synchronous versus Asynchronous Communication: stellt den wartenden Aufruf, wie ihn RPC üblicherweise nutzt, dem Austausch über Nachrichten gegenüber, bei dem der Aufrufer weiterarbeitet.
- Request Reply: beschreibt Anfrage und Antwort über Nachrichten mit eindeutiger Kennung und vereinbartem Antwortkanal statt über einen Funktionsaufruf.
Quellen
- R. Thurlow: RFC 5531, RPC: Remote Procedure Call Protocol Specification Version 2: Spezifikation eines verbreiteten RPC-Protokolls; sie stellt fest, dass eine fehlende Antwort nicht bedeutet, dass die Funktion nicht ausgeführt wurde, und dass Zeitgrenzen und Wiederholungen Sache der Anwendung sind.
- gRPC Authors: Introduction to gRPC: Dokumentation eines verbreiteten RPC-Werkzeugs; sie zeigt, wie aus einer vereinbarten Schnittstelle Stellvertreter und Server-Code erzeugt werden und der entfernte Aufruf wie ein lokaler aussieht.
- gRPC Authors: Deadlines: erklärt, dass ein Aufruf ohne gesetzte Zeitgrenze unbegrenzt warten kann, und empfiehlt, für jeden Aufruf eine Zeitgrenze festzulegen.