
Pipes and Filters
Verarbeitung als Kette einzelner Schritte
Die Idee und ihr Nutzen
Bei einer Versicherung gehen täglich Tausende eingescannte Schadenbelege ein, etwa Rechnungen einer Autowerkstatt. Jeder Beleg muss nacheinander gelesen, geprüft, um die Vertragsdaten des Kunden ergänzt und abgelegt werden. Für jeden dieser Schritte übernimmt ein eigenes kleines Programm genau diese eine Aufgabe. Jedes dieser Programme gibt sein Ergebnis an das nächste weiter, ohne zu wissen, was danach mit dem Beleg geschieht. Dadurch kann das Team, das die Programme betreibt, das Programm eines langsamen Schritts, etwa das Lesen des Belegs, mehrfach gleichzeitig laufen lassen oder ein Programm später durch ein neues ersetzen. Diese Bauweise heißt Pipes and Filters, auf Deutsch Rohre und Filter. Mit den Filtern sind die kleinen Programme gemeint, mit den Rohren die Verbindungen, über die ein Programm sein Ergebnis an das nächste weitergibt.

Wie funktioniert es?
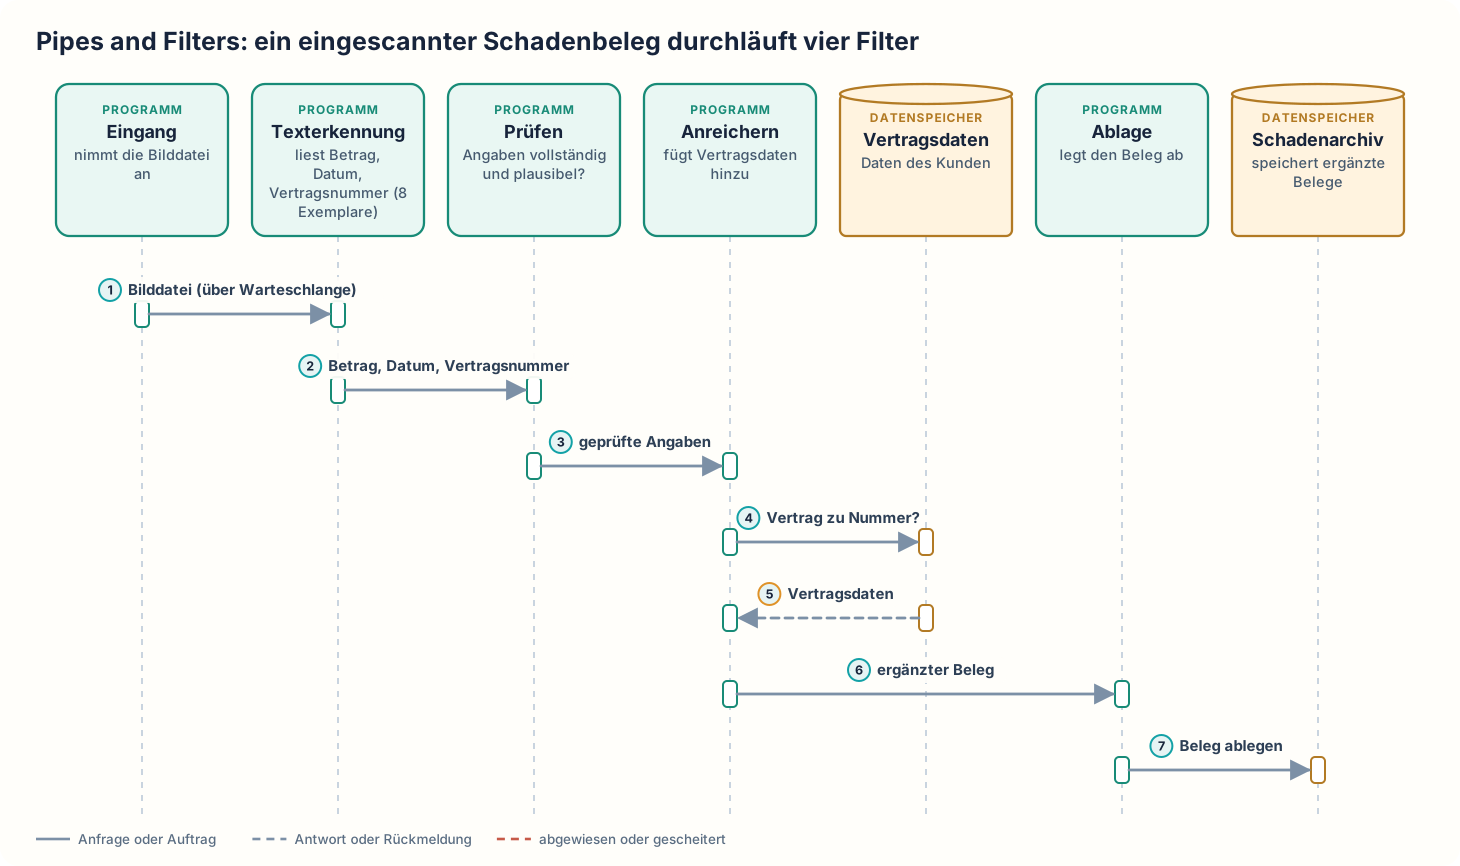
Das erste Programm der Kette heißt „Eingang“. Der „Eingang“ nimmt den eingescannten Beleg als Bilddatei an und reicht ihn über eine Warteschlange an das Programm Texterkennung weiter. Eine Warteschlange ist ein Zwischenspeicher, in dem Aufträge der Reihe nach warten, bis das nächste Programm sie abholt. Die Texterkennung liest aus dem Bild Rechnungsbetrag, Datum und Vertragsnummer und gibt diese Angaben an das Programm „Prüfen“ weiter. Die Texterkennung braucht dafür etwa 800 Millisekunden je Beleg, die übrigen Programme nur wenige Millisekunden. Deshalb lässt das Team acht Exemplare desselben Programms Texterkennung gleichzeitig laufen. Alle acht holen sich die Belege aus derselben Warteschlange, und die Warteschlange gibt jeden Beleg nur einem Exemplar. Acht Exemplare schaffen zusammen etwa zehn Belege pro Sekunde, und mehr Belege werden auch zu Spitzenzeiten nicht eingescannt. Von den anderen Programmen genügt zunächst je ein Exemplar. „Prüfen“ kontrolliert, ob die Angaben vollständig und plausibel sind, zum Beispiel ob die Vertragsnummer das richtige Format hat. Danach gibt „Prüfen“ die geprüften Angaben an das Programm „Anreichern“ weiter. „Anreichern“ fragt beim System „Vertragsdaten“ nach dem Vertrag zur Vertragsnummer. Das System „Vertragsdaten“ enthält die Daten der Kunden und liefert den Vertrag zurück. „Anreichern“ fügt die Vertragsdaten dem Beleg hinzu. Danach geht der ergänzte Beleg an das Programm „Ablage“, das ihn im Schadenarchiv ablegt.
Jedes dieser Programme ist ein Filter, also ein Programm für genau einen Verarbeitungsschritt, das Daten entgegennimmt, verarbeitet und das Ergebnis weitergibt. Das Wort „Filter“ bedeutet hier also nicht nur aussortieren, sondern jede Art von Verarbeitung. Ein Filter kennt nur die Daten, die er erhält und weitergibt, und weder den Filter vor ihm noch den Filter nach ihm. Die Verbindung zwischen zwei Filtern, über die das Ergebnis weiterfließt, heißt Pipe. Eine Pipe kann ein Datenstrom im Arbeitsspeicher sein, eine Datei oder eine Warteschlange wie die, aus der die Texterkennung die Belege holt. Weil die Filter einander nicht kennen, kann das Team Filter umstellen, austauschen, einfügen oder weglassen, ohne die anderen Filter zu ändern. Voraussetzung ist, dass das Datenformat zwischen den Filtern gleich bleibt. Soll künftig auch die Bankverbindung auf der Rechnung geprüft werden, fügt das Team einen weiteren Filter ein. Der neue Filter erhält den ergänzten Beleg von „Anreichern“, prüft die Bankverbindung und gibt den Beleg im vereinbarten Datenformat an „Ablage“ weiter. Ein bekanntes Beispiel für diese Bauweise ist die Befehlszeile der Betriebssysteme Unix und Linux. Dort werden kleine Programme mit dem Zeichen | hintereinandergeschaltet, und die Ausgabe des einen Programms wird zur Eingabe des nächsten.
Ein Filter kann an einem Beleg scheitern. Ein Beispiel ist ein unscharfes Bild, auf dem die Texterkennung nichts lesen kann. Was dann mit dem Beleg geschieht, schreibt Pipes and Filters nicht vor; das muss das Team festlegen. Üblich ist ein eigener Ordner für fehlerhafte Belege, den ein Mensch prüft. Der Filter legt den Beleg dann dort ab, statt ihn weiterzureichen. Ein Filter kann sein Ergebnis weitergeben und abstürzen, bevor er der Warteschlange den Auftrag als erledigt gemeldet hat. Die Warteschlange gibt den Beleg dann noch einmal aus, und derselbe Beleg wird ein zweites Mal verarbeitet. „Ablage“ muss deshalb erkennen, wenn ein Beleg schon im Schadenarchiv liegt.
Pipes and Filters: ein eingescannter Schadenbeleg durchläuft vier Filter
Wann ist es sinnvoll und wann nicht?
Pipes and Filters lohnt sich
- Eine Verarbeitung lässt sich in aufeinanderfolgende Schritte zerlegen, und jeder Datensatz lässt sich für sich verarbeiten, ohne auf andere zu warten. Beispiele sind Datenimporte, Dokumentenverarbeitung und die Auswertung von Protokolldateien. In einem einzigen großen Programm ruft jeder Schritt den nächsten selbst auf, und eine Änderung an einem Schritt kann die anderen Schritte treffen. Mit Pipes and Filters wird jeder Schritt ein eigenes Programm, das nur seine Eingabe und seine Ausgabe kennt.
- Die Schritte brauchen unterschiedlich viel Zeit, und die Menge schwankt: Täglich kommen Tausende Belege an, an manchen Tagen deutlich mehr als an anderen. In einem einzigen großen Programm bremst der langsamste Schritt alle anderen. Um mehr Belege zu schaffen, müsste das Team das gesamte Programm mehrfach starten, obwohl nur die Texterkennung mehr Rechenleistung braucht. Mit Pipes and Filters bekommt nur die Texterkennung zusätzliche Exemplare.
- Jeder Schritt soll sich einzeln testen lassen. In einem einzigen großen Programm durchläuft jeder Test das ganze Programm. Mit getrennten Filtern lässt sich zum Beispiel „Prüfen“ mit vorbereiteten Angaben testen, ohne Bilddateien durch die Texterkennung zu schicken.
- Schritte sollen sich austauschen oder ergänzen lassen. In einem einzigen großen Programm erfordert jede Erweiterung einen Eingriff mitten in das Programm, bei dem leicht Fehler in anderen Schritten entstehen. Ein Beispiel ist die zusätzliche Prüfung der Bankverbindung. Mit getrennten Filtern kann auch eine neue Texterkennung, die zum Beispiel unscharfe Bilder lesen kann, die alte ersetzen, solange die neue Texterkennung dieselben Angaben im vereinbarten Datenformat ausgibt.
Pipes and Filters ist nicht das Richtige
- Der Ablauf hat viele Rückfragen und Verzweigungen. Ein Beispiel: „Prüfen“ müsste bei einem unklaren Betrag auf die Antwort eines Sachbearbeiters warten und den Beleg je nach Antwort an „Anreichern“ oder noch einmal an die Texterkennung geben. Ein Filter gibt sein Ergebnis aber nur an die nächste Pipe weiter und kennt die anderen Filter nicht. Dann steuert ein eigenes Programm, der Orchestrator, jeden Vorgang: Der Orchestrator ruft die Schritte auf, wartet auf ihre Antworten und bestimmt danach den nächsten Schritt. Diese Bauweise heißt Orchestration. Alle Rückfragen und Verzweigungen stehen dann im Orchestrator, und kein Schritt muss einen anderen Schritt kennen.
- Mehrere Schritte brauchen gemeinsame Daten, die sich nicht mit dem Beleg weiterreichen lassen. Ein Beispiel ist eine Liste aller bereits bezahlten Rechnungen, mit der „Prüfen“ und „Ablage“ doppelt eingereichte Rechnungen erkennen und die zu groß ist, um sie jedem Beleg mitzugeben. Dann fasst das Team diese Schritte in einem Programm zusammen, das die gemeinsamen Daten einmal hält und für alle diese Schritte verwendet. So muss kein Filter dieselben Daten bei einem anderen Programm erfragen, und alle Schritte arbeiten mit demselben Stand.
- Ein Kunde oder Sachbearbeiter wartet am Bildschirm auf das Ergebnis eines einzelnen Belegs. Dann führt ein einzelnes Programm alle Schritte für diesen Beleg direkt nacheinander aus. Der Beleg wartet dabei in keiner Warteschlange, bis ein Filter ihn abholt, und das Ergebnis steht bereit, sobald der letzte Schritt fertig ist. Bei Pipes and Filters verlängert dagegen jede Übergabe über eine Warteschlange die Wartezeit.
- Alle Schritte müssen in einer einzigen Datenbanktransaktion ablaufen, also gemeinsam gelingen oder gemeinsam scheitern. Dann führt ein einzelnes Programm alle Schritte innerhalb dieser Transaktion aus. Scheitert ein Schritt, nimmt die Datenbank auch die Änderungen der vorherigen Schritte zurück. Bei Pipes and Filters schließt dagegen jeder Filter seinen Schritt für sich ab.
- Die Mengen sind gering, und die Schritte brauchen etwa gleich viel Zeit. Kein Schritt braucht dann zusätzliche Exemplare wie die Texterkennung. Dann genügt ein einzelnes Programm, das alle Schritte nacheinander ausführt. Ein solches Programm braucht keine Warteschlangen, die betrieben und überwacht werden müssen.
- Die Belege werden ohnehin einmal täglich gesammelt verarbeitet, weil das Ergebnis erst am nächsten Morgen gebraucht wird. Dass Warteschlangen jeden Beleg sofort weiterreichen, nützt dann niemandem. Stattdessen verarbeitet ein Programm einmal täglich alle gesammelten Belege nacheinander. Diese Stapelverarbeitung großer Datenmengen heißt Batch Processing. Das Programm muss nur während dieses Laufs arbeiten, und keine Warteschlange muss rund um die Uhr betrieben und überwacht werden.
Nachteile und typische Fehler
Jede Pipe braucht Zeit für die Übergabe, und Warteschlangen müssen betrieben und überwacht werden. Alle Filter müssen dasselbe Datenformat verstehen. Eine Änderung am Format betrifft deshalb die ganze Kette. Benennt die Texterkennung zum Beispiel ein Feld um, muss das Team auch „Prüfen“ und jeden weiteren Filter anpassen, der dieses Feld liest. Den Ordner für fehlerhafte Belege muss das Team betreiben, und ein Mensch muss ihn regelmäßig prüfen. Bei vielen kleinen Filtern ist die Fehlersuche mühsam, weil ein einzelner Beleg durch viele Filter läuft und das Team herausfinden muss, in welchem Filter der Fehler entstand. Jeder Filter braucht deshalb eine Protokollierung, die den Beleg eindeutig benennt.
Typische Fehler und woran man sie erkennt:
- Geändertes Datenformat: Die Texterkennung gibt nach einer Änderung die Vertragsnummer unter dem Feldnamen „vertrag“ statt „vertragsnummer“ aus. „Prüfen“ findet das Feld nicht mehr und meldet jeden Beleg als unvollständig. Erkennbar ist das an Belegen, die nach der Änderung gehäuft im folgenden Filter scheitern.
- Verschwundene Belege: Für gescheiterte Belege ist nichts festgelegt. Die Texterkennung kann ein unscharfes Bild nicht lesen und verwirft den Beleg, oder sie gibt ihn an die Warteschlange zurück, holt ihn wieder ab und scheitert erneut. Im ersten Fall geht der Beleg verloren, im zweiten Fall belegt er immer wieder ein Exemplar der Texterkennung. Erkennbar ist das, wenn mehr Belege eingehen, als im Schadenarchiv und im Ordner für fehlerhafte Belege zusammen ankommen.
- Doppelt abgelegte Belege: Ein Exemplar der Texterkennung gibt die Angaben eines Belegs an „Prüfen“ weiter und stürzt ab, bevor es den Beleg der Warteschlange als erledigt gemeldet hat. Die Warteschlange gibt den Beleg einem anderen Exemplar, und der Beleg durchläuft die Kette ein zweites Mal. „Ablage“ prüft nicht, ob der Beleg schon im Schadenarchiv liegt, und legt ihn noch einmal ab. Erkennbar ist das an zwei gleichen Belegen im Schadenarchiv.
- Stau bei der Texterkennung: Das Team lässt nur vier Exemplare der Texterkennung laufen. Vier Exemplare schaffen zusammen etwa fünf Belege pro Sekunde. Werden zu Spitzenzeiten zehn Belege pro Sekunde eingescannt, kommen in der Warteschlange, aus der die Texterkennung die Belege holt, jede Sekunde fünf Belege hinzu. Erkennbar ist das an einer stetig wachsenden Zahl wartender Belege in dieser Warteschlange.
- Unauffindbare Fehlerquelle: Ein falsch ergänzter Beleg lässt sich keinem Filter zuordnen, weil die Filter den Beleg in ihren Protokollen nicht eindeutig benennen. Erkennbar ist das an Fehlersuchen, bei denen das Team Filter für Filter die Protokolle durchsuchen muss.
Weiterführend
Verwandte Ansätze
- Messaging: der Austausch von Nachrichten über Warteschlangen, die als Pipes zwischen Filtern dienen können.
- Stream Processing: fortlaufende Datenströme, die ohne Pause durch Verarbeitungsschritte laufen.
- Message Router und Message Translator: typische Filter in Nachrichtenketten. Der Message Router leitet Nachrichten weiter, der Message Translator übersetzt sie in ein anderes Format.
Werkzeuge und Umsetzungen
- Apache Camel: beschreibt Verarbeitungsketten aus vielen Schritten mit fertigen Bausteinen.
- Apache NiFi: Plattform, auf der Datenflüsse aus verbundenen Verarbeitungsschritten grafisch zusammengestellt werden.
- Apache Beam: beschreibt eine Verarbeitungskette einmal und führt sie auf verschiedenen Plattformen aus.
- Vector und Fluent Bit: verarbeiten Protokolldaten in Ketten aus Quellen, Umwandlungen und Zielen.
Quellen
- Microsoft: Pipes and Filters pattern: beschreibt das Muster mit unabhängig vervielfachbaren Filtern und nennt Wiederholungen nach Abstürzen, doppelte Nachrichten und Abläufe, die in einer Transaktion gelingen müssen, als Grenzen.
- Gregor Hohpe, Bobby Woolf: Pipes and Filters: beschreibt Filter mit je einer Eingabe und einer Ausgabe, die über Pipes verbunden sind und sich ohne Änderung neu zusammenstellen lassen.