
Polyglot Persistence
Für jede Aufgabe die passende Datenbankart
Die Idee und ihr Nutzen
Die Schadenanwendung einer Versicherung arbeitet mit drei sehr verschiedenen Arten von Daten: Verträgen, Schadenakten und Gutachten. Verträge haben einen festen Aufbau und strenge Regeln, etwa dass Vertragsbeginn und Beitrag immer angegeben sein müssen. Schadenakten sehen je nach Sparte unterschiedlich aus, denn eine Kfz-Akte hat andere Felder als eine Akte zu einem Wasserschaden. In den Texten der Gutachten suchen Sachbearbeiter nach Stichwörtern. Keine einzelne Datenbankart ist für alle drei Arten von Daten gleich gut geeignet. Die Schadenanwendung nutzt deshalb für jede Art von Daten eine passende Speicherart: eine relationale Datenbank mit festen Tabellen für Verträge, einen Dokumentenspeicher für unterschiedlich aufgebaute Schadenakten und einen Suchindex, also ein Wortverzeichnis, für die Textsuche in Gutachten. Diese Aufteilung heißt Polyglot Persistence, auf Deutsch etwa mehrsprachige Datenhaltung. Gemeint ist, dass eine einzige Anwendung mehrere Speicherarten nebeneinander nutzt, hier relationale Datenbank, Dokumentenspeicher und Suchindex.

Wie funktioniert es?
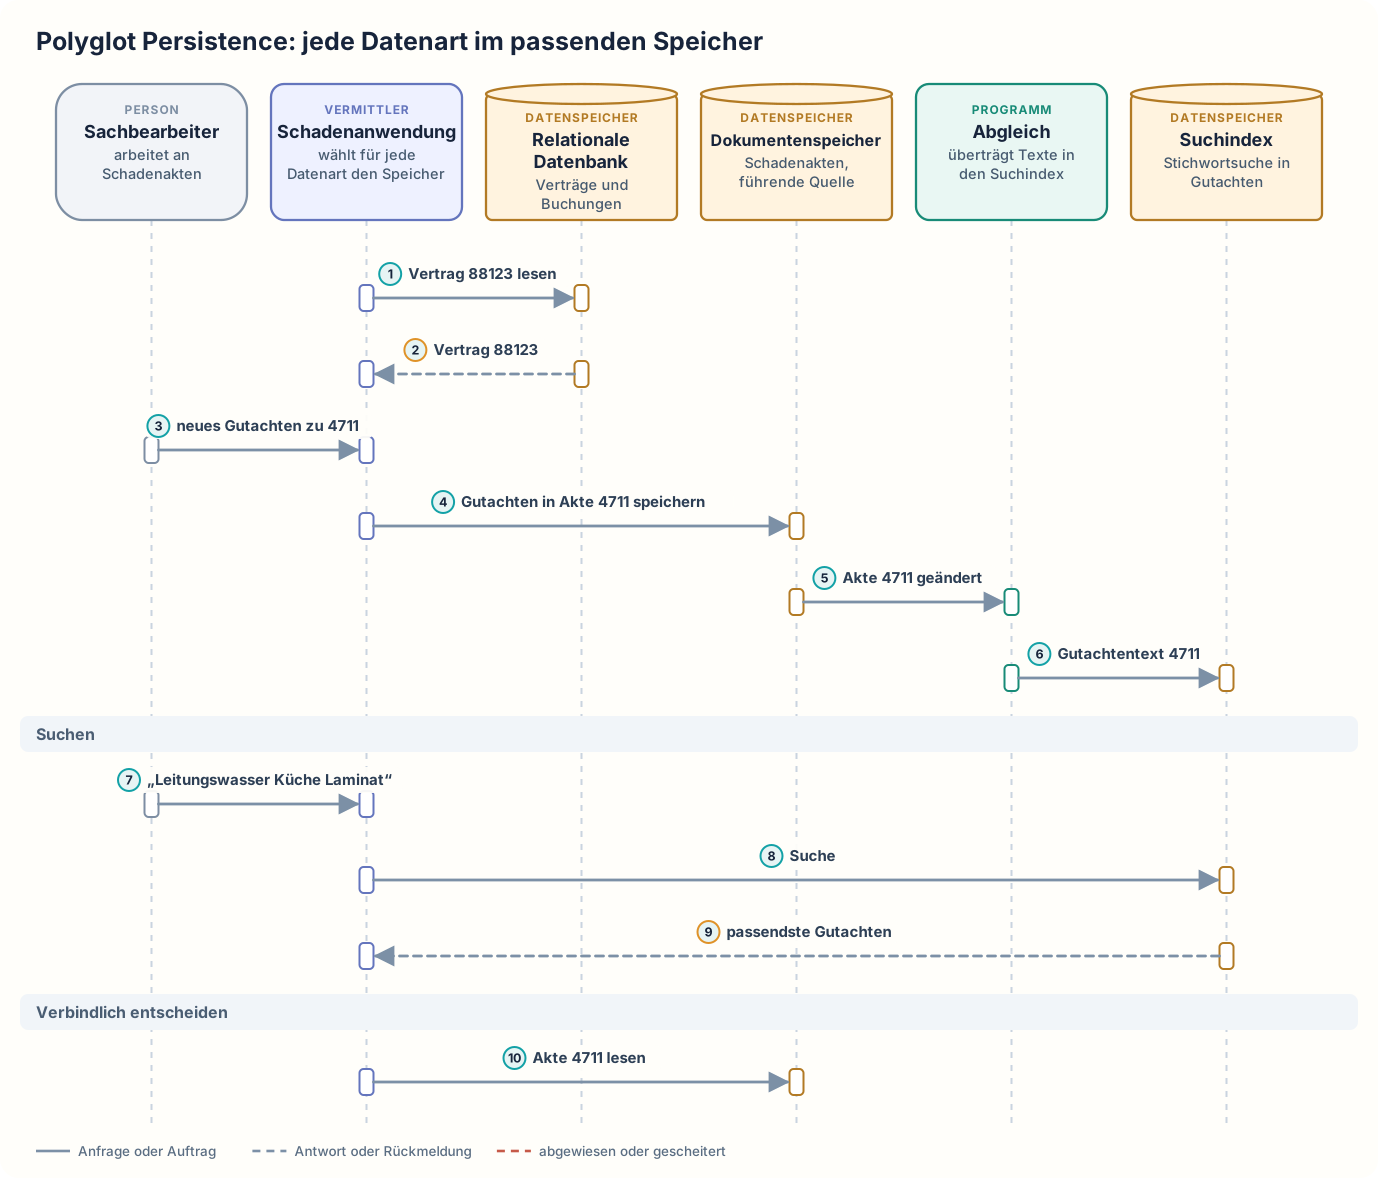
Die Schadenanwendung liest Vertrag 88123 aus der relationalen Datenbank, die den Vertrag mit festen Spalten liefert. Dann ergänzt ein Sachbearbeiter ein neues Gutachten zu Schaden 4711. Die Schadenanwendung speichert das Gutachten zuerst in Akte 4711 im Dokumentenspeicher. Der Dokumentenspeicher meldet die geänderte Akte an den „Abgleich“, ein Programm, das Texte in den Suchindex überträgt. Kurz danach überträgt der „Abgleich“ den Gutachtentext in den Suchindex. Bis dahin fehlt das neue Gutachten in der Suche. Sucht der Sachbearbeiter nach „Leitungswasser Küche Laminat“, fragt die Schadenanwendung den Suchindex und erhält in Sekundenbruchteilen die passendsten Gutachten zuerst. Vor einer verbindlichen Entscheidung über Schaden 4711 liest die Schadenanwendung die Akte aber aus dem Dokumentenspeicher und nicht aus dem Suchindex, weil der Suchindex noch einen älteren Stand haben kann als der Dokumentenspeicher.
Jede der drei Speicherarten ist für ihre Aufgabe gebaut. Eine relationale Datenbank speichert Daten in Tabellen mit festen Spalten und Regeln, etwa der Regel, dass jeder Vertrag einen Kunden hat. Außerdem unterstützt die relationale Datenbank Transaktionen: Mehrere zusammengehörende Änderungen gelingen gemeinsam oder scheitern gemeinsam. Deshalb liegen Verträge und Buchungen in der relationalen Datenbank. Ein Dokumentenspeicher speichert jeden Datensatz als in sich geschlossenes Dokument, dessen Felder von Dokument zu Dokument verschieden sein dürfen. Ein Dokument darf auch verschachtelte Angaben enthalten, etwa mehrere Gutachten mit jeweils mehreren Positionen. Deshalb liegen die Schadenakten im Dokumentenspeicher. Ein Suchindex verzeichnet für jedes Wort in den Texten, in welchen Dokumenten das Wort vorkommt, und sortiert die Treffer einer Suche danach, wie gut sie zu den Suchwörtern passen.
Für andere Aufgaben gibt es weitere Datenbankarten. Eine Graphdatenbank speichert Beziehungen zwischen Personen und Dingen, etwa wer mit wem an welchen Schäden beteiligt war, um Betrugsmuster zu erkennen. Ein Schlüssel-Wert-Speicher speichert zu einem Schlüssel einen einzelnen Wert und liefert ihn allein über diesen Schlüssel ohne weitere Abfrage, etwa für Anmeldesitzungen. Eine Zeitreihendatenbank speichert Messwerte mit Zeitstempel, etwa Sensordaten aus Fahrzeugen.
Der Text eines Gutachtens liegt im Dokumentenspeicher und im Suchindex. Das Team, das die Schadenanwendung entwickelt und betreibt, legt deshalb für jede Information fest, welcher Speicher den maßgeblichen Stand enthält. Dieser Speicher heißt führende Quelle. Für den Inhalt der Schadenakten ist das der Dokumentenspeicher. Andere Speicher halten von den Schadenakten nur abgeleitete Kopien, und der „Abgleich“ überträgt Änderungen von der führenden Quelle in diese Kopien. Bei der Schadenanwendung meldet der Dokumentenspeicher dem „Abgleich“ jede Änderung. In anderen Systemen liest ein Programm das Änderungsprotokoll der führenden Quelle mit, oder ein geplanter Import überträgt die Daten. Die Schadenanwendung ist ein einziges Programm, das alle drei Speicher nutzt. Das Team der Schadenanwendung ist auch für Datensicherung, Zugriffsschutz und Datenschutz aller drei Speicher verantwortlich.
Bleibt der „Abgleich“ stehen, fehlen neue Gutachten so lange in der Suche, bis der „Abgleich“ wieder läuft. Die Akte im Dokumentenspeicher ist davon nicht betroffen.
Polyglot Persistence: jede Datenart im passenden Speicher
Wann ist es sinnvoll und wann nicht?
Polyglot Persistence lohnt sich
- Die Daten dienen so verschiedenen Aufgaben, dass eine einzige Datenbankart mindestens eine davon nicht so erledigen kann, wie die Nutzer es brauchen. Ein Beispiel ist die Suche in Tausenden Gutachten. In einer relationalen Datenbank muss die Suche nach Wörtern in langen Texten ohne besondere Erweiterungen jeden Text ganz durchgehen und liefert keine sinnvolle Reihenfolge der Treffer. Mit dem Suchindex erhält der Sachbearbeiter in Sekundenbruchteilen die passendsten Gutachten zuerst.
- Es kommen immer wieder Sparten mit eigenen Feldern hinzu. In einer relationalen Datenbank muss jede neue Sparte als Änderung am Tabellenaufbau eingeplant werden. Im Dokumentenspeicher legt die Schadenanwendung eine Akte der neuen Sparte einfach mit ihren eigenen Feldern an.
- Die Daten unterscheiden sich nicht nur im Aufbau, sondern auch in ihrer Nutzung. Verträge und Buchungen werden nach festen Regeln geändert. Schadenakten wachsen im Lauf der Bearbeitung um Gutachten und Notizen. Gutachtentexte werden vor allem durchsucht. Mit einer einzigen Datenbankart müsste derselbe Speicher die strengen Regeln für Verträge, die wachsenden Akten und die Textsuche zugleich bedienen. Mit Polyglot Persistence liegt jede Art von Daten in dem Speicher, der für ihre Nutzung gebaut ist.
- Ein System besteht aus mehreren eigenständigen Programmen, die jeweils selbst wählen dürfen, in welcher Datenbankart sie ihre Daten speichern. Ohne Polyglot Persistence müssten alle Programme dieselbe Datenbankart verwenden, auch wenn sie für einige dieser Programme nicht passt.
Polyglot Persistence ist nicht das Richtige
- Eine relationale Datenbank mit Erweiterungen deckt alle Aufgaben ab. Viele relationale Datenbanken speichern mit Erweiterungen auch Dokumente mit unterschiedlichen Feldern und durchsuchen Texte nach Stichwörtern. Dokumentenspeicher und Suchindex könnten dann nichts, was diese Datenbank nicht schon kann. Dann legt das Team Verträge, Schadenakten und Gutachten in diese eine Datenbank. Das Team muss nur ein System betreiben und sichern, braucht keinen „Abgleich“, und eine Transaktion kann alle Daten umfassen.
- Das Team der Schadenanwendung ist klein und kann nicht mehrere verschiedene Datenbanken betreiben, regelmäßig sichern und vor unbefugtem Zugriff schützen. Dann legt das Team alle Daten in eine einzige relationale Datenbank mit den nötigen Erweiterungen. Die Suche in den Gutachten übernimmt dann die Textsuche dieser Datenbank. Das Team muss nur eine Datenbank betreiben, sichern und schützen statt drei.
Nachteile und typische Fehler
Jede Datenbankart braucht eigenes Fachwissen, eigenen Betrieb, eigene Datensicherung und eigene Schutzmaßnahmen gegen unbefugten Zugriff. Dieselben Daten liegen mehrfach vor. Den „Abgleich“ muss das Team der Schadenanwendung bauen, betreiben und überwachen, und bis der „Abgleich“ eine Änderung übertragen hat, zeigen Dokumentenspeicher und Suchindex unterschiedliche Stände. Transaktionen über mehrere Datenbanken hinweg sind nur mit bestimmten Kombinationen von Datenbanken möglich. Dann müssen alle beteiligten Datenbanken einer Änderung erst zustimmen, bevor sie die Änderung gemeinsam speichern. Pflichten aus dem Datenschutz, etwa das Löschen der Daten eines Kunden, müssen in allen Speichern erfüllt werden, auch in den Kopien.
Typische Fehler und woran man sie erkennt:
- Entscheidung aus der Kopie: Ein Sachbearbeiter ergänzt ein Gutachten zu Schaden 4711, und der „Abgleich“ hat den Text noch nicht in den Suchindex übertragen. Die Schadenanwendung liest vor der Entscheidung über Schaden 4711 aus dem Suchindex statt aus dem Dokumentenspeicher. Dort fehlt das neue Gutachten noch, und die Entscheidung berücksichtigt es nicht. Erkennbar ist das an Entscheidungen, die ein kurz zuvor gespeichertes Gutachten nicht berücksichtigen.
- Stehender „Abgleich“: Der „Abgleich“ bleibt unbemerkt stehen, und neue Gutachten erscheinen nicht mehr in der Suche. Erkennbar ist das an einer wachsenden Zahl von Gutachten, die im Dokumentenspeicher stehen, aber in der Suche nicht gefunden werden.
- Halbe Änderung: Die Schadenanwendung bucht eine Zahlung zu Schaden 4711 in der relationalen Datenbank und will die Zahlung danach in Akte 4711 im Dokumentenspeicher eintragen. Der Dokumentenspeicher ist in diesem Moment nicht erreichbar. Keine gemeinsame Transaktion umfasst beide Speicher, deshalb bleibt die Buchung bestehen, und in der Akte fehlt die Zahlung. Erkennbar ist das an Buchungen in der relationalen Datenbank, die in der zugehörigen Schadenakte im Dokumentenspeicher fehlen.
- Unvollständig gelöscht: Die Schadenanwendung löscht die Akten eines Kunden im Dokumentenspeicher. Der „Abgleich“ überträgt aber nur neue und geänderte Texte in den Suchindex und keine Löschungen, und die Gutachten des Kunden bleiben im Suchindex. Erkennbar ist das an Suchtreffern zu einem Kunden, dessen Akte im Dokumentenspeicher bereits gelöscht ist.
- Unklare führende Quelle: Die Schadenanwendung korrigiert einen Tippfehler in einem Gutachtentext direkt im Suchindex statt im Dokumentenspeicher. Im Dokumentenspeicher steht weiter der alte Text, und niemand weiß, welcher Stand gilt. Ändert ein Sachbearbeiter die Akte danach, überträgt der „Abgleich“ den alten Text aus dem Dokumentenspeicher in den Suchindex, und die Korrektur ist verloren. Erkennbar ist das an Abweichungen zwischen Suchindex und Dokumentenspeicher, die sich nicht durch eine noch nicht übertragene Änderung erklären lassen.
Weiterführend
Verwandte Ansätze
- CQRS: trennt das Schreiben vom Lesen. Die Daten zum Lesen liegen dabei oft in einer anderen Datenbankart als die Daten zum Schreiben.
- Change Data Capture: liest das Änderungsprotokoll der führenden Datenbank mit und hält so die anderen Speicher aktuell.
- Microservices: eine Bauweise aus vielen kleinen, eigenständigen Programmen, die jeweils eine passende Datenbankart wählen können, wenn ihre Aufgabe das rechtfertigt. Eine eigene Datenbankart je Programm ist dabei kein Zwang.
- Eventual Consistency: beschreibt, dass Kopien in mehreren Speichern zeitweise voneinander abweichen und sich erst angleichen, wenn der „Abgleich“ die Änderungen übertragen hat. Wie lange das dauert, ist damit nicht festgelegt.
Werkzeuge und Umsetzungen
Die folgenden Produkte sind Beispiele für einzelne Datenbankarten. Polyglot Persistence entsteht erst, wenn ein System mehrere davon gezielt für verschiedene Aufgaben kombiniert.
- PostgreSQL: relationale Datenbank, die mit ihren Erweiterungen auch Dokumente, Textsuche und Geodaten abdeckt.
- OpenSearch: Suchindex für Textsuche und Auswertungen.
- Neo4j Community Edition: Graphdatenbank für Abfragen über Beziehungen.
- Valkey: Schlüssel-Wert-Speicher, der die Daten im Arbeitsspeicher hält.
- Apache Cassandra: verteilte Datenbank für sehr große Datenmengen mit vielen Schreibvorgängen.
- TimescaleDB: Erweiterung für PostgreSQL für Zeitreihen.
Quellen
- Martin Fowler: Polyglot Persistence: Beitrag von 2011, der den Begriff bekannt machte, verschiedene Speichertechniken je nach Nutzung der Daten empfiehlt und als Nachteile das zusätzliche Fachwissen und die fehlenden gemeinsamen Transaktionen nennt.
- Microsoft: Understand data store models: beschreibt die üblichen Datenbankarten und ihre Stärken, wann sich das Kombinieren mehrerer Arten lohnt, und warnt davor, einen Suchindex zur führenden Quelle zu machen.