
Cell Based Architecture
Vollständige Kopien des Systems für Teilmengen der Kunden
Die Idee und ihr Nutzen
Das Kundenportal einer großen Versicherung bedient mehrere Millionen Kunden mit einer einzigen Installation, also mit Programmen und einer Datenbank, die alle Kunden gemeinsam nutzen. Ein einziger Fehler wie eine missglückte Änderung an der Datenbank trifft deshalb alle Kunden auf einmal. Das zuständige Team baut das Kundenportal stattdessen mehrfach vollständig auf, jeweils mit eigenen Exemplaren derselben Programme und eigener Datenbank, und teilt die Kunden auf diese Installationen auf. Ein vorgeschaltetes Programm schickt jeden Kunden anhand seiner Kundennummer zu seiner Installation. Fällt eine Installation aus, arbeiten die Kunden der übrigen Installationen weiter. Jede dieser vollständigen Installationen heißt Zelle, die Bauweise Cell Based Architecture.

Wie funktioniert es?
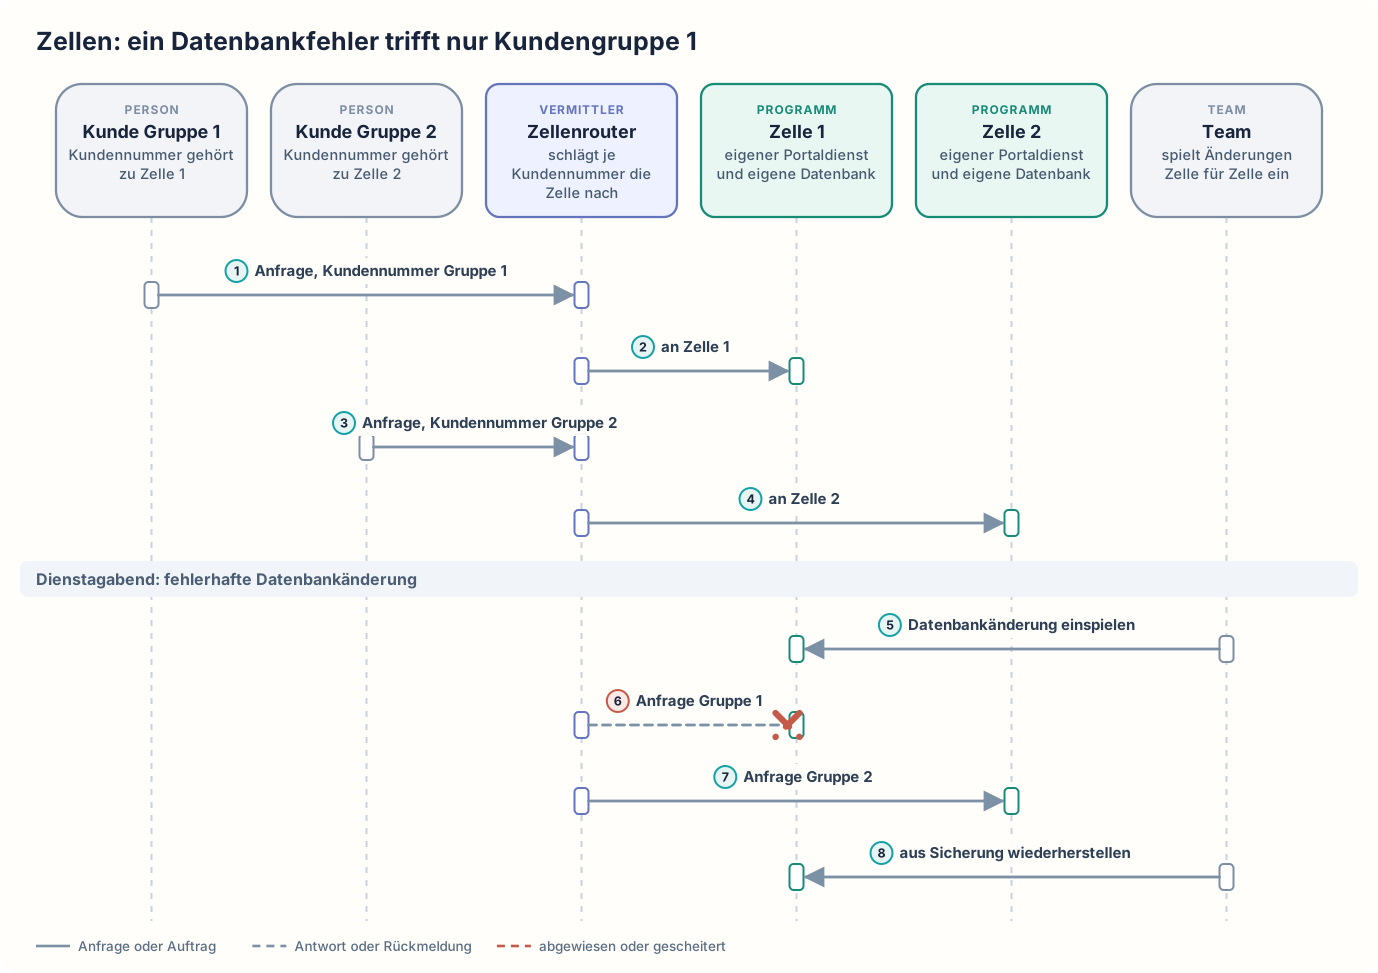
Das Kundenportal besteht aus zwei Zellen. Jede Zelle hat ihren eigenen Portaldienst, ein Exemplar derselben Programme des Kundenportals, und ihre eigene Datenbank mit den Akten ihrer Kunden. Weil jeder Kunde nur seine eigenen Akten braucht, bearbeitet jede Zelle die Anfragen ihrer Kunden allein. Jeder Kunde gehört zu einer Gruppe: Die Kundennummern der Gruppe 1 gehören zu Zelle 1, die Kundennummern der Gruppe 2 zu Zelle 2. Ein Kunde der Gruppe 1 ruft das Kundenportal auf. Seine Anfrage enthält die Kundennummer und erreicht zuerst den Zellenrouter, ein Programm, das alle Anfragen an das Kundenportal annimmt. Der Zellenrouter liest die Kundennummer, schlägt die zugehörige Zelle nach und leitet die Anfrage an Zelle 1. Zelle 1 bearbeitet die Anfrage vollständig mit ihrem eigenen Portaldienst und ihrer eigenen Datenbank und schickt die Antwort zurück. Die Anfrage eines Kunden der Gruppe 2 leitet der Zellenrouter an Zelle 2. Jede Anfrage geht an genau eine Zelle, und keine Zelle fragt die andere.
Am Dienstagabend spielt das Team eine fehlerhafte Datenbankänderung zuerst nur in Zelle 1 ein. Die Datenbank von Zelle 1 stürzt ab, und Kunden der Gruppe 1 sehen eine Störungsmeldung, weil ihre Akten nur in Zelle 1 liegen. Anfragen der Gruppe 2 gehen weiter an Zelle 2, deren Datenbank unverändert läuft, und die Kunden der Gruppe 2 bemerken nichts. Das Team stoppt die Auslieferung, bevor sie Zelle 2 erreicht, und stellt die Datenbank von Zelle 1 aus der Sicherung wieder her. Bis dahin müssen die Kunden der Gruppe 1 warten. Der Zellenrouter kann sie nicht an Zelle 2 schicken, denn in Zelle 2 liegen ihre Akten nicht. Die Zellen begrenzen also die Zahl der Betroffenen, verhindern aber nicht den Ausfall für die Betroffenen.
Neben Portaldienst und Datenbank hat jede Zelle auch eigene Warteschlangen für Nachrichten. Zellen nutzen möglichst keine gemeinsamen Programme, Datenbanken oder Warteschlangen, damit zum Beispiel ein Absturz der Datenbank von Zelle 1 die Kunden von Zelle 2 nicht trifft. Die einzigen gemeinsamen Teile sind der Zellenrouter und die Zuordnungstabelle, in der steht, welche Kundennummer zu welcher Zelle gehört. Der Zellenrouter bearbeitet selbst nichts Fachliches. Die Kundennummer ist eine stabile Kennung, also eine Angabe, die sich nie ändert und bei jeder Anfrage mitgeschickt wird. Neue Versionen spielt das Team ebenso wie Datenbankänderungen Zelle für Zelle ein. Kommen neue Kunden hinzu, baut das Team eine weitere Zelle auf und ordnet die neuen Kunden der neuen Zelle zu, statt bestehende Zellen zu vergrößern. So trifft ein Fehler in einer Zelle auch bei wachsendem Kundenbestand nicht mehr Kunden als bisher.
Zellen: ein Datenbankfehler trifft nur Kundengruppe 1
Wann ist es sinnvoll und wann nicht?
Eine Cell Based Architecture lohnt sich
- Das System ist sehr groß, und ein Ausfall für alle Kunden gleichzeitig ist nicht hinnehmbar. In einer einzigen Installation trifft auch eine fehlerhafte neue Version sofort alle Millionen Kunden. Je größer das System wird, desto mehr Kunden trifft jeder einzelne Fehler.
- Einzelne Kunden belasten das System stark. Ein Großkunde überlastet mit einem Massenimport die Datenbank. In einer einzigen Installation trifft das alle Kunden. Mit Zellen belastet er nur die Datenbank seiner eigenen Zelle.
- Neue Versionen und Datenbankänderungen sollen zuerst an einer abgegrenzten Gruppe von Kunden im Echtbetrieb erprobt werden. In einer einzigen Installation gibt es keine solche Gruppe, auf die ein Fehler beschränkt bliebe.
- Eine einzige Datenbank stößt an die Grenze dessen, was ein Rechner verarbeiten kann. Mit Zellen verarbeitet jede Datenbank nur die Akten der Kunden ihrer Zelle, bei zwei Zellen also etwa die Hälfte.
- Die Kunden lassen sich gut aufteilen, und ein Kunde braucht fast nie Daten eines anderen Kunden. Ein Kunde sieht seine Verträge und Schadenakten, nie die eines anderen. Nur dann bearbeitet jede Zelle die Anfragen ihrer Kunden allein, ohne eine andere Zelle zu fragen.
- Das Team kann Server, Datenbanken und Programmversionen automatisch aufbauen und ausliefern, statt jede Installation von Hand einzurichten. Eine weitere Zelle entsteht dann mit denselben Werkzeugen wie die erste.
Eine Cell Based Architecture ist nicht das Richtige
- Das Kundenportal einer kleinen Versicherung hat wenige Kunden, und eine einzige Datenbank verarbeitet alle ihre Akten. Ein Fehler trifft dann zwar alle Kunden, aber eben nur wenige. Dann betreibt das Team eine einzige Installation. Die Automatisierung und das Personal für den Betrieb mehrerer vollständiger Installationen entfallen.
- Die Versicherung braucht viele Auswertungen über den ganzen Bestand mit dem Stand von jetzt. Mit Zellen liegen die Akten verteilt in den Datenbanken aller Zellen, und jede Auswertung bräuchte ein zusätzliches System, das die Daten aus allen Zellen zusammenführt. Stattdessen behält das Team eine gemeinsame Datenbank, und jede Auswertung liest den ganzen Bestand direkt dort. Das zusätzliche System entfällt.
- Das Team baut seine Installationen noch von Hand auf. Dann bleibt das Team zunächst bei einer Installation und automatisiert deren Aufbau, bevor es Zellen einführt. Sonst müsste das Team jede Zelle von Hand aufbauen und jede Änderung in jeder Zelle von Hand wiederholen, bei zehn Zellen also zehnmal.
- Nur die Datenbank wird zu groß, der Portaldienst bearbeitet alle Anfragen ohne Engpass. Zellen würden dann auch den Portaldienst mehrfach aufbauen, obwohl nur die Akten aufgeteilt werden müssen. Stattdessen verteilt das Team mit Sharding die Akten nach der Kundennummer auf mehrere Datenbanken, und alle Kunden nutzen weiter denselben Portaldienst. Aufbau und Betrieb weiterer Exemplare des Portaldienstes entfallen. Ein Fehler im gemeinsamen Portaldienst trifft aber weiterhin alle Kunden.
- Der Portaldienst ruft einen Werkstattdienst und einen Zahlungsdienst auf. Antwortet der Werkstattdienst langsam, warten bald so viele Anfragen auf den Werkstattdienst, dass der Portaldienst seine Höchstzahl gleichzeitiger Anfragen erreicht und auch den Zahlungsdienst nicht mehr fragen kann. Zellen ändern daran nichts, denn der Portaldienst jeder Zelle ruft denselben Werkstattdienst auf. Stattdessen baut das Team einen Bulkhead in den Portaldienst ein: Der Portaldienst schickt nur eine festgelegte Zahl von Anfragen gleichzeitig an den Werkstattdienst, und die Anfragen an den Zahlungsdienst laufen weiter. Weitere Installationen entfallen.
- Das Team will nur verhindern, dass eine fehlerhafte neue Version des Portaldienstes alle Kunden trifft. Zellen würden dafür auch jede Datenbank mehrfach aufbauen, obwohl nur der Portaldienst in zwei Versionen laufen muss. Stattdessen gibt das Team neue Versionen mit einem Canary Release frei: Zuerst erhält nur ein kleiner Anteil der Kunden die neue Version. Dafür genügt eine Installation mit einer Datenbank. Eine fehlerhafte Datenbankänderung trifft dabei aber weiterhin alle Kunden, weil alle Kunden dieselbe Datenbank nutzen.
Nachteile und typische Fehler
Jede Zelle ist ein vollständiges System. Betriebsaufwand und Kosten für Server wachsen mit der Zahl der Zellen, und das Team muss Aufbau, Auslieferung und Überwachung weitgehend automatisieren. Auswertungen über alle Kunden brauchen ein zusätzliches System, das die Daten aus allen Zellen zusammenführt. Ein Beispiel ist ein nächtlich befülltes Auswertungssystem. Weil alle Zellen vom Zellenrouter und von der Zuordnungstabelle abhängen, betreibt das Team mehrere Exemplare desselben Zellenrouters, jedes mit einer Kopie derselben Zuordnungstabelle. Weil der Zellenrouter nur nachschlägt und nichts speichert, kann jedes Exemplar jede Anfrage weiterleiten. Jede zusätzliche Aufgabe im Zellenrouter kann alle Zellen lahmlegen. Prüfte der Zellenrouter zum Beispiel zusätzlich die Anmeldung, würde ein Fehler in dieser Prüfung die Kunden aller Zellen aussperren. Einen Kunden in eine andere Zelle umzuziehen ist aufwendig, weil alle seine Daten kopiert und die Zuordnung umgestellt werden müssen.
Typische Fehler und woran man sie erkennt:
- Ausfall des Zellenrouters: Der Zellenrouter läuft nur in einem Exemplar, und dieses Exemplar fällt aus. Alle Zellen sind dann unerreichbar, obwohl jede Zelle für sich läuft. Erkennbar ist das an Störungsmeldungen bei Kunden aller Gruppen zur selben Zeit.
- Auslieferung an alle Zellen gleichzeitig: Das Team spielt eine Änderung in alle Zellen auf einmal ein. Ein Fehler trifft dann wieder alle Kunden. Erkennbar ist das an Störungen, die in allen Zellen zur selben Zeit beginnen.
- Versteckte gemeinsame Abhängigkeit: Alle Zellen nutzen unbemerkt doch ein gemeinsames System, zum Beispiel einen Anmeldedienst oder eine gemeinsame Datenbanktabelle. Fällt dieses System aus, fallen alle Zellen aus. Erkennbar ist das, wenn eine einzelne Störung Kunden mehrerer Gruppen trifft.
- Zuordnung nach einer veränderlichen Angabe: Die Zuordnung richtet sich nach einer Angabe, die sich ändern kann, zum Beispiel nach dem Anfangsbuchstaben des Nachnamens. Kunden mit den Anfangsbuchstaben A bis M liegen in Zelle 1, Kunden mit N bis Z in Zelle 2. Eine Kundin heiratet und heißt statt Albers jetzt Weber. Ihre Anfragen tragen den neuen Namen, und der Zellenrouter schickt sie an Zelle 2, obwohl ihre Akten in Zelle 1 liegen. Erkennbar ist das an Kunden, die plötzlich eine leere Akte sehen.
- Verlorene Änderungen beim Umzug: Beim Umzug eines Kunden in eine andere Zelle wird die Zuordnung umgestellt, bevor alle Änderungen kopiert sind. Eine Schadenmeldung, die der Kunde kurz vorher abgeschickt hat, liegt dann nur in der alten Zelle. Der Zellenrouter schickt die Anfragen des Kunden aber schon an die neue Zelle. Erkennbar ist das an Schadenmeldungen, die ein Kunde kurz vor dem Umzug abgeschickt hat und die danach fehlen.
Weiterführend
Verwandte Ansätze
- Shared Nothing Architecture: der Grundsatz, dass Teile eines Systems weder Speicher noch Datenbank teilen. Zellen wenden diesen Grundsatz auf ganze Installationen an.
- Multi Tenancy: beschreibt, wie ein System mehrere Kunden oder Firmen, sogenannte Mandanten, bedient. Zellen sind eine Möglichkeit, Mandanten voneinander zu trennen.
Werkzeuge und Umsetzungen
Für Zellen gibt es kein fertiges Produkt. Zellen entstehen aus Werkzeugen, die Installationen automatisch aufbauen, und einem Programm, das als Zellenrouter arbeitet:
- Kubernetes: verbreitete Plattform zum Betrieb von Anwendungen auf vielen Servern. Jede Zelle läuft oft als eigener Verbund von Servern, ein Cluster, oder als abgetrennter Bereich in einem Cluster.
- Argo CD: liefert dieselbe Programmversion automatisch an viele Zellen aus und kann dabei Zelle für Zelle vorgehen.
- OpenTofu: beschreibt Server, Netze und Datenbanken einer Zelle in Textdateien und legt daraus beliebig viele gleichartige Zellen an.
- Envoy: ein Programm, das Anfragen stellvertretend annimmt und weiterleitet. Envoy kann als Zellenrouter Anfragen anhand einer Kundennummer an die zuständige Zelle schicken.
Quellen
- AWS: Reducing the Scope of Impact with Cell-Based Architecture: Leitfaden des AWS Well-Architected Framework, der Zellen als vollständige, voneinander unabhängige Installationen eines Systems beschreibt, mit Zuordnung über einen Schlüssel wie die Kundennummer, einem Zellenrouter, der möglichst wenig selbst erledigt, und Auslieferung Zelle für Zelle.
- AWS: REL10-BP03 Use bulkhead architectures to limit scope of impact: Empfehlung aus der Säule Zuverlässigkeit des AWS Well-Architected Framework, die Zellen, Zellenrouter und Zuordnungsschlüssel erklärt und davor warnt, Änderungen in alle Zellen gleichzeitig einzuspielen.