
Shared Nothing Architecture
Knoten teilen weder Speicher noch Daten
Die Idee und ihr Nutzen
Die Schadenplattform einer Versicherung läuft auf drei Rechnern, in der Fachsprache Knoten genannt. Die Schadenakten sind nach dem Anfangsbuchstaben des Kundennamens aufgeteilt: Knoten 1 hält die Akten von A bis H, Knoten 2 die von I bis P und Knoten 3 die von Q bis Z. Jeder Knoten hat seinen eigenen Arbeitsspeicher und seine eigene Festplatte. Auf allen drei Knoten läuft dasselbe Programm, und deshalb kann jeder Knoten die Anfragen zu seinen Akten vollständig selbst bearbeiten. Jede Anfrage geht zuerst an den Verteiler, ein Programm, das die Anfrage an den zuständigen Knoten weiterleitet. Kein Knoten greift bei einem Arbeitsschritt auf den Speicher eines anderen Knotens oder auf einen gemeinsamen Speicher zu. Deshalb warten die Knoten nicht aufeinander, und bei wachsender Last kann ein weiterer Knoten zum Beispiel einen Teil der Akten von I bis P übernehmen. Diese Bauweise heißt Shared Nothing, auf Deutsch „nichts geteilt“. Gemeint ist, dass sich die Knoten weder Arbeitsspeicher noch Festplatte noch Datenbank teilen.

Wie funktioniert es?
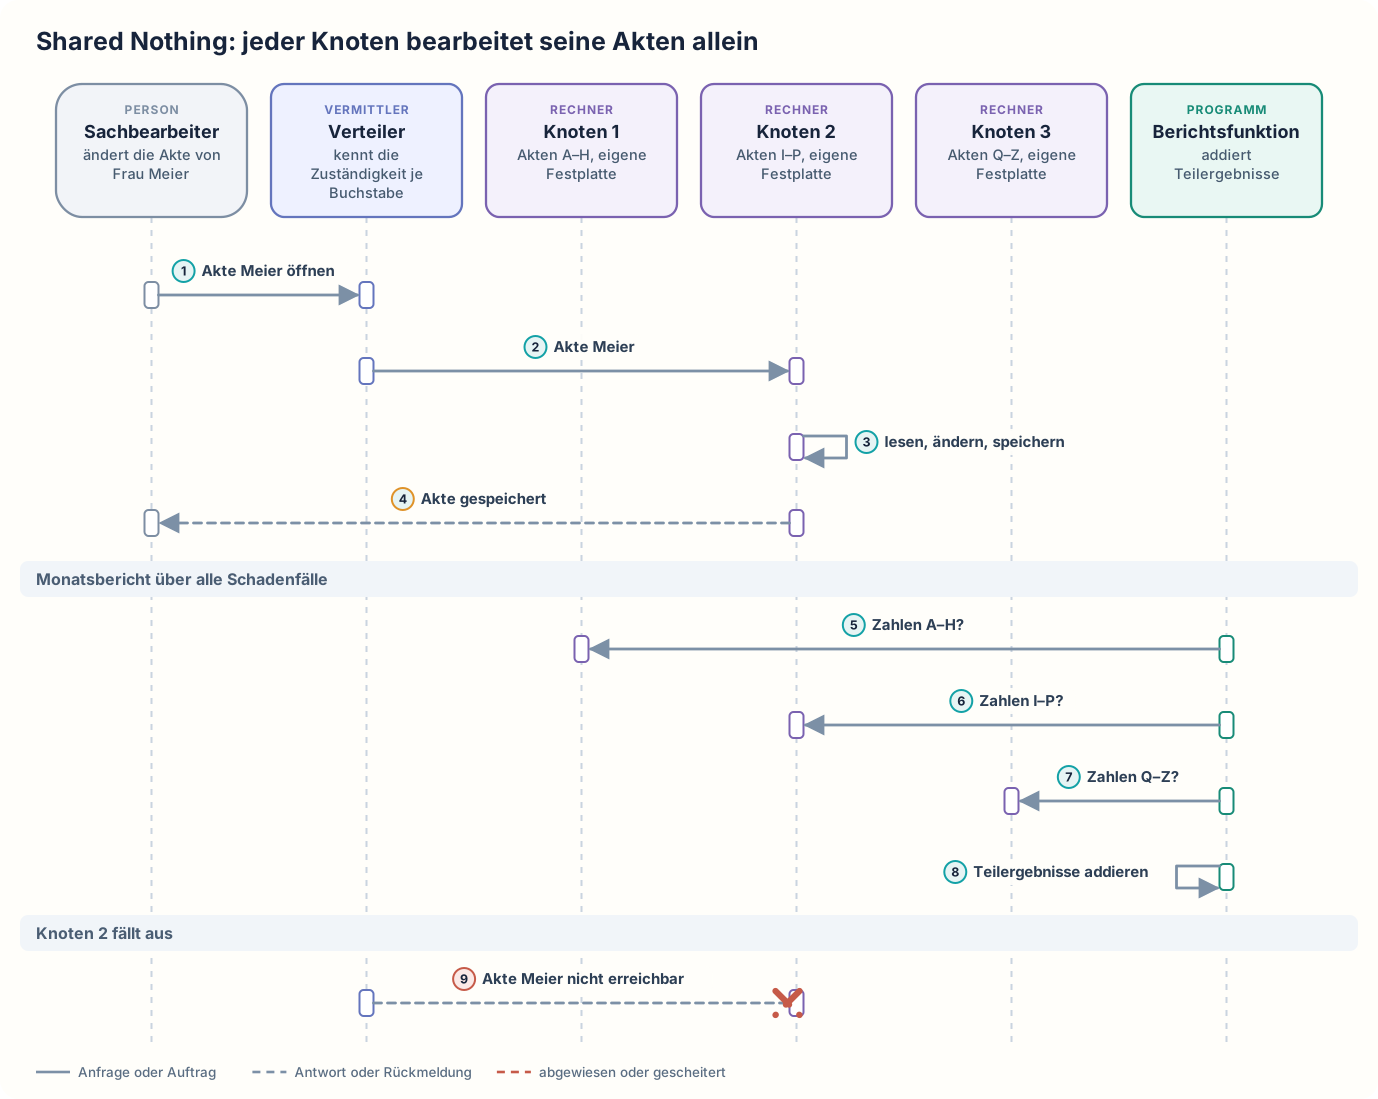
Ein Sachbearbeiter will die Akte von Frau Meier öffnen und ändern. Weil der Anfangsbuchstabe M im Bereich I bis P liegt, schickt der Verteiler die Anfrage an Knoten 2; die anderen Knoten sind nicht beteiligt. Knoten 2 liest die Akte von seiner eigenen Festplatte und speichert die Änderung des Sachbearbeiters wieder auf dieser Festplatte. Für die Änderung muss Knoten 2 keine Sperre anfordern. Eine Sperre ist eine Markierung, die anderen Knoten das gleichzeitige Ändern verbietet. Knoten 1 und Knoten 3 bearbeiten gleichzeitig Akten anderer Kunden, ohne auf Knoten 2 zu warten. Auswertungen über die Akten aller Knoten erstellt die Berichtsfunktion, ein eigener Programmteil. Für den Monatsbericht über alle Schadenfälle fragt die Berichtsfunktion Knoten 1 nach den Zahlen für A bis H, Knoten 2 nach I bis P und Knoten 3 nach Q bis Z. Jeder Knoten liefert nur die Zahlen für seine eigenen Akten, und die Berichtsfunktion addiert die Teilergebnisse.
Welche Akte zu welchem Knoten gehört, legt das Aufteilungsmerkmal fest, bei der Schadenplattform der Anfangsbuchstabe des Kundennamens. Das Team, das die Schadenplattform betreibt, teilt die Akten nach diesem Merkmal in Bereiche ein und ordnet jeden Bereich einem Knoten zu. Der Verteiler kennt diese Zuständigkeit, also welcher Knoten welchen Buchstabenbereich hält. Weil es keine gemeinsame Datenbank und keine gemeinsame Sperre gibt, bearbeitet ein zusätzlicher Knoten zusätzliche Anfragen, solange die Vorgänge nur seine eigenen Akten betreffen. Braucht ein Vorgang Daten aus mehreren Bereichen, schicken sich die Knoten Nachrichten oder liefern Teilergebnisse, die ein anderer Programmteil zusammenführt, beim Monatsbericht die Berichtsfunktion.
Fällt Knoten 2 aus und gibt es keine Kopie seiner Daten auf einem anderen Rechner, sind die Akten von I bis P nicht erreichbar, bis Knoten 2 wieder läuft oder seine Daten wiederhergestellt sind. Die Akten von A bis H und von Q bis Z bleiben in dieser Zeit nutzbar. Shared Nothing allein ist also kein Ausfallschutz. Damit die Akten eines ausgefallenen Knotens erreichbar bleiben, braucht jeder Knoten zusätzlich einen anderen Rechner mit einer Kopie seiner Daten, der seine Aufgabe übernehmen kann. Eine Sicherung erlaubt wenigstens, die Daten wiederherzustellen.
Shared Nothing: jeder Knoten bearbeitet seine Akten allein
Wann ist es sinnvoll und wann nicht?
Shared Nothing lohnt sich
- Die Last wächst über das hinaus, was Rechner mit einem gemeinsamen Speicher bewältigen. Nutzen alle Rechner dieselbe gemeinsame Datenbank oder müssen sie bei jeder Änderung dieselbe gemeinsame Sperre anfordern, warten sie ständig aufeinander. Je mehr Rechner hinzukommen, desto mehr Anfragen warten gleichzeitig auf die gemeinsame Datenbank oder die gemeinsame Sperre, und ein zusätzlicher Rechner bearbeitet kaum zusätzliche Anfragen.
- Arbeit und Daten lassen sich weitgehend nach einem Merkmal trennen, und die meisten Vorgänge betreffen nur einen Bereich. Solche Vorgänge betreffen etwa einen einzelnen Kunden oder einen einzelnen Schadenfall. Mit einer gemeinsamen Datenbank warten auch diese Vorgänge auf dieselbe Datenbank. Mit Shared Nothing braucht jeder dieser Vorgänge nur einen Knoten.
- Ein Ausfall soll nur einen Teil der Akten treffen und nicht die ganze Schadenplattform. Nutzen alle Rechner eine gemeinsame Datenbank, steht bei deren Ausfall die ganze Schadenplattform still. Fällt bei Shared Nothing Knoten 2 aus, bleiben die Akten von A bis H und von Q bis Z nutzbar.
Shared Nothing ist nicht das Richtige
- Viele Vorgänge müssen Daten aller Knoten gleichzeitig lesen oder ändern. Für jeden dieser Vorgänge schickt ein Knoten dann Nachrichten an die anderen Knoten und wartet auf deren Antworten. Das Team betreibt die Schadenplattform in diesem Fall mit einem einzelnen Datenbankrechner mit mehr Speicher und mehr Prozessoren; den Vergleich beschreibt Vertical versus Horizontal Scaling. Ein solcher Rechner braucht keinen Verteiler und keine Zusammenführung von Teilergebnissen, stößt aber an die Grenze dessen, was ein einzelner Rechner bewältigt, und fällt als Ganzes aus.
- Ein einzelner Rechner mit einer gemeinsamen Datenbank bewältigt die Last noch. Mehrere Knoten würden dann Arbeit aufteilen, die ein Rechner allein schafft. Dann betreibt das Team die Schadenplattform weiter auf diesem einen Rechner. Der Verteiler, das Zusammenführen von Teilergebnissen und der Betrieb mehrerer Knoten entfallen.
- Es wird überwiegend gelesen. Beim Lesen warten die Rechner nicht auf eine gemeinsame Sperre, deshalb genügt es, die Leseanfragen auf mehrere Kopien der Datenbank zu verteilen. Dann richtet das Team Read Replicas ein: Mehrere Kopien derselben Datenbank beantworten Leseanfragen, während Änderungen weiter nur in der ursprünglichen Datenbank gespeichert werden. Die Akten muss das Team dafür nicht nach einem Merkmal aufteilen.
Nachteile und typische Fehler
Abfragen über alle Knoten hinweg sind aufwendiger als in einer einzigen Datenbank, weil die Berichtsfunktion alle Knoten fragen und die Teilergebnisse zusammenführen muss. Eine Änderung, die Akten auf zwei Knoten zugleich betrifft, lässt sich nicht in einer einzigen Datenbanktransaktion speichern. Eine Datenbanktransaktion ist ein Schritt, der ganz oder gar nicht gespeichert wird. Eine solche Änderung braucht ein zusätzliches Abstimmungsverfahren, das erst bei beiden Knoten nachfragt, ob sie speichern können, und erst danach beiden den Befehl zum Speichern gibt. Wächst ein Bereich und muss neu aufgeteilt werden, ziehen Daten zwischen Knoten um. Während des Umzugs muss der Verteiler jede Anfrage an den Knoten schicken, auf dem die Akte gerade liegt. Das Aufteilungsmerkmal lässt sich im laufenden Betrieb nur ändern, indem fast alle Akten neu verteilt werden, und der Verteiler muss die aktuelle Zuständigkeit jedes Knotens kennen.
Typische Fehler und woran man sie erkennt:
- Ungünstiges Aufteilungsmerkmal: Anfangsbuchstaben von Kundennamen sind nicht gleich häufig. Viele Kunden tragen Namen wie Meier, Müller oder Neumann, und Knoten 2 hält deshalb zum Beispiel die Hälfte aller Akten. Der Verteiler schickt Knoten 2 dann doppelt so viele Anfragen wie jedem der beiden anderen Knoten. Erkennbar ist das an einem Knoten, der dauerhaft ausgelastet ist, während die anderen wenig zu tun haben.
- Fehlende Kopie: Für einen Knoten gibt es keine Kopie seiner Daten auf einem anderen Rechner, und nach seinem Ausfall fehlt sein ganzer Buchstabenbereich, bis der Knoten wieder läuft oder seine Daten wiederhergestellt sind. Erkennbar ist das an Sachbearbeitern, die nur für einen Buchstabenbereich keine Akten öffnen können.
- Zu viele übergreifende Vorgänge: Neue Funktionen lesen oder ändern immer öfter Akten auf mehreren Knoten. Für jeden dieser Vorgänge schickt ein Knoten Nachrichten an die anderen Knoten und wartet auf deren Antworten. Erkennbar ist das an steigender Netzlast zwischen den Knoten und daran, dass ein zusätzlicher Knoten kaum zusätzliche Anfragen bewältigt.
- Versteckter gemeinsamer Speicher: Alle Knoten schreiben doch in eine gemeinsame Tabelle, etwa für fortlaufende Schadennummern. Für jede neue Schadenakte holt sich ein Knoten die nächste Nummer aus dieser Tabelle. Die Tabelle lässt dabei immer nur einen Knoten zugleich zu, und die anderen Knoten warten. Erkennbar ist das an Wartezeiten auf diese eine Tabelle, die mit jedem neuen Knoten zunehmen.
- Ungeplanter Umzug: Das Team teilt den Bereich I bis P auf und gibt einen Teil davon einem neuen Knoten 4. Die neue Zuständigkeit trägt das Team im Verteiler ein, bevor die Akten von Knoten 2 auf Knoten 4 umgezogen sind. Der Verteiler schickt die Anfrage zur Akte von Frau Meier dann an Knoten 4, obwohl die Akte noch auf Knoten 2 liegt. Erkennbar ist das an Anfragen, die der Verteiler an einen Knoten schickt, auf dem die Akte noch nicht oder nicht mehr liegt.
Weiterführend
Verwandte Ansätze
- Sharding: teilt die Daten einer Datenbank nach einem Schlüssel auf mehrere Server auf. Das ist die verbreitetste Form, eine Datenhaltung nach Shared Nothing aufzubauen.
- Partitioning: beschreibt allgemein, wie Daten nach einem Merkmal wie Kundenname, Kundennummer oder Datum in Gruppen aufgeteilt werden.
- Consistent Hashing: verteilt Schlüssel so auf Knoten, dass beim Hinzufügen eines Knotens nur wenige Daten umziehen.
- Replication: hält Kopien der Daten eines Knotens auf anderen Rechnern, damit die Akten eines ausgefallenen Knotens erreichbar bleiben.
- Two Phase Commit: stimmt eine Änderung ab, die Daten auf mehreren Knoten zugleich betrifft. Je häufiger dieses Verfahren gebraucht wird, desto mehr warten die Knoten wieder aufeinander.
Quellen
- Michael Stonebraker: The Case for Shared Nothing: Aufsatz von 1986, der den Begriff prägt; jeder Prozessor hat eigenen Speicher und eigene Platten. Der Aufsatz vergleicht die Bauweise mit gemeinsam genutztem Speicher und nennt Lastausgleich und Aufteilung der Daten als Schwächen.
- Microsoft Azure Architecture Center: Data partitioning guidance: Leitfaden zur Wahl des Aufteilungsmerkmals, zum Aufwand übergreifender Abfragen, zum Umzug von Daten und dazu, dass ein Ausfall nur die Daten der betroffenen Gruppe trifft.